首页 文章 精选 留言 我的

精选列表

搜索[国产神器],共5643篇文章
优秀的个人博客,低调大师

deepin 大佬为爱发电「极简待办神器」,实力颜值双在线

你是否也曾被琐碎的任务淹没,忙到忘记自己做到哪一步?尝试过多种待办工具,却总被频繁的广告、联网、或是永中的功能一次次劝退? 正是洞察到这一痛点,deepin(深度)社区用户@Anthony Lu 开发了一款简洁、美观、本地化的待办管理工具——uyouToDo。不仅完全免费,还没有任何广告和冗余功能,只为还原一个清爽高效的任务管理体验。 关于uyou ToDo uyou ToDo 是一款基于 Electron 和 Vue.js 构建的本地开源待办事项管理工具。 它支持 Windows、macOS、Linux、Android 及浏览器扩展等多个平台,集任务创建、分类管理、进度跟踪、多设备同步等核心功能于一身,满足不同场景下的记录与管理需求。 极简视觉设计 高颜值设计:界面设计高度致敬经典的锤子便签风格,采用毛玻璃模糊效果,观感清新舒适; 双模式启航:首次使用时,可在「标准模式」和更具沉浸感的「便签纸模式」中自由选择; 极简主义:若觉得标准功能仍显复杂,只需在设置中一键开启 “简易模式” ,即可享受极致的轻量操作。 强大的任务管理 任务创建与分类:自由创建任务,并支持自定义分类(工作、学习、生活等); 优先级与提醒:可为重要任务设置高优先级和截止时间,临期自动提醒; 进度跟踪:实时更新任务进度,清晰掌握完成情况; 重复任务:支持为固定事项设置重复规则,如每周例会、每日打卡等。 多平台数据同步与本地备份 数据同步:登录同一账号,即可在电脑、手机、平板等多设备间实时同步任务数据; 本地备份:自 3.1.0 版本起,新增本地备份功能,可手动备份任务与分类数据,方便在不同设备间迁移,保障数据安全; 一键清理:支持一键删除所有已完成任务,助你快速清空已完成事项,保持界面持久清爽。 安装与获取 目前,uyouToDo已上架 deepin 应用商店,deepin 用户可直接从应用商店一键下载安装体验。 其他 Linux 发行版用户可从下方项目地址通过 .deb 安装包进行安装,欢迎大家使用与反馈。 项目地址:https://github.com/tonylu110/uyou-todo-electron 参与共建 uyouToDo 目前仍是一款“冷门但用心”的小众工具,我们由衷感谢 deepin 社区用户 @Anthony Lu 的卓越贡献与投递。deepin 的应用繁荣生态离不开每一位社区成员,无论您是应用的开发者还是愿意参与维护的热心用户,都欢迎通过「社区投递系统」加入我们,共同丰富 deepin 的应用生态。 社区投递系统使用说明 1、通过 deepin 官网进入社区应用投递系统,并登录 deepin(深度)社区账号。 2、点击右上角“上传应用”进行应用投递。 3、应用维护 成功投递应用后会进入审核流程,您可以在平台中查看审核进度,并对已投递的应用进行版本更新、信息维护等操作。

优秀的个人博客,低调大师

前端构建神器 Parcel 大「瘦身」:依赖项削减 25%,安装体积砍半!

在前端工具链百花齐放的今天,知名构建工具Parcel带来了令人振奋的2.15.0版本更新。最让开发者兴奋的是:通过将核心功能改用Rust重写,新版本在保持全部功能的同时,node_modules体积直接砍掉近一半,依赖包数量也减少了四分之一。这对于那些被庞大node_modules文件夹困扰的开发者来说无疑是一剂强心针。 拥抱「重型武器」,构建再也不担心翻车 本次更新最大的亮点是HTML处理链路的彻底重构。Parcel团队放弃了此前使用的PostHTML方案。PostHTML是什么?简单来说,它是一个用JavaScript编写的HTML处理工具,通过插件机制来完成HTML的解析和转换。虽然PostHTML生态丰富,有着大量现成的插件可用,但其解析能力始终无法企及浏览器级别。 为了彻底解决这个问题,Parcel团队转向了「重型武器」——直接搬来了Firefox浏览器和Servo渲染引擎中的核心组件,用Rust语言重新打造了HTML处理模块。这就好比之前用的是「民用工具」,现在换成了「工业级设备」,解析准确性得到了质的飞跃。 举个例子:HTML规范中关于解析的部分竟然有100多页之厚,里面包含了20多年来Web发展过程中积累的各种特殊情况。普通的解析器很难完美处理这些边界情况,但浏览器级的解析引擎在这方面已经过了无数实战检验。新版本采用Servo的html5ever解析器,意味着你的HTML文件将获得与Chrome、Firefox等主流浏览器完全一致的解析结果。 更保守但更聪明的压缩策略 在代码压缩方面,新版本的做法很有意思。与其他动辄追求极致压缩率的工具不同,Parcel选择了更明智的「保守压缩」策略。比如说,过去很多工具都会激进地删除HTML中的空白字符,但实际上这可能会破坏页面样式,因为CSS中的white-space: pre属性就需要保留这些空白。新版本在这类情况下会谨慎处理,宁可多留一些空白,也不破坏页面效果。 不过,在安全的优化场景下,新版本反而比之前更加智能。它能智能判断何时可以安全地移除属性引号、删除布尔属性的值,甚至利用HTML的容错机制移除一些可选的闭合标签。这些优化既保证了页面完整性,又能带来一定的体积收益。 SVG处理也来了次大换血 SVG处理模块同样迎来重大升级。新版本引入了名为OXVG的Rust工具替代了原有的SVGO。测试显示,这一替换带来了数倍的性能提升。同时,得益于与新HTML解析器的无缝配合,现在处理网页中的内嵌SVG图标也变得更加高效可靠。 对于经常和React打交道的开发者来说,还有一个好消息:新版本重写了SVG转JSX的功能,直接将SVG转换为JavaScript语法树,省去了中间环节,处理效率得到显著提升。 新版本值得升级吗? 答案是肯定的。如果你正在使用Parcel,升级到2.15.0版本将带来立竿见影的收益:更小的项目体积、更快的安装速度、更可靠的构建结果。而且,为了照顾现有项目,新版本保留了对PostHTML插件和SVGO配置的兼容支持,升级过程几乎不会带来任何副作用。 在当前前端工具链百家争鸣的背景下,Parcel用这次更新展示了一个颇具前瞻性的发展方向:用更可靠的系统级语言重写核心功能,同时保持与现有生态的友好共存。这种演进思路值得其他工具借鉴。

优秀的个人博客,低调大师

GaussDB(DWS)运维神器TopSQL来解决

本文分享自华为云社区《【云驻共创】GaussDB(DWS)运维利刃:TopSQL工具解析》,作者:金鱼哥。 在生产环境中,难免会面临查询语句出现异常中断、阻塞时间长等突发问题,如果没能及时记录信息,事后就需要投入更多的人力及时间成本进行问题的定位和解决,有时还无法定位到错误出现的地方。为了解决这种场景,GaussDB(DWS)提供了强大的运维工具TopSQL,对运行中和运行完成的语句全方面记录,帮助用户定位性能问题。而TopSQL被誉为性能定位、劣化分析等的重要基石,为用户提供覆盖内存、耗时、IO、网络、空间等多方面的信息记录。接下来将介绍TopSQL的基本原理、能力及典型应用场景,并讲解如何使用好TopSQL这把运维利刃。 一、TopSQL简介 1. 什么是TopSQL? TopSQL是GaussDB(DWS)数据库中内置的一款功能十分强大的性能分析工具。在实际生产环境中,难免会出现一些突发情况,导致查询语句出现异常中断、阻塞时间长等情况,如果当时没能记录下来,那么事后就要投入更多的人力以及时间成本去对错误进行定位和解决,有时还往往定位不到错误出现的地方。 为了解决这样的窘迫的情况,GaussDB(DWS)开发了TopSQL功能,对运行中的语句记录(实时TopSQL),对运行完成的语句进行记录(历史TopSQL)。 TopSQL作为GaussDB(DWS)的性能诊断工具,记录GaussDB(DWS)中各个作业、算子级别的资源使用数据、耗时数据,包括下盘信息、内存、网络、耗时、自诊断告警、基础信息等作业执行的数据。 2. 怎么实现TopSQL功能? 在GaussDB中,通过设定GUC参数,来开启TopSQL功能,由于小功能不同,那么相应的小功能的GUC参数也会有所区别。 大部分都是开关类型的,想要自定义场景就只需要关注传参类型的参数,以及参数之间的依赖关系即可。下一章节将介绍常用系统表和参数的设置介绍。 开启TopSQL功能必须要确保如下参数设置(下列参数为开启TopSQL功能的必要条件): user_workload_manager = on(默认为on) enable_resource_track = on(默认为on) resource_track_level = query / perf / operator(默认为query) 若是8.2.1.200版本,新增一个枚举参数为operator_realtime 二、TopSQL系统表和参数介绍 1. 公共GUC参数 以GaussDB(DWS) 8.1.3版本为例,推荐TopSQL相关的一些参数,如下表所示: 参数配置 解释及用法 enable_resource_track:on 资源监控总开关,开启后TopSQL才能发挥作用。 enable_resource_record:on 控制实时TopSQL是否做历史TopSQL转储,813版本推荐打开,方便对历史问题做定位分析。 resource_track_cost:0 执行代价超过预值,才会被记录,建议保持默认值0。 resource_track_duration:1 实时TopSQL是否转储到历史TopSQL,默认值为60秒,建议设置为1。 resource_track_level:query/perf 语句级TopSQL信息记录到历史TopSQL的系统表中。 TopSQL_retention_time:30 TopSQL老化时间为30秒,建议保持默认值。 enable_track_record_subsql:按需开启 控制子查询是否记录到TopSQL系统表中。 TopSQL系统表关键字段: 字段 字段说明 username 用户名 block_time 排队时间,辅助定位CCN场景 Start_time 语句执行的开始时间 duration 语句执行时长,重点关注 Estimate_memory 估算内存,复制定位ccn排队或内存问题 Max_peak_memory 实际最大使用内存,定位内存不足场景 Max_spill_size 下盘大小 Unique_sql_id 归一化ID,标志同一语句/同一语句不同入参 Cpu_skew_percent CPU倾斜情况 warning 自诊断信息 2. 实时TopSQL 系统提供了query级别和算子级别的资源监控实时视图来用于查询实时TopSQL。资源监控实时视图记录了查询作业运行时的资源使用情况(包括内存、下盘、CPU时间、IO等)以及性能告警信息。 实时视图具体的对外接口如下表所示: 视图级别 节点范围 查询视图 Query级别 当前CN gs_wlm_session_statistics 所有CN pgxc_wlm_session_statistics 算子级别 当前CN gs_wlm_operator_statistics 所有CN pgxc_wlm_operator_statistics 开启条件 必须要确保如下GUC参数设置: use_workload_manager为on(默认为on) enable_resource_track为on(默认为on) resource_track_level为query或operator(默认为query) 监控作业类型为: 优化器估算的执行代价大于或等于resource_track_cost的取值的作业。 增删改查,包括使用explain analyze和explain performance来执行的场景。query级别视图还额外支持create table as语法。 重分布过程中的作业不统计。 Cgroups功能正常加载,可通过gs_cgroup -P查看控制组信息。 use_workload_manager为系统级参数,用于是否开启资源管理功能。 enable_resource_track为系统级参数,用于设置是否开启资源监控功能。 resource_track_level为session级参数,可以对某个session的资源监控级别进行灵活设置。 这两个参数的设置方法如下表: enable_resource_track resource_track_level query级别信息 算子级别信息 on(default) none 不统计 不统计 on(default) query(default) 统计 不统计 on(default) operator 统计 统计 off none/query/operator 不统计 不统计 3. 历史TopSQL 系统提供了query级别和算子级别的资源监控历史视图用例查询历史TopSQL。资源监控历史视图记录了查询作业运行结束时的资源使用情况(包括内存、下盘、CPU时间、IO等)和运行状态信息(包括报错、终止、异常等)以及性能告警信息。但对于由于FATAL、PANIC错误导致查询异常结束时,状态信息列只显示aborted,无法记录详细异常信息。对于查询解析,优化阶段的状态信息则无法监控。 历史视图具体的对外接口如下表所示: 视图级别 节点范围 查询视图 Query级别 当前CN 历史(Database Manager接口) gs_wlm_session_history 历史(内部转储接口) gs_wlm_session_info 所有CN 历史(Database Manager接口) pgxc_wlm_session_history 历史(内部转储接口) pgxc_wlm_session_info 算子级别 当前CN 历史(Database Manager接口) gs_wlm_operator_history 历史(内部转储接口) gs_wlm_operator_info 所有CN 历史(Database Manager接口) pgxc_wlm_operator_history 历史(内部转储接口) pgxc_wlm_operator_info 开启条件 必须要确保如下GUC参数设置: use_workload_manager为on (默认为on) enable_resource_track为on (默认为on) resource_track_level为query或operator(默认为query) enable_resource_record为on(默认为off) resource_track_duration小于作业执行时间(默认为60s) 监控作业类型为: 资源监控实时视图中记录的作业结束时的执行时间大于或等于resource_track_duration的作业。 优化器估算的执行代价大于或等于resource_track_cost的取值的作业 Cgroups功能正常加载,可通过gs_cgroup -P查看控制组信息。 该功能会引起存储空间膨胀及轻微性能影响,不建议生成系统默认使用。 三、TopSQL典型应用场景 1. 实时TopSQL 问题场景:某集群业务反馈某业务SQL偶发执行慢,该集群resource_track_duration设置较大,历史TopSQL中没有记录计划详情,需要定位原因。 处理过程: ① 系统管理员根据queryid查看等待视图,等待视图部分结果如下: ② 管理员执行explain verbose,得到的执行计划如下 ③ 第8层非Stream算子,说明该计划不是正在执行语句的计划,使用实时TopSQL查看实际计划: 2. 历史TopSQL 问题场景:某客户由于内存规格较小,经常出现内存不可用的报错,云上运维人员通过autopilot定期巡检时发现该集群内存周期性冲高,且存在单实例内存使用倾斜的问题,需定位原因。 处理过程: ① 通过历史TopSQL找到内存占用高的语句 Select \* from pgxc_wlm_session_info where start_time > '2023-10-30 10:05' and start_time < '2023-10-30 10:10' order by max_peak_memory desc limit 100; ② 根据unique_sql_id确认作业的历史执行情况 3. 存储过程子语句 问题场景:某客户在业务中封装了大量的存储过程和匿名块脚本,用于业务系统的调度,随着业务数据越来越多,存储过程和匿名块脚本执行越来越慢,需要对其中的脚本进行优化。示例脚本如下: 处理过程: ① 查看历史TopSQL,存储过程和匿名块的query_plan字段显示NoPlan。 ② 设置enable_track_record_subsql: on,该参数打开后可以记录存储过程和匿名块中的自语句和执行计划。 ③ 重新执行慢的存储过程,根据query_id查看历史TopSQL中各个自语句的执行计划。 四、如何通过TopSQL进行信息统计 1. 常用TopSQL进行业务信息统计 ① 识别stream数量多的语句: select *,(length(query_plan) - length(replace(query_plan, 'Streaming', ''))) / length('Streaming') as stream_count FROM pgxc_wlm_session_info ORDER BY stream_count DESC limit 100; ② 识别内存占用高的语句: select * from pgxc_wlm_session_info where start_time > 'xxxx-xx-xx' and start_time < 'xxxx-xx-xx' order by max_peak_memory desc limit 100; ③ 识别需要优化的语句: select * from pgxc_wlm_session_info where start_time > 'xxxx-xx-xx' and start_time < 'xxxx-xx-xx' and warning is not null order by duration desc limit 100; 2. TopSQL使用注意事项 ① 查询时使用start_time做条件,避免全表查询。 ② 查询时使用limit对结果集大小限制,防止结果集过大导致客户端OOM。 总结 GaussDB 具备将瞬息万变的负载情况记录下来,提供回看数据库系统内部资源负载情况的能力,方便管理员对已经发生的问题做定位定界。 TopSQL收集的数据来源于数据库内部,为用户提供了实时监控数据库的能力。 TopSQL功能被用户广泛使用,是性能定位、劣化分析、审计回溯等重要的基石,为用户提供覆盖内存、耗时、IO、网络、空间等多方面的监控能力。在此基础上,内核也拓展出了异常规则等一些高阶用法,在日常使用中,用户可对TopSQL提出了更高的要求,比如记录子语句、记录语句类型、提升算子级别语句监控准确性等诸多建议。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

一款 StarRocks 可视化建表和数据编辑的神器

什么是 StarRocks? StarRocks 是新一代极速全场景 MPP (Massively Parallel Processing) 数据库。StarRocks 的愿景是能够让用户的数据分析变得更加简单和敏捷。用户无需经过复杂的预处理,就可以用 StarRocks 来支持多种数据分析场景的极速分析。 为了满足业务上的分析需求 StarRocks 设计了四种数据模型(明细模型、聚合模型、更新模型、主键模型),它们有各自的特点以适配不同的业务场景。本文将从创建数据模型表开始,配合简洁的案例,来讲解明细模型的用法和特点。 明细模型究竟是啥? 首先我们来看 StarRocks 官方的定义: 明细模型是默认的建表模型。如果在建表时未指定任何模型,默认创建的是明细类型的表。 创建表时,支持定义排序键。如果查询的过滤条件包含排序键,则 StarRocks 能够快速地过滤数据,提高查询效率。明细模型适用于日志数据分析等场景,支持追加新数据,不支持修改历史数据。 其次我们来看下 StarRocks 明细模型的标准建表语句与 MySQL 的差异: 可以看到除了 StarRocks 特有的关键字之外,两者语法大致是相同的。通过上述内容,我们可以总结以下关于 StarRocks 明细模型的信息: 如果在建表语句中不指定具体模型,也就是省略不写,默认就是 DUPLICATE KEY 明细模型,并且会自动选取前三列作为排序键 指定排序键的作用类似于 MySQL 给列设置普通索引,目的是为了提高查询效率 写入的数据无论是否完全一致,都会插入到数据库中而且不支持 Update 语法 以上信息就是明细模型的特点,我们从对比的角度讲,明细模型大致相当于: MySQL 具有普通索引的无主键表,并且不支持 Update 操作。 怎么建表? 使用 CloudDM,添加完 StarRocks 数据源之后,在表视图中右键方式开始新建表操作: 配置表名等基本信息 添加列信息,在结构设计器中选择列,然后点击增加按钮新建一个列,在右侧可以配置列的信息 设置表的数据模型,点击数据模型,点击添加类型选择“明细模型”,接着在下方选择排序键 配置排序键,在右方具体选择列,多个排序键列需要多次点击增加。 点击保存,生成建表语句,可选择立即执行或者复制SQL语句 怎么写数据? 右键点击新建表,并选择 编辑数据 准备三行数据,前两行数据完全相同,点击 "+" 符号,填写完成后点击提交,保存这三条数据 查看插入的数据,发现三条都已写入,验证明细模型的特点:写入的数据无论是否完全一致,都会插入到数据库中。如果选择的是 StarRocks 聚合模型,上面三条数据插入之后就会变为 2 条 验证是否支持 Update,双击 “SR_TEST” 库打开新的查询窗口,针对这个表尝试做一次 UPDATE 操作,结果执行报错: CloudDM 可视化数据编辑会直接禁用更改,和 StarRocks 数据库约束保持一致 总结 本文我们使用CloudDM 可视化的方式创建了StarRocks 明细模型表,并且同样可视化的方式对明细模型表进行了数据编辑操作。 以下是这款小工具的下载链接,感兴趣的小伙伴可以下载试用一下:https://www.clougence.com/clouddm-personal

优秀的个人博客,低调大师

这款开源测试神器,圆了我玩游戏不用动手的梦想

作者:HelloGitHub-Anthony 一天我在公司用手机看游戏直播,同事问我在玩什么游戏?我和他说在看直播,他恍然大悟:原来如此,我还纳闷你玩游戏,咋不用动手呢。。。。一语惊醒梦中人:玩游戏不用动手,怎样才能做到玩游戏不用手呢?我要去 GitHub 上找找~ 本期介绍的是 GitHub 上标星 5.4k 由网易开源和维护的开源项目:Airtest 一款基于 Python 的跨平台 UI 自动化测试框架,释放双手“玩”游戏、“耍”应用! > 项目地址:https://github.com/AirtestProject/Airtest 所谓 UI 自动化就是让游戏和应用,按照预先设定的步骤自己动。可用来实现自动测试应用,也可以用来实现应用自动化。。。就像升级版按键精灵? 一、应用场景 首先这个项目适合所有读者,只要跟着本教程仅需会一点 Python 语法,就可以学会用 Airtest 解决一些重复性的工作,释放你的双手!比如:检测僵尸好友、批量点赞、刷游戏副本、自动化测试等等。 如果测试同学上手了 Airtest 就会赞不绝口,毕竟测试界面的每个按钮是否有效是一个机械性的任务,不应该让机械的操作浪费宝贵的时间,有了它可以轻松搞定“点点点”的测试需求。 另外 Airtest 对于普通使用者能做到最有意思的事情就是做 游戏自动化。例如,在游戏中经常会有许多固定模式的日常任务,通过 Airtest 可以让这些枯燥的日常任务,自动执行从而节省时间。对于阴阳师等游戏配合游戏自带的自动战斗经过调试我们甚至可以做到全自动游玩,让玩家彻底解放双手! 看到这里是不是跃跃欲试了呢?下面就跟着小编一起上手 Airtest 吧~ 二、上手 安装: $ pip install -U airtest 对于新手来讲,我个人推荐使用官方推出可视化编辑器 AirtestIDE,使用起来非常方便,一键快速连接安卓、iOS 等设备,同时支持图像识别与 UI 元素识别。 > 下载地址:https://airtest.netease.com/ 后面的教程也是采用 AirtestIDE 讲解,手机为 Android 系统。 1. 打开手机开发者模式 打开手机的设置界面,找到 关于手机 界面: 连续点击 版本号 栏目直到提示开发者模式已经打开: 然后根据机型不同,找到开发人员选项中,打开开发人员选项 -> USB 调试 -> “仅充电”模式下允许ADB调试,关闭 监控 ADB 安装应用 之后将我们的手机使用数据线与电脑连接起来。 > 注意:为了防止发生安全问题,不连接 AirtestIDE 时请关闭 USB 调试功能! 2. 连接安卓手机 启动 AirtestIDE 后会提示需要登录,这里可以直接点击 Skip 跳过。然后我们就能看到主界面啦: 当手机连接到电脑后,点击设备连接窗口的刷新 ADB按钮后等待一会儿就能看见我们的手机: 点击 操作 栏的 connect 后即可连接手机。 > 第一次连接时在手机上会弹出认证提示,无特殊情况点击同意即可 之后就能看到我们手机画面: 同时鼠标可代替手指进行点击操作。 3. 实现自动访问 HG 官网 实现手机自动访问网站仅需要简单的 3 步: 1、在 Airtest 辅助窗 找到 touch 与 text: 2、点击 touch 后在手机画面选择浏览器图标截图,生成如下代码: 3、选择 text 输入:www.hellogithub.com 最后点击 运行 按钮即可。 > 注意,此部分由于需要安装 yosemite 调试工具可能需要先运行几次才可成功,而且图像识别有一定概率会失败 同样,IDE 也支持录制动作,点击 Airtest 辅助窗 里的录像按钮即可: 之后使用鼠标操作手机,IDE 就会自动为我们生成脚本了。 4. 生成报告(测试人员最爱) Airtest 可以非常方便的生成测试报告,只需要点击 IDE 上方的生成报告按钮: 即可自动生成全面的测试报告: 三、自动识别 在实际应用中,有些时候是图片识别无法完成或者存在困难的,这时我们可以利用 Poco 工具直接识别 UI 框架定位元素。 一个很简单的例子,自动打开 HG 的微信小程序并分享机器学习的内容: from airtest.core.api import * from poco.drivers.android.uiautomation import AndroidUiautomationPoco poco = AndroidUiautomationPoco() auto_setup(__file__) poco(text="HelloGitHub").click() poco(text="#机器学习").click() poco(text="tutorials").click() poco("android.widget.Button").click() 利用 IDE 的 Poco 录制功能可以很方便的自动生成上述代码,实际效果如下: 在应用当中巧妙地利用 Poco 可以节省很多图片识别时间以及应用背景不同时程序的稳定性。 四、结语 到这里 Airtest 的演示就结束啦!本文仅仅演示了 Airtest 最基本的功能。游戏自动化只是其中很小的一个功能,它主要还是用来做自动化测试。支持不同设备同时进行测试,但对于使用者而言有一定的上手门槛,感兴趣去的小伙伴可以去深入研究研究,但要注意方向呀~ > 《讲解开源项目》:https://github.com/HelloGitHub-Team/Article 最后,感谢您的阅读!这里是 HelloGitHub 分享 GitHub 上有趣、入门级的开源项目。您的每个点赞、留言、分享都是对我们最大的鼓励! 关注 HelloGitHub 公众号 第一时间收到更新。 还有更多开源项目的介绍和宝藏项目等待你的发现。

优秀的个人博客,低调大师

微软开发的神器,来感受一下神奇的代码之旅

【导语】:CodeTour(代码之旅)是微软官方开发的 VS Code 扩展,允许记录和回放代码的演练和思路。 简介 CodeTour 是一个 VS Code 插件,允许记录和回放代码库的演练和思路。我们通常都是通过代码注释或者文档来解释某段代码或方法的功能及逻辑,这样的方法相对简便,但是对阅读的人来说还不够友好,CodeTour 允许我们为代码添加备注,并且将这些备注串联起来,动态地展示我们的思路以及代码逻辑。 就像一个目录,可以轻松地加入到新的项目/功能,并且可视化错误报告或了解代码审查/PR 更改的上下文。"code tour"只是一系列交互步骤,每个步骤都与特定目录或文件/行进行关联,并包括对相应代码的描述。开发人员可以 clone 一个仓库,然后立即开始学习,而无需参考 CONTRIBUTING.md 文件或依赖他人的帮助。 此处为视频,戳链接:https://mp.weixin.qq.com/s/55snlZvRuxD4xS_KZPVZYA VSCode 地址: https://marketplace.visualstudio.com/items?itemName=vsls-contrib.codetour 项目地址: https://github.com/microsoft/codetour 入门 录制 单击树视图中的 + 按钮 CodeTour(如果它可见)或运行 CodeTour: Record Tour 命令。这将启动 CodeTour,这时候我们可以开始打开文件,单击要注释的行的“注释栏”,然后添加相应的描述。添加任意数量的步骤,完成后,单击停止。 录制时,CodeTour 树状视图将显示当前录制的预览,以及当前的一组步骤。可以知道当前正在进行哪个 tour 的录制。 此处为视频,戳链接:https://mp.weixin.qq.com/s/55snlZvRuxD4xS_KZPVZYA 如果需要在录制时编辑或删除步骤,单击 ... 步骤描述旁边的菜单,然后选择适当的操作,也可以从 CodeTour 树视图中查找编辑/删除步骤。 工作区 在录制时,系统会要求选择要将 tour 文件保存到的文件夹。这是必要的,因为 tour 作为文件写入工作区,需要明确 tour 应保存到哪个文件夹。 步骤标题 默认情况下,CodeTour 树使用以下显示名称格式显示每个游览步骤: # 步骤-文件名 #<stepNumber> - <filePath> 如果想给步骤一个更友好/更容易识别的名称,可以使用以下方法之一: 右键单击 CodeTour 树中的步骤并选择 Change Title 支持 Markdown 语法,可以使用任何标题级别。例如,如果添加一个描述以 ### Activation 开头的步骤,步骤和树视图将如下所示: 选择文本 默认情况下,每个步骤都与创建注释的代码行相关联,但是,如果想调出特定范围的代码作为步骤的一部分,只需在添加步骤之前突出显示代码(单击 Add Tour to Step 按钮),所选内容将作为步骤的一部分被捕获。 此处为视频,戳链接:https://mp.weixin.qq.com/s/55snlZvRuxD4xS_KZPVZYA 调整录制步骤 在录制时,添加的每个新步骤都将附加到录制的末尾,可以通过执行以下操作之一按顺序上下移动现有步骤: 将鼠标悬停在 CodeTour 树中的步骤上,然后单击向上/向下箭头图标 右键单击 CodeTour 树中的步骤并选择 Move Up 或 Move Down 菜单项 单击 ... 步骤注释 UI 中的菜单,然后选择 Move Up 或 Move Down 如果想在录制中间添加一个新步骤,只需导航到要在其后插入新步骤。 代码块 可以将 Markdown 代码块添加到步骤的正文内容,则 CodeTour 播放器将 Insert Code 在其下方呈现一个链接,该链接允许查看器自动将代码片段插入当前文件中与步骤关联的行,使得 CodeTour 创建交互式教程或示例变得容易。 此处为视频,戳链接:https://mp.weixin.qq.com/s/55snlZvRuxD4xS_KZPVZYA Shell 命令 为了更简单地将 shell 命令嵌入到一个步骤中(例如执行构建、运行测试、启动应用程序),CodeTour 支持一个特殊的 >> 符号,在后面紧跟想要运行的 shell 命令(例如 >> npm run compile)。这将被转换为一个超链接,当点击该链接时,将启动一个新的集成终端并运行指定的命令。 此处为视频,戳链接:https://mp.weixin.qq.com/s/55snlZvRuxD4xS_KZPVZYA 开启 Tour 要开始预览,只需打开包含一个或多个 tour 的代码库。通过以下任意一种方法都可以开始一个 tour: 在活动选项卡的 CodeTour 视图中选择 Explorer 运行CodeTour: Start Tour 命令,然后选择想启用的 tour 此处为视频,戳链接:https://mp.weixin.qq.com/s/55snlZvRuxD4xS_KZPVZYA 开源前哨 日常分享热门、有趣和实用的开源项目。参与维护 10万+ Star 的开源技术资源库,包括:Python、Java、C/C++、Go、JS、CSS、Node.js、PHP、.NET 等。

优秀的个人博客,低调大师

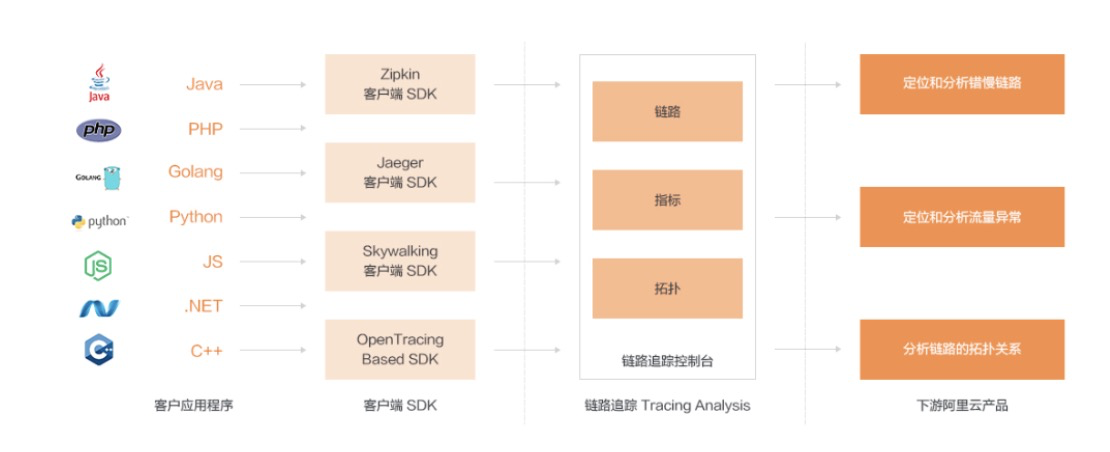
分布式诊断神器 | 阿里云链路追踪Tracing Analysis正式商用

6月12日,阿里链路追踪服务 Tracing Analysis 正式商用,提供分布式系统的全链路追踪能力,帮助客户快速发现和定位分布式系统下的各类性能瓶颈,降低了客户自建全链路系统的技术投入和风险,且云上的托管成本仅自建链路追踪系统的1/5甚至更少。 据链路追踪 Tracing Analysis 技术专家竹影介绍,微服务架构下的分布式应用架构虽然满足了应用横向扩展需求,但是如何进行分布式应用诊断成为挑战。虽然,业内有链路追踪相关的开源解决方案,但存在着研发投入较高、自建成本较高、技术风险较大、运维难度较大的挑战。 那么,链路追踪 Tracing Analysis 是如果提供分布式下的应用诊断服务,又有哪些特点呢? 产品架构 链路追踪的产品架构如下图所示。 主要工作流程为: 客户侧的应用程序通过集成链路追踪的多语言客户端 SDK 上报服务调用数

优秀的个人博客,低调大师

【资料下载】K8s监控神器——TSDB for Prometheus的入门与实践

议题介绍 Prometheus作为云原生监控的首选工具,其单机部署的架构设计在提供稳定性和易用性的同时,也使得数据存储受限于单节点的存储大小。阿里云TSDB针对这一痛点,为用户提供了易用性高,稳定性强,性价比优的存储技术方案。本次技术分享中,我们会展示如何配置阿里云TSDB作为Prometheus远程存储的流程,并量化展示本方案达到的查询吞吐高,延迟低,性能按需弹性扩展等优势。关注Prometheus的你,请千万不要错过本次技术分享。 讲师介绍 胡建洪(花名:莫趋),阿里云数据库产品事业部开发工程师 直播时间 4月25日 19:00 - 19:40(30分钟分享+10分钟答疑) 观看视频 直播地址:https://yq.aliyun.com/live/1053 PPT精彩一览 下载地址:https://yq.aliyun.com/download/

优秀的个人博客,低调大师

平价有机蔬菜亮相天猫双11,阿里云IoT成助攻神器

6块8一份的有机青菜、蒿子秆,8块8一份的胡萝卜,原来价格高昂的有机蔬菜,在盒马却卖出了平价。而让人更意想不到的是,这背后是阿里云IoT的科技暖男的守护,将农民在有机蔬菜种植的经验转化为云上的数据,从源头上降低了成本。 双11期间,盒马与阿里云IoT携手发布了IoT有机蔬菜安全溯源项目,借助物联网技术,对蔬菜的种植、加工、运输、卖场四个环节的供应链进行了全面升级,全链路数据监测,确保蔬菜的品质最优、运输最快、消耗最小。 种植环节,确保最佳环境成长。通过搭建LoRa物联网及传感器,24小时进行基地环境监测,随时同步蔬菜种植的温度、光照、紫外线、相对湿度、PM2.5、PH值等等13项数据,蔬菜基地的人亲切的称之为“智能稻草人”。 盒马上海生鲜采销总监陈华表示,兢兢业业的“智能稻草人”大幅降低了种植成本,这也是有机蔬菜走向平价的重要原因之一,

优秀的个人博客,低调大师

ECS运维神器重装上阵,云助手亮相控制台

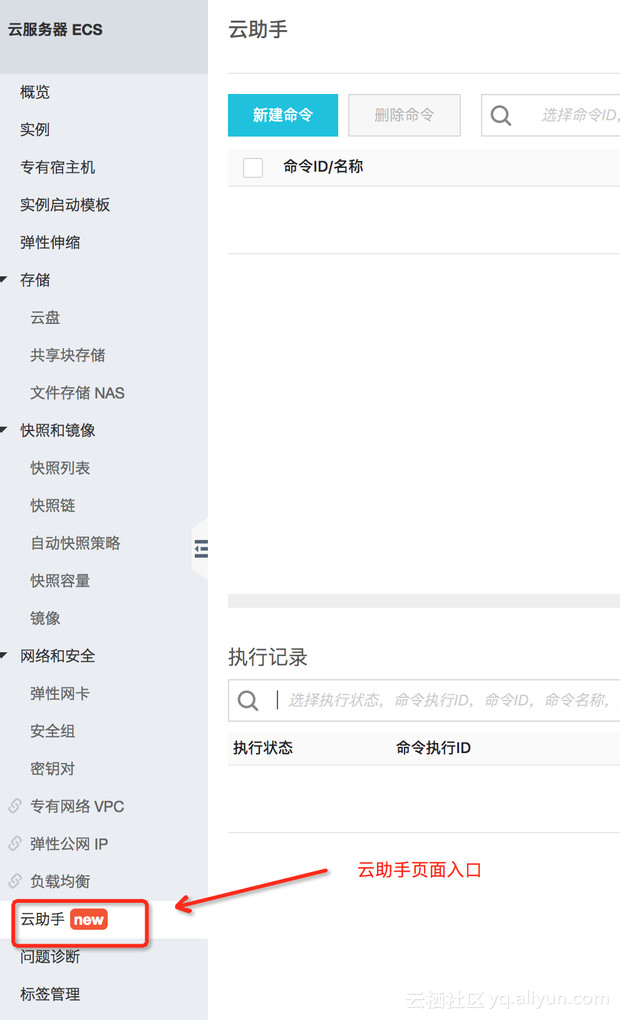
背景 在使用ecs实例的过程中,为了处理一些问题,您不得不通过用户名,密码来直接登录机器。在这种情况下,如果你有成百上千台实例,你就会很难受的一台台去看。这是运维人士的一大痛点,基于此我们开发了全新的运维利器---云助手。您可以写一段shell, powershell或者bat命令,通过我们的云助手发送到各个实例上去,来实现您的运维目的。前段时间,我们的云助手通过OpenAPI的形式已经发布。近来,我们根据广大用户的反馈,对其进行了优化,改进,增加了控制台的UI界面,使其变的更直观,更易用。 云助手 下面我们就来告诉大家如何从控制台使用云助手: 在我们的控制台入口,有一个新增的菜单入口---云助手 点开之后,我们可以看到云助手的全貌 新建命令 下面我们就来创建一条命令: 当您创建好一条命令之后,命令就会显示在列表里了。 执行命令 接下来,我们来执行一

优秀的个人博客,低调大师

Java7任务并行执行神器:Fork&Join框架

Fork/Join是什么? Fork/Join框架是Java7提供的并行执行任务框架,思想是将大任务分解成小任务,然后小任务又可以继续分解,然后每个小任务分别计算出结果再合并起来,最后将汇总的结果作为大任务结果。其思想和MapReduce的思想非常类似。对于任务的分割,要求各个子任务之间相互独立,能够并行独立地执行任务,互相之间不影响。 Fork/Join的运行流程图如下: image 我们可以通过Fork/Join单词字面上的意思去理解这个框架。Fork是叉子分叉的意思,即将大任务分解成并行的小任务,Join是连接结合的意思,即将所有并行的小任务的执行结果汇总起来。 image 工作窃取算法 ForkJoin采用了工作窃取(work-stealing)算法,若一个工作线程的任务队列为空没有任务执行时,便从其他工作线程中获取任务主动执行。为了实现工作窃取,在工作线程中维护了双端队列,窃取任务线程从队尾获取任务,被窃取任务线程从队头获取任务。这种机制充分利用线程进行并行计算,减少了线程竞争。但是当队列中只存在一个任务了时,两个线程去取反而会造成资源浪费。 工作窃取的运行流程图如下: image Fork/Join核心类 Fork/Join框架主要由子任务、任务调度两部分组成,类层次图如下。 image ForkJoinPool ForkJoinPool是ForkJoin框架中的任务调度器,和ThreadPoolExecutor一样实现了自己的线程池,提供了三种调度子任务的方法: execute:异步执行指定任务,无返回结果; invoke、invokeAll:异步执行指定任务,等待完成才返回结果; submit:异步执行指定任务,并立即返回一个Future对象; ForkJoinTask Fork/Join框架中的实际的执行任务类,有以下两种实现,一般继承这两种实现类即可。 RecursiveAction:用于无结果返回的子任务; RecursiveTask:用于有结果返回的子任务; Fork/Join框架实战 下面实现一个Fork/Join小例子,从1+2+...10亿,每个任务只能处理1000个数相加,超过1000个的自动分解成小任务并行处理;并展示了通过不使用Fork/Join和使用时的时间损耗对比。 import java.util.concurrent.ForkJoinPool; import java.util.concurrent.RecursiveTask; public class ForkJoinTask extends RecursiveTask<Long> { private static final long MAX = 1000000000L; private static final long THRESHOLD = 1000L; private long start; private long end; public ForkJoinTask(long start, long end) { this.start = start; this.end = end; } public static void main(String[] args) { test(); System.out.println("--------------------"); testForkJoin(); } private static void test() { System.out.println("test"); long start = System.currentTimeMillis(); Long sum = 0L; for (long i = 0L; i <= MAX; i++) { sum += i; } System.out.println(sum); System.out.println(System.currentTimeMillis() - start + "ms"); } private static void testForkJoin() { System.out.println("testForkJoin"); long start = System.currentTimeMillis(); ForkJoinPool forkJoinPool = new ForkJoinPool(); Long sum = forkJoinPool.invoke(new ForkJoinTask(1, MAX)); System.out.println(sum); System.out.println(System.currentTimeMillis() - start + "ms"); } @Override protected Long compute() { long sum = 0; if (end - start <= THRESHOLD) { for (long i = start; i <= end; i++) { sum += i; } return sum; } else { long mid = (start + end) / 2; ForkJoinTask task1 = new ForkJoinTask(start, mid); task1.fork(); ForkJoinTask task2 = new ForkJoinTask(mid + 1, end); task2.fork(); return task1.join() + task2.join(); } } } 这里需要计算结果,所以任务继承的是RecursiveTask类。ForkJoinTask需要实现compute方法,在这个方法里首先需要判断任务是否小于等于阈值1000,如果是就直接执行任务。否则分割成两个子任务,每个子任务在调用fork方法时,又会进入compute方法,看看当前子任务是否需要继续分割成孙任务,如果不需要继续分割,则执行当前子任务并返回结果。使用join方法会阻塞并等待子任务执行完并得到其结果。 程序输出: test 500000000500000000 4992ms -------------------- testForkJoin 500000000500000000 508ms 从结果看出,并行的时间损耗明显要少于串行的,这就是并行任务的好处。 尽管如此,在使用Fork/Join时也得注意,不要盲目使用。 如果任务拆解的很深,系统内的线程数量堆积,导致系统性能性能严重下降; 如果函数的调用栈很深,会导致栈内存溢出; 推荐阅读 干货:Spring Boot & Cloud 最强技术教程 工具:推荐一款在线创作流程图、思维导图软件 分享Java干货,高并发编程,热门技术教程,微服务及分布式技术,架构设计,区块链技术,人工智能,大数据,Java面试题,以及前沿热门资讯等。 image

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册