首页 文章 精选 留言 我的

精选列表

搜索[腾讯云双十一抄作业],共10000篇文章
优秀的个人博客,低调大师

JavaScript学习(十一)--数值处理对象

目录 Math对象 1.math对象的属性 2. Math对象的方法 Number对象 1.创建Number对象 2.Number对象的属性 (1)MAX_VALUE属性 (2)MIN_VALUE属性 (3)NEGATIVE_INFINITY属性 (4)POSITIVE_INFINITY属性 3.Number对象的方法 (1)toString()方法 (2)toFixed()方法 (3)toExponential()方法 (4)toPrecision()方法 Boolean对象 1.创建Boolean对象 2.Boolean对象的属性 (1)constructor属性 (2)prototype属性 3.Boolean对象的方法 (1)toString()方法 (2)valueOf()方法 Math对象 1.math对象的属性 例子: var piValue=Math.PI; //计算圆周率 var rootofTwo=Math.SQRT2; //计算平方根 2. Math对象的方法 例子: var result=Math.pow(value1,10); //计算一个数的10次方 var result=Math.round(value); //使用四舍五入函数计算最相近的整数值 随机产生指定位数的验证码。 <body> <script type="text/javascript" language="JavaScript"> function ran(digit){ /*自动生成验证码*/ var result=""; for(i=0;i<parseInt(digit);i++){ result=result+(parseInt(Math.random()*10)).toString(); } return result; } function deal(){ result.innerHTML="&nbsp;&nbsp;产生的验证码:"+ran(form.digit.value); } </script> <form name="form"> <input type="text" name="digit" /> <input type="button" value="生成" onclick="deal()"/> </form> <div id="result"> &nbsp;&nbsp;产生的验证码: </div> </body> Number对象 由于JavaScript使用简单数值完成日常数值的计算,因此,number对象很少被使用,当需要访问某些常量值时,如数字的最大或最小值、正无穷大或负无穷大时,该对象显得非常有用。 1.创建Number对象 number对象是原始数值的包装对象,使用该对象可以将数字作为对象直接进行访问。 语法:numobject=new Number(value) value:可选项。是新对象的数字值。如果忽略value,则返回值为0. 2.Number对象的属性 (1)MAX_VALUE属性 MAX_VALUE属性用于返回number对象的最大可能值。 语法:value=Number.MAX_VALUE; value:存储Number对象的最大可能值的变量。 例子: var max=Number.MAX_VALUE; document.write(max); (2)MIN_VALUE属性 MIN_VALUE属性用于返回number对象的最小可能值 语法:value=Number.MIN_VALUE value:存储Number对象的最小可能值的变量。 (3)NEGATIVE_INFINITY属性 NEGATIVE_INFINITY属性用于返回number对象的负无穷大的值。 语法:value=Number.NEGATIVE_INFINITY value:存储Number对象的负无穷大的值。 (4)POSITIVE_INFINITY属性 POSITIVE_INFINITY属性用于返回number对象的正无穷大的值。 语法:value=Number.POSITIVE_INFINITY value:存储Number对象的正无穷大的值。 3.Number对象的方法 (1)toString()方法 toString()方法可以把Number对象转换成一个字符串,并返回结果。 语法:Numberobject=.toString(radix) (2)toFixed()方法 toFixed()方法将number对象四舍五入为指定小数位数的数字,然后转换为字符串。 语法:Numberbject.toFixed(num) (3)toExponential()方法 toExponential()方法 利用指数计数法计算number对象的值,然后将其转换成字符串。 语法:number.toExponential(NUM) NUM:必选项。规定指数计数法中的小数位数 ,是0-20之间的值。 (4)toPrecision()方法 toPrecision()方法将number对象转换成字符串,并根据不同的情况选择定点计数法或指数计数法。 语法:number.toPrecision(num) NUM:必选项。规定指数计数法中的小数位数 ,是0-20之间的值。 Boolean对象 1.创建Boolean对象 Boolean对象是JavaScript的一种基本数据类型,是一个把布尔值打包的布尔对象。可以通过Boolean对象创建新的Boolean值。 语法:bool=new Boolean([boolValue]) bool:要赋值为Boolean对象的变量名。 boolValue:可选项。是新对象的初始Boolean值。如果忽略boolValue,或者其值为false、0、null、NaN或空字符串,则该Boolean对象的初始值为false;否则,初始值为true。 2.Boolean对象的属性 Boolean对象有constructor和prototype两个属性,下面分别进行介绍。 (1)constructor属性 constructor属性用于对当前函数的引用。 (2)prototype属性 prototype属性可以对对象添加属性和方法。 var newboolean=new Boolean(); Boolean.prototype.mark=null; newboolean.mard=1; alert(newboolean.mard); 3.Boolean对象的方法 Boolean对象有toString()和valueOf()两个方法。 (1)toString()方法 toString()方法用于将Boolean值转换为字符串。 语法:Boolean.toString() (2)valueOf()方法 valueOf()方法用于返回Boolean对象的原始值。 语法:Boolean.valueOf()

优秀的个人博客,低调大师

Coding and Paper Letter(二十一)

资源整理。 1 Coding: 1.R语言包psychmeta,用于心理学方面的的Meta分析。 psychmeta 2.开源项目trug ggplot2, 2018年1月,Tampa的R用户会议关于ggplot2语法的ppt。 trug ggplot2 3.开源项目Residual Attention Network, Residual Attention Network 4.Python库sentinel_api,欧空局哨兵卫星数据的API接口。 esa sentinel 5.R语言开源电子书,有关创建R建模包的建议。 model implementation principles 6.书籍R for Data Sciences的附录指南。 r4ds instructors 7.Python库pyny3d,面向工程的工具,用于交互式构建,工作和执行具有3D几何的着色模拟。 pyny3d 8.R语言包geoparser,geoparser.io的R语言接口。 geoparser 9.微软开源项目nni,用于神经架构搜索和超参数调整的开源AutoML工具包。 nni 10.开源项目Open3D,开源的3D数据处理的库。 Open3D 11.开源项目jpmml sparkml lightgbm,JPMML-SparkML插件,用于将LightGBM-Spark模型转换为PMML。 jpmml sparkml lightgbm 12.D3插件,它根据Voronoi曲面细分计算树形图。 d3 voronoi treemap 13.Python库esridump,esri RESTful的API接口,将格式转换为更普遍的geojson。 pyesridump 14.R语言包googleLanguageR,谷歌翻译的R语言客户端。 googleLanguageR 15.Python的Docker镜像。 python 16.开源项目cityengine,分享一些CGA规则和代码。 cityengine 17.开源项目intro r gis,R语言里的GIS中简介。 intro r gis 18.开源项目swiss maps,从swiss top生成topojson数据。 swiss maps 19.开源项目NYTaxi,纽约出租车轨迹数据分析。基于R和Python。 NYTaxi 20.R语言包condvis,统计模型的可视化。 condvis 21.R语言包rangemap,用于构建物种分布范围图的R包。 rangemap 22.开源项目opendata,该项目包含有关使用R获取,解析,操作,创建和共享打开数据的信息。 opendata 23.R语言包grcdr,R中图形的ggplot2扩展和脚本的集合。 grcdr 24.基于Web的附录和已发布文章中使用的代码教程。 examples 25.R语言包geoplumber,从R服务地理数据并使用可扩展的前端服务。 geoplumber 26.R语言包gpuR,R语言使用GPU的接口。 gpuR 27.开源项目awesome quantum machine learning,量子机器学习基础知识,算法,学习资料,项目以及网络项目的描述。 awesome quantum machine learning 28.R语言包gbm,老的gbm包,梯度提升模型包。 gbm 29.R语言包fts,快速的时间序列库。 fts 30.开源项目FAST,通过有效的时间序列相似性搜索实现地震检测。 FAST 31.R语言包geofacet,ggplot2的拓展包,地理分面工具。 geofacet 32.R语言包terra,空间数据处理的R包。 terra 2 Paper: 1.Fast Geographically Weighted Regression (FastGWR): A Scalable Algorithm to Investigate Spatial Process Heterogeneity in Millions of Observations/快速地理加权回归(FastGWR):一种可扩展的算法,用于研究数百万次观测中的空间过程异质性 地理加权回归(GWR)是一种广泛使用的工具,用于探索地理空间上的过程的空间异质性。 GWR计算特定于位置的参数估计,这使得其校准过程计算密集。当前开源GWR软件可以处理的最大数据点数在标准桌面上大约为15,000个观测值。在大数据时代,这严重限制了GWR的使用。为了克服这一限制,我们提出了一种基于Python和消息传递接口(MPI)的高度可扩展的开源FastGWR实现,可以扩展到数百万次观察。 FastGWR优化了内存使用以及并行化,从而显着提升了性能。为了说明FastGWR的性能,从洛杉矶市的Zillow数据集中,对大约130万个单户住宅物业进行了特征房价模型的校准,这是首次将GWR应用于此大小的数据集。结果表明,随着高性能计算(HPC)环境中核心数量的增加,FastGWR呈线性扩展。它还优于目前可用的开源GWR软件包,在标准桌面上具有极快的速度降低速度 - 快达数千倍。很有幸,笔者在5月份北京的空间精度2018会议上见过作者的汇报,当时的题目是比较不同GWR的结果是否有差异性?同时也简要介绍了他开发的FastGWR软件。现在已经在IJGIS发表了,GWR算法在大数据上的扩展。之前笔者在暑期学校的时候有幸听过Fothingham的汇报,他也曾说过原来的GWR运算规模大约在8w条左右数据。因此这个FastGWR的出现将会为GWR领域的研究带来更多的活力与生机。 2.Using MAIAC AOD to verify the PM2.5 spatial patterns of a land use regression model/使用MAIAC AOD验证土地利用回归模型的PM2.5空间模式 PM2.5的准确空间信息对于空气污染控制和流行病学研究至关重要。土地利用回归(LUR)模型已被广泛用于预测地面PM2.5的空间分布。然而,由于有限的地面观测,LUR模型的预测PM2.5空间模式尚未得到充分研究。增加的气溶胶光学厚度(AOD)产品可能是大面积空间连续观测的近似值。本研究建立了北京季节1 km×1 km MAIAC AOD与观测地PM2.5之间的关系,并根据AOD预测了季节性PM2.5地图。还开发了季节性LUR模型,AOD和LUR模型均通过保持监测站点进行验证。最后,通过上述AOD PM2.5图,全面验证了LUR模型的空间模式。结果表明,单独AOD可以直接用于预测地面PM2.5浓度在季节水平的空间分布,与LUR模型的能力相当。源自这两种方法的PM2.5地图在交通道路附近显示出相似的空间趋势和协调变化。在土地利用特征变化很快的城乡过渡地区,可以观察到很大的差异。变量和缓冲区大小选择对于LUR模型至关重要,因为它们主导了预测PM2.5的空间模式。将AOD纳入LUR模型可以提高春季的模型性能,并在测试过程中提供更可靠的结果。LUR模型和AOD产品的对比研究,PM2.5的制图是当前大气遥感的一大研究重点,LUR和AOD的研究是比较普遍的两种方式。这个比较还是比较有意思的。 3.Supervised Classification of Power Lines from Airborne LiDAR Data in Urban Areas/基于机载激光雷达数据的城市电力线监督分类 使用机载LiDAR(光探测和测距)数据自动提取电力线一直是电力管理最重要的主题之一。然而,这对于复杂的城市地区来说非常具有挑战性,因为电力线靠近建筑物和树木。在本文中,我们提出了一个新的,半自动化和通用的框架,包括四个步骤:(i)电力线候选点过滤,(ii)局部邻域选择,(iii)空间结构特征提取,以及(iv)SVM分类。我们介绍了候选点过滤和多尺度斜圆柱邻域的电力线走廊方向,用于空间结构特征提取。在详细评估涉及七个尺度和四种类型的局部邻域选择,26个结构特征和两个数据集,我们证明了使用多尺度斜圆柱邻域的单个3D点显着改善了电力线分类。实验表明,电力线分类的精度,召回率和质量率分别超过98%,98%和97%。此外展示了该方法可以减少整个处理时间,同时实现高精度。激光雷达遥感的一个新应用,电力线规划。激光雷达遥感近年来的兴起,使得遥感方面有了很多新的应用。 4.URBAN-i: From urban scenes to mapping slums, transport modes, and pedestrians in cities using deep learning and computer vision/URBAN-i:从城市场景到城市中的贫民窟,交通方式和行人,使用深度学习和计算机视觉 在跨越不同科学领域的深度学习和计算机视觉的迅速发展中,在城市发展方面,深度学习和计算机视觉应用仍然局限于智能城市和自动驾驶汽车的概念。实际上,在欠发达国家的城市和城市地区出现了很大的知识差距,其中非正规性的混乱是主导方案。深度学习和人工智能(AI)如何解决非正规性的复杂性,以推进城市建模和我们对城市的理解?在人工智能和计算机视觉的范例中,可以提出关于北方和南方城市未来的各种问题和争论。在本文中,我们介绍了一种依靠深度学习和计算机视觉的多用途现实 - 动态城市建模的新方法,使用深度卷积神经网络(CNN),从空中和街景图像中感知和检测城市场景中的非正规性和贫民窟。除了检测行人和运输模式。该模型已经在全球城市的城市场景图像上进行了培训。该模型很好地验证了计划区域和非计划区域之间的各种细微差别,包括非正规区域和贫民区。我们尝试推进城市建模,以更好地了解城市发展的动态。我们还旨在举例说明人工智能在城市中的重要影响,超越了主流中智能城市的讨论和感知。 URBAN-i模型的算法在Python编程中完全编码,使用预先训练的深度学习模型,用作地球各个角落的地图和城市建模工具,包括非正式住区和贫民窟区域。计算机视觉和深度学习在城市规划中的应用。 5.Nighttime light images reveal spatial-temporal dynamics of global anthropogenic resources accumulation above ground/夜间光图像揭示了地上全球人为资源积累的时空动态 城市化和工业化在很大程度上代表了从生物圈和岩石圈到人类圈的材料转化过程。因此,了解这种人为物质库存积累的模式是评估和维持人类如何改变地球周围资源的生物物理运动的基本先决条件。然而,由于较高空间分辨率的数据缺口,以前关于这些人为种群的研究往往局限于全球和国家尺度。在此基础上,本研究基于一套新的国家材料库存数据和夜间光图像,开发了一个回归模型,用于绘制1 km×1 km水平的三种基本建筑材料(钢,混凝土和铝)的全球人为库存。 1992年至2008年,本研究发现了一种分布不均匀的模式,其中超过40%来自三条带:从英格兰穿越海峡到西欧;从中国东部沿海到韩国和日本;从美国东海岸的五大湖到佛罗里达州。较小空间尺度的全球人为种群的时空动态反映了自然地理,建筑和建筑规范以及社会经济发展的综合影响。本研究的结果提供了有用的数据,可以为区域和城市规模的政策制定者和行业提供资源效率,废物管理,城市采矿,空间规划和环境可持续性方面的支持。夜间灯光用于产业生态方面的研究,长时间序列的产业生态学人为资源积累的高分辨率制图。 6.Estimating the impacts of urban form on CO2 emission efficiency in the Pearl River Delta, China/估算城市形态对珠江三角洲二氧化碳排放效率的影响 提高二氧化碳排放效率对实现节能减排目标,实现低碳发展具有重要意义。虽然人们越来越认识到城市形态可以显着影响城市地区的二氧化碳排放,但很少有研究能够量化城市形态对二氧化碳排放效率的影响。因此,本文的目的是通过实证量化城市形态如何影响二氧化碳排放效率来为现有文献做出贡献。本研究中的二氧化碳排放效率以二氧化碳经济效率(CEE)和二氧化碳社会效率(CSE)表示。首先,本研究利用1990 - 2013年期间当地重要的社会经济变量,计算了珠江三角洲(广州,深圳,珠海,佛山,江门,肇庆,惠州,东莞和中山)九个城市的相关数据。然后,选择了七个景观指标,以便使用遥感数据量化城市形态的三个维度(扩展,不规则和紧凑)。最后,利用面板数据模型来估计城市形态与二氧化碳排放效率之间的关联。本研究发现城市扩张与CEE和CSE之间存在负相关关系,这一发现表明城市增长会降低二氧化碳的经济效率。此外,发现城市形式的不规则性增加会降低CEE和CSE-更大程度的不规则性,换句话说,导致更低的二氧化碳排放效率。相反,城市紧凑性被确定为对CEE和CSE都有显着的积极影响,这表明城市的紧凑发展实际上可以帮助提高二氧化碳排放效率。这项研究的结果对于建设中国的低碳城市具有重要意义。一直关注城市形态对于二氧化碳排放的影响,这篇文章是一篇很不错的参考论文。 7.Estimation of ground level particulate matter concentrations through the synergistic use of satellite observations and process-based models over South Korea/通过在韩国协同使用卫星观测和基于过程的模型估算地面颗粒物浓度 长时间暴露于空气动力学直径10μm(PM10)和2.5μm(PM2.5)的颗粒物质(PM)对人体健康具有负面影响。虽然在全球范围内进行了基于站点的PM监测,但在高空间分辨率下为大面积区域提供空间连续的PM信息仍然具有挑战性。卫星衍生的气溶胶信息,如气溶胶光学深度(AOD),经常被用来研究地面PM浓度。在这项研究中,我们将多个卫星衍生产品(包括AOD)与基于模型的气象参数(即露点温度,风速,表面压力,行星边界层高度和相对湿度)和排放参数(即NO,NH3, SO2,POA和HCHO)估算韩国的表面PM浓度。随机森林(RF)机器学习用于估算PM10和PM2.5浓度,2015-2016共有32个参数。结果表明,基于RF的模型产生了良好的性能,导致R10值分别为0.78和0.73,PMMS和PM2.5的RMSE分别为17.08μg/m³和8.25μg/m³。特别是,所提出的模型成功地估计了高PM浓度。 AOD被认为是估算地面PM浓度最重要的因素,其次是风速,太阳辐射和露点温度。使用来自对地静止卫星传感器(即GOCI)的气溶胶信息导致估算PM浓度的精度略高于来自极轨道传感器系统(即MODIS)的精度。所提出的RF模型产生了更好的性能,特别是在改进低估基于过程的模型(即GEOS-Chem和CMAQ)方面。融合过程模型与卫星影像的PM污染物制图,多源数据融合用在PM制图上的工作,发表在欧洲地学旗舰刊物。 8.Transferability and Upscaling of Fuzzy Classification for Shoreline Change over 30 Years/30年来海岸线变化模糊分类的可转移性和提升 地方当局要求提供有关土地使用决策的海岸线变更信息。监测海岸线变化对于更新沿海规划和管理中使用的海岸线地图非常有用。通过分析一段时间内的数据,可以确定海岸变化的位置和速度。因此,我们可以防止高风险区域的任何发展。这项研究调查了海岸线变化的模糊分类的可转移性,并向更大的区域进行了升级。使用六个子区域,使用了三种策略:(i)基于参考子集的主要土地利用/覆盖优化两个FCM(模糊c-均值)参数,(ii)采用类别平均值和由参考子集的分类以在目标子集上执行FCM,以及(iii)估计目标子集的模糊性的最佳水平。这种方法应用于一系列图像,以确定印度尼西亚中爪哇省北部一段三十年来海岸线位置发生严重变化的海岸线位置。通过覆盖海岸线图像估算海岸线变化的程度。突出显示海岸线位置以推断沿海岸的侵蚀和吸积区域,并计算海岸线的变化。从实验结果来看,我们获得了分析的7个土地利用/覆盖等级的m(模糊度)值在1.3到1.9的范围内。此外,对于本研究中使用的十个图像,我们获得了最优m = 1.8。对于类似的沿海特征,可以采用该m值,并且土地利用/覆盖与两个FCM参数之间的关系可以缩短优化参数所需的时间。所提出的用于将分类方法放大并转移到更大或不同区域的方法是有希望的,显示κ(kappa)值> 0.80。结果还显示参考和目标子集之间的水隶属度值的一致性由κ> 0.82表示。在研究期间,该地区表现出侵蚀和吸积。通过水的变化表明侵蚀,并且观察到从非水到海岸线的变化大约78平方公里。增加的原因是非水的变化以及从水变为海岸线的变化为19.5平方公里。研究区东段的侵蚀严重,而中段通过填海活动获得土地。这些侵蚀和吸积过程在海岸线的变化中发挥了积极作用。我们得出结论,该方法适用于当前的研究领域。可以采用土地利用/覆盖等级与本研究中产生的FCM参数值之间的关系。海岸线的遥感提取的研究,基于模糊分类的方法。近年来海平面上升一直是全球变暖关键的关注问题,海岸线的遥感提取可以快速帮助这方面的深入研究。

优秀的个人博客,低调大师

(十一) J.U.C-FutureTask

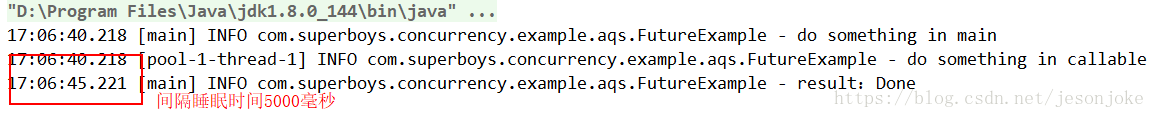
FutureTask FutureTask是J.U.C中的类,是一个可删除的异步计算类。这个类提供了Future接口的的基本实现,使用相关方法启动和取消计算,查询计算是否完成,并检索计算结果。只有在计算完成时才能使用get方法检索结果;如果计算尚未完成,get方法将会阻塞。一旦计算完成,计算就不能重新启动或取消(除非使用runAndReset方法调用计算)。 Runnable与Callable对比 通常实现一个线程我们会使用继承Thread的方式或者实现Runnable接口,这两种方式有一个共同的缺陷就是在执行完任务之后无法获取执行结果。从Java1.5之后就提供了Callable与Future,这两个接口就可以实现获取任务执行结果。 Runnable接口:代码非常简单,只有一个方法run public interface RunnableFuture<V> extends Runnable, Future<V> { void run(); } Callable泛型接口:有泛型参数,提供了一个call方法,执行后可返回传入的泛型参数类型的结果。 public interface Callable<V> { V call() throws Exception; } Future接口 Future接口提供了一系列方法用于控制线程执行计算,如下: public interface Future<V> { boolean cancel(boolean mayInterruptIfRunning);//取消任务 boolean isCancelled();//是否被取消 boolean isDone();//计算是否完成 V get() throws InterruptedException, ExecutionException;//获取计算结果,在执行过程中任务被阻塞 V get(long timeout, TimeUnit unit)//timeout等待时间、unit时间单位 throws InterruptedException, ExecutionException, TimeoutException; } 使用方法: public class FutureExample { static class MyCallable implements Callable<String> { @Override public String call() throws Exception { log.info("do something in callable"); Thread.sleep(5000); return "Done"; } } public static void main(String[] args) throws Exception { ExecutorService executorService = Executors.newCachedThreadPool(); Future<String> future = executorService.submit(new MyCallable());//线程池提交任务 log.info("do something in main"); Thread.sleep(1000); String result = future.get();//获取不到一直阻塞 log.info("result:{}", result); } } 运行结果:阻塞效果 FutureTask Future实现了RunnableFuture接口,而RunnableFuture接口继承了Runnable与Future接口,所以它既可以作为Runnable被线程中执行,又可以作为callable获得返回值。 public class FutureTask<V> implements RunnableFuture<V> { ... } public interface RunnableFuture<V> extends Runnable, Future<V> { void run(); } FutureTask支持两种参数类型,Callable和Runnable,在使用Runnable 时,还可以多指定一个返回结果类型。 public FutureTask(Callable<V> callable) { if (callable == null) throw new NullPointerException(); this.callable = callable; this.state = NEW; // ensure visibility of callable } public FutureTask(Runnable runnable, V result) { this.callable = Executors.callable(runnable, result); this.state = NEW; // ensure visibility of callable } 1. FutureTask执行多任务计算的使用场景 利用FutureTask和ExecutorService,可以用多线程的方式提交计算任务,主线程继续执行其他任务,当主线程需要子线程的计算结果时,在异步获取子线程的执行结果。 import java.util.ArrayList; import java.util.List; import java.util.concurrent.Callable; import java.util.concurrent.ExecutionException; import java.util.concurrent.ExecutorService; import java.util.concurrent.Executors; import java.util.concurrent.FutureTask; public class FutureTaskForMultiCompute { public static void main(String[] args) { FutureTaskForMultiCompute inst=new FutureTaskForMultiCompute(); // 创建任务集合 List<FutureTask<Integer>> taskList = new ArrayList<FutureTask<Integer>>(); // 创建线程池 ExecutorService exec = Executors.newFixedThreadPool(5); for (int i = 0; i < 10; i++) { // 传入Callable对象创建FutureTask对象 FutureTask<Integer> ft = new FutureTask<Integer>(inst.new ComputeTask(i, ""+i)); taskList.add(ft); // 提交给线程池执行任务,也可以通过exec.invokeAll(taskList)一次性提交所有任务; exec.submit(ft); } System.out.println("所有计算任务提交完毕, 主线程接着干其他事情!"); // 开始统计各计算线程计算结果 Integer totalResult = 0; for (FutureTask<Integer> ft : taskList) { try { //FutureTask的get方法会自动阻塞,直到获取计算结果为止 totalResult = totalResult + ft.get(); } catch (InterruptedException e) { e.printStackTrace(); } catch (ExecutionException e) { e.printStackTrace(); } } // 关闭线程池 exec.shutdown(); System.out.println("多任务计算后的总结果是:" + totalResult); } private class ComputeTask implements Callable<Integer> { private Integer result = 0; private String taskName = ""; public ComputeTask(Integer iniResult, String taskName){ result = iniResult; this.taskName = taskName; System.out.println("生成子线程计算任务: "+taskName); } public String getTaskName(){ return this.taskName; } @Override public Integer call() throws Exception { // TODO Auto-generated method stub for (int i = 0; i < 100; i++) { result =+ i; } // 休眠5秒钟,观察主线程行为,预期的结果是主线程会继续执行,到要取得FutureTask的结果是等待直至完成。 Thread.sleep(5000); System.out.println("子线程计算任务: "+taskName+" 执行完成!"); return result; } } } 2. FutureTask在高并发环境下确保任务只执行一次 在很多高并发的环境下,往往我们只需要某些任务只执行一次。这种使用情景FutureTask的特性恰能胜任。举一个例子,假设有一个带key的连接池,当key存在时,即直接返回key对应的对象;当key不存在时,则创建连接。对于这样的应用场景,通常采用的方法为使用一个Map对象来存储key和连接池对应的对应关系,典型的代码如下面所示: private Map<String, Connection> connectionPool = new HashMap<String, Connection>(); private ReentrantLock lock = new ReentrantLock(); public Connection getConnection(String key){ try{ lock.lock(); if(connectionPool.containsKey(key)){ return connectionPool.get(key); } else{ //创建 Connection Connection conn = createConnection(); connectionPool.put(key, conn); return conn; } } finally{ lock.unlock(); } } //创建Connection private Connection createConnection(){ return null; } 在上面的例子中,我们通过加锁确保高并发环境下的线程安全,也确保了connection只创建一次,然而确牺牲了性能。改用ConcurrentHash的情况下,几乎可以避免加锁的操作,性能大大提高,但是在高并发的情况下有可能出现Connection被创建多次的现象。这时最需要解决的问题就是当key不存在时,创建Connection的动作能放在connectionPool之后执行,这正是FutureTask发挥作用的时机,基于ConcurrentHashMap和FutureTask的改造代码如下: private ConcurrentHashMap<String,FutureTask<Connection>>connectionPool = new ConcurrentHashMap<String, FutureTask<Connection>>(); public Connection getConnection(String key) throws Exception{ FutureTask<Connection>connectionTask=connectionPool.get(key); if(connectionTask!=null){ return connectionTask.get(); } else{ Callable<Connection> callable = new Callable<Connection>(){ @Override public Connection call() throws Exception { // TODO Auto-generated method stub return createConnection(); } }; FutureTask<Connection>newTask = new FutureTask<Connection>(callable); connectionTask = connectionPool.putIfAbsent(key, newTask); if(connectionTask==null){ connectionTask = newTask; connectionTask.run(); } return connectionTask.get(); } } //创建Connection private Connection createConnection(){ return null; } 经过这样的改造,可以避免由于并发带来的多次创建连接及锁的出现。

优秀的个人博客,低调大师

腾讯云数据库:Agent记忆头名封神

大模型智能体正加速渗透企业核心业务,但一个被长期忽视的致命短板正在吞噬商业价值:在传统上下文跟随机制下,智能体面对信息量爆炸的长周期任务时,早期的关键设定极易被后期汹涌的对话内容"冲刷"殆尽。更尴尬的是,用户一旦切换聊天窗口或更换终端渠道,AI 便仿佛"失忆"般从零开始,任务频繁断线、重复确认,体验断崖式下跌。对于金融、政务、电商等高价值场景而言,这种上下文断裂不是体验瑕疵,而是直接动摇业务连续性的系统性风险。谁能在跨会话、长周期、多任务环境中守住记忆连续性,谁就握住了 Agent 规模化落地的命门。

优秀的个人博客,低调大师

腾讯云国际站:Apache、Nginx、Tomcat怎么选?

搞 Web 部署的人迟早都会撞上一个问题:Apache、Nginx、Tomcat 这三者,到底该用哪个,还是组合起来用?它们名字经常同框出现,但角色定位的差异远比表面上看起来大。如果不先厘清各自能干什么、不能干什么,Apache Nginx Tomcat 选择对比就会流于配置参数的堆砌,而抓不住架构决策的关键。下面从最基本的功能边界开始展开。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册