首页 文章 精选 留言 我的

精选列表

搜索[文档系统],共10000篇文章
优秀的个人博客,低调大师

Apache Storm 官方文档 —— Trident State

Trident 中含有对状态化(stateful)的数据源进行读取和写入操作的一级抽象封装工具。这个所谓的状态(state)既可以保存在拓扑内部(保存在内存中并通过 HDFS 来实现备份),也可以存入像 Memcached 或者 Cassandra 这样的外部数据库中。而对于 Trident API 而言,这两种机制并没有任何区别。 Trident 使用一种容错性的方式实现对 state 的管理,这样,即使在发生操作失败或者重试的情况下状态的更新操作仍然是幂等的。基于这个机制,每条消息都可以看作被恰好处理了一次,然后你就可以很容易地推断出 Trident 拓扑的状态。 State 的更新过程支持多级容错性保证机制。在讨论这一点之前,我们先来看一个例子,这个例子展示了如何实现恰好一次的语义的技术。假如你正在对数据流进行一个计数聚合操作,并打算将计数结果存入数据库中。在这个例子里,你存入数据库的就是一个对应计数结果的值,每次处理新 tuple 的时候就会增加这个值。 考虑到可能存在的处理失败情况,tuple 有可能需要重新处理。这样就给 state 的更新操作带来了一个问题(或者其他的副作用)—— 你无法知道当前的这个 tuple 的更新操作是否已经处理过了。也许你之前没有处理过这个 tuple,那么你现在就需要增加计数结果;也许你之前已经处理过 tuple 了并且成功地增加了计数结果,但是在后续操作过程中 tuple 的处理失败了,并由此引发了 tuple 的重新处理操作,这时你就不能再增加计数结果了;还有可能你之前在使用这个 tuple 更新数据库的时候出错了,也就是说计数值的更新操作并未成功,此时在 tuple 的重新处理过程中你仍然需要更新数据库。 所以说,如果只是向数据库中简单地存入计数值,你确实无法知道 tuple 是否已经被处理过。因此,你需要一些更多的信息来做决定。Trident 提供了一种支持恰好一次处理的语义,如下所述: 通过小数据块(batch)的方式来处理 tuple(可以参考Trident 教程一文) 为每个 batch 提供一个唯一的 id,这个 id 称为 “事务 id”(transaction id,txid)。如果需要对 batch 重新处理,这个 batch 上仍然会赋上相同的 txid。 State 的更新操作是按照 batch 的顺序进行的。也就是说,在 batch 2 完成处理之前,batch 3 的状态更新操作不会进行。 基于这几个基本性质,你的 State 的实现就可以检测到 tuple 的 batch 是否已经被处理过,并根据检测结果选择合适的 state 更新操作。你具体采用的操作取决于你的输入 spout 提供的语义,这个语义对每个 batch 都是有效的。有三类支持容错性的 spout:“非事务型”(non-transactional)、“事务型”(transactional)以及“模糊事务型”(opaque transactional)。接下来我们来分析下每种 spout 类型的容错性语义。 事务型 spout(Transactional spouts) 记住一点,Trident 是通过小数据块(batch)的方式来处理 tuple 的,而且每个 batch 都会有一个唯一的 txid。spout 的特性是由他们所提供的容错性保证机制决定的,而且这种机制也会对每个 batch 发生作用。事务型 spout 包含以下特性: 每个 batch 的 txid 永远不会改变。对于某个特定的 txid,batch 在执行重新处理操作时所处理的 tuple 集和它的第一次处理操作完全相同。 不同 batch 中的 tuple 不会出现重复的情况(某个 tuple 只会出现在一个 batch 中,而不会同时出现在多个 batch 中)。 每个 tuple 都会放入一个 batch 中(处理操作不会遗漏任何的 tuple)。 这是一种很容易理解的 spout,其中的数据流会被分解到固定的 batches 中。Storm-contrib 项目中提供了一种基于 Kafka 的事务型 spout 实现。 看到这里,你可能会有这样的疑问:为什么不在拓扑中完全使用事务型 spout 呢?这个原因很好理解。一方面,有些时候事务型 spout 并不能提供足够可靠的容错性保障,所以不需要使用事务型 spout。比如,TransactionalTridentKafkaSpout的工作方式就是使得带有某个 txid 的 batch 中包含有来自一个 Kafka topic 的所有 partition 的 tuple。一旦一个 batch 被发送出去,在将来无论重新发送这个 batch 多少次,batch 中都会包含有完全相同的 tuple 集,这是由事务型 spout 的语义决定的。现在假设TransactionalTridentKafkaSpout发送出的某个 batch 处理失败了,而与此同时,Kafka 的某个节点因为故障下线了。这时你就无法重新处理之前的 batch 了(因为 Kafka 的节点故障,Kafka topic 必然有一部分 partition 无法获取到),这个处理过程也会因此终止。 这就是要有“模糊事务型” spout 的原因了 —— 模糊事务型 spout 支持在数据源节点丢失的情况下仍然可以实现恰好一次的处理语义。我们会在下一节讨论这类 spout。 顺便提一点,如果 Kafka 支持数据复制,那么就可以放心地使用事务型 spout 提供的容错性机制了,因为这种情况下某个节点的故障不会导致数据丢失,不过 Kafka 暂时还不支持该特性。(本文的写作时间应该较早,Kakfa 早就已经可以支持复制的机制了 —— 译者注)。 在讨论“模糊事务型” spout 之前,让我们先来看看如何为事务型 spout 设计一种支持恰好一次语义的 State。这个 State 就称为 “事务型 state”,它支持对于特定的 txid 永远只与同一组 tuple 相关联的特性。 假如你的拓扑需要计算单词数,而且你准备将计数结果存入一个 K-V 型数据库中。这里的 key 就是单词,value 对应于单词数。从上面的讨论中你应该已经明白了仅仅存储计数结果是无法确定某个 batch 中的tuple 是否已经被处理过的。所以,现在你应该将 txid 作为一种原子化的值与计数值一起存入数据库。随后,在更新计数值的时候,你就可以将数据库中的 txid 与当前处理的 batch 的 txid 进行比对。如果两者相同,你就可以跳过更新操作 —— 由于 Trident 的强有序性处理机制,可以确定数据库中的值是对应于当前的 batch 的。如果两者不同,你就可以放心地增加计数值。由于一个 batch 的 txid 永远不会改变,而且 Trident 能够保证 state 的更新操作完全是按照 batch 的顺序进行的,所以,这样的处理逻辑是完全可行的。 下面来看一个例子。假如你正在处理 txid 3,其中包含有以下几个 tuple: ["man"] ["man"] ["dog"] 假如数据库中有以下几个 key-value 对: man => [count=3, txid=1] dog => [count=4, txid=3] apple => [count=10, txid=2] 其中与 “man” 相关联的 txid 为 1。由于当前处理的 txid 为 3,你就可以确定当前处理的 batch 与数据库中存储的值无关,这样你就可以放心地将 “man” 的计数值加上 2 并更新 txid 为 3。另一方面,由于 “dog” 的 txid 与当前的 txid 相同,所以,“dog” 的计数是之前已经处理过的,现在不能再对数据库中的计数值进行更新操作。这样,在结束 txid3 的更新操作之后,数据库中的结果就会变成这样: man => [count=5, txid=3] dog => [count=4, txid=3] apple => [count=10, txid=2] 现在我们再来讨论一下“模糊事务型” spout。 模糊事务型 spout(Opaque transactional spouts) 前面已经提到过,模糊事务型 spout 不能保证一个 txid 对应的 batch 中包含的 tuple 完全一致。模糊事务型 spout 有以下的特性: 每个 tuple 都会通过某个 batch 处理完成。不过,在 tuple 处理失败的时候,tuple 有可能继续在另一个 batch 中完成处理,而不一定是在原先的 batch 中完成处理。 OpaqueTridentKafkaSpout就具有这样的特性,同时它对 Kafka 节点的丢失问题具有很好的容错性。OpaqueTridentKafkaSpout在发送一个 batch 的时候总会总上一个 batch 结束的地方开始发送新 tuple。这一点可以保证 tuple 不会被遗漏,而且也不会被多个 batch 处理。 不过,模糊事务型 spout 的缺点就在于不能通过 txid 来识别数据库中的 state 是否是已经处理过的。这是因为在 state 的更新的过程中,batch 有可能会发生变化。 在这种情况下,你应该在数据库中存储更多的 state 信息。除了一个结果值和 txid 之外,你还应该存入前一个结果值。我们再以上面的计数值的例子来分析以下这个问题。假如你的 batch 的部分计数值是 “2”,现在你需要应用一个更新操作。假定现在数据库中的值是这样的: { value = 4, prevValue = 1, txid = 2 } 情形1:假如当前处理的 txid 为 3,这与数据库中的 txid 不同。这时可以将 “prevValue” 的值设为 “value” 的值,再为 “value” 的值加上部分计数的结果并更新 txid。执行完这一系列操作之后的数据库中的值就会变成这样: { value = 6, prevValue = 4, txid = 3 } 情形2:如果当前处理的 txid 为 2,也就是和数据库中存储的 txid 一致,这种情况下的处理逻辑与上面的 txid 不一致的情况又有所不同。因为此时你会知道数据库中的更新操作是由上一个拥有相同 txid 的batch 做出的。不过那个 batch 有可能与当前的 batch 并不相同,所以你需要忽略它的操作。这个时候,你应该将 “prevValue” 加上 batch 中的部分计数值来计算新的 “value”。在这个操作之后数据库中的值就会变成这样: { value = 3, prevValue = 1, txid = 2 } 这种方法之所以可行是因为 Trident 具有强顺序性处理的特性。一旦 Trident 开始处理一个新的 batch 的状态更新操作,它永远不会回到过去的 batch 的处理上。同时,由于模糊事务型 spout 会保证 batch 之间不会存在重复 —— 每个 tuple 只会被某一个 batch 完成处理 —— 所以你可以放心地使用 prevValue 来更新 value。 非事务型 spout(Non-transactional spouts) 非事务型 spout 不能为 batch 提供任何的安全性保证。非事务型 spout 有可能提供一种“至多一次”的处理模型,在这种情况下 batch 处理失败后 tuple 并不会重新处理;也有可能提供一种“至少一次”的处理模型,在这种情况下可能会有多个 batch 分别处理某个 tuple。总之,此类 spout 不能提供“恰好一次”的语义。 不同类型的 Spout 与 State 的总结 下图显示了不同的 spout/state 的组合是否支持恰好一次的消息处理语义: 模糊事务型 state 具有最好的容错性特征,不过这是以在数据库中存储更多的内容为代价的(一个 txid 和两个 value)。事务型 state 要求的存储空间相对较小,但是它的缺点是只对事务型 spout 有效。相对的,非事务型要求的存储空间最少,但是它也不能提供任何的恰好一次的消息执行语义。 你选择 state 与 spout 的时候必须在容错性与存储空间占用之间权衡。可以根据你的应用的需求来确定哪种组合最适合你。 State API 从上文的描述中你已经了解到了恰好一次的消息执行语义的原理是多么的复杂。不过作为用户你并不需要处理这些复杂的 txid 比对、多值存储等操作,Trident 已经在 State 中封装了所有的容错性处理逻辑,你只需要像下面这样写代码即可: TridentTopology topology = new TridentTopology(); TridentState wordCounts = topology.newStream("spout1", spout) .each(new Fields("sentence"), new Split(), new Fields("word")) .groupBy(new Fields("word")) .persistentAggregate(MemcachedState.opaque(serverLocations), new Count(), new Fields("count")) .parallelismHint(6); 所有处理模糊事务型 state 的逻辑已经封装在MemcachedState.opaque的调用中了。另外,状态更新都会自动调整为批处理操作,这样可以减小与数据库的反复交互的资源损耗。 基本的State接口只有两个方法: public interface State { void beginCommit(Long txid); // 对于类似于在 DRPC 流上进行 partitionPersist 的操作,此方法可以为空 void commit(Long txid); } 前面已经说过,state 更新操作的开始时和结束时都会获取一个 txid。对于你的 state 怎么工作,你在其中使用什么样的方法执行更新操作,或者使用什么样的方法从 state 中读取数据,Trident 并不关心。 假如你有一个包含有用户的地址信息的定制数据库,你需要使用 Trident 与该数据库交互。你的 State 的实现就会包含有用于获取与设置用户信息的方法,比如下面这样: public class LocationDB implements State { public void beginCommit(Long txid) { } public void commit(Long txid) { } public void setLocation(long userId, String location) { // code to access database and set location } public String getLocation(long userId) { // code to get location from database } } 接着你就可以为 Trident 提供一个 StateFactory 来创建 Trident 任务内部的 State 对象的实例。对应于你的数据库(LocationDB)的 StateFactory 大概是这样的: public class LocationDBFactory implements StateFactory { public State makeState(Map conf, int partitionIndex, int numPartitions) { return new LocationDB(); } } Trident 提供了一个用于查询 state 数据源的QueryFunction接口,以及一个用于更新 state 数据源的StateUpdater接口。例如,我们可以写一个查询 LocationDB 中的用户地址信息的 “QueryLocation”。让我们从你在拓扑中使用这个操作的方式开始。假如在拓扑中需要读取输入流中的 userid 信息: TridentTopology topology = new TridentTopology(); TridentState locations = topology.newStaticState(new LocationDBFactory()); topology.newStream("myspout", spout) .stateQuery(locations, new Fields("userid"), new QueryLocation(), new Fields("location")) 这里的QueryLocation的实现可能是这样的: public class QueryLocation extends BaseQueryFunction<LocationDB, String> { public List<String> batchRetrieve(LocationDB state, List<TridentTuple> inputs) { List<String> ret = new ArrayList(); for(TridentTuple input: inputs) { ret.add(state.getLocation(input.getLong(0))); } return ret; } public void execute(TridentTuple tuple, String location, TridentCollector collector) { collector.emit(new Values(location)); } } QueryFunction的执行包含两个步骤。首先,Trident 会将读取的一些数据中汇总为一个 batch 传入 batchRetrieve 方法中。在这个例子中,batchRetrieve 方法会收到一些用户 id。然后 batchRetrieve 会返回一个与输入 tuple 列表大小相同的队列。结果队列的第一个元素与第一个输入 tuple 对应,第二个元素与第二个输入 tuple 相对应,以此类推。 你会发现这段代码并没有发挥出 Trident 批处理的优势,因为这段代码仅仅一次查询一下 LocationDB。所以,实现 LocationDB 的更好的方式应该是这样的: public class LocationDB implements State { public void beginCommit(Long txid) { } public void commit(Long txid) { } public void setLocationsBulk(List<Long> userIds, List<String> locations) { // set locations in bulk } public List<String> bulkGetLocations(List<Long> userIds) { // get locations in bulk } } 然后,你可以这样实现QueryLocation方法: public class QueryLocation extends BaseQueryFunction<LocationDB, String> { public List<String> batchRetrieve(LocationDB state, List<TridentTuple> inputs) { List<Long> userIds = new ArrayList<Long>(); for(TridentTuple input: inputs) { userIds.add(input.getLong(0)); } return state.bulkGetLocations(userIds); } public void execute(TridentTuple tuple, String location, TridentCollector collector) { collector.emit(new Values(location)); } } 这段代码大幅减少了域数据库的IO,具有更高的执行效率。 你需要使用StateUpdater接口来更新 state。下面是一个更新 LocationDB 的地址信息的 StateUpdater 实现: public class LocationUpdater extends BaseStateUpdater<LocationDB> { public void updateState(LocationDB state, List<TridentTuple> tuples, TridentCollector collector) { List<Long> ids = new ArrayList<Long>(); List<String> locations = new ArrayList<String>(); for(TridentTuple t: tuples) { ids.add(t.getLong(0)); locations.add(t.getString(1)); } state.setLocationsBulk(ids, locations); } } 然后你就可以在 Trident 拓扑中这样使用这个操作: TridentTopology topology = new TridentTopology(); TridentState locations = topology.newStream("locations", locationsSpout) .partitionPersist(new LocationDBFactory(), new Fields("userid", "location"), new LocationUpdater()) partitionPersist操作会更新 state 数据源。StateUpdater接收 State 和一批 tuple 作为输入,然后更新这个 State。上面的代码仅仅从输入 tuple 中抓取 userid 和 location 信息,然后对 State 执行一个批处理更新操作。 在 Trident 拓扑更新 LocationDB 之后,partitionPersist会返回一个表示更新后状态的TridentState对象。随后你就可以在拓扑的其他地方使用stateQuery方法对这个 state 执行查询操作。 你也许注意到了 StateUpdater 中有一个 TridentCollector 参数。发送到这个 collector 的 tuple 会进入一个“新的数值流”中。在这个例子里向这个新的流发送 tuple 并没有意义,不过如果你需要处理类似于更新数据库中的计数值这样的操作,你可以考虑将更新后的技术结果发送到这个流中。可以通过TridentState.newValuesStream方法来获取新的流的数据。 persistentAggregate Trident 使用一个称为persistentAggregate的方法来更新 State。你已经在前面的数据流单词统计的例子里见过了这个方法,这里再写一遍: TridentTopology topology = new TridentTopology(); TridentState wordCounts = topology.newStream("spout1", spout) .each(new Fields("sentence"), new Split(), new Fields("word")) .groupBy(new Fields("word")) .persistentAggregate(new MemoryMapState.Factory(), new Count(), new Fields("count")) partitionPersist 是一个接收 Trident 聚合器作为参数并对 state 数据源进行更新的方法,persistentAggregate 就是构建于 partitionPersist 上层的一个编程抽象。在这个例子里,由于是一个分组数据流(grouped stream),Trident 需要你提供一个实现MapState接口的 state。被分组的域就是 state 中的 key,而聚合的结果就是 state 中的 value。MapState接口是这样的: public interface MapState<T> extends State { List<T> multiGet(List<List<Object>> keys); List<T> multiUpdate(List<List<Object>> keys, List<ValueUpdater> updaters); void multiPut(List<List<Object>> keys, List<T> vals); } 而当你在非分组数据流上执行聚合操作时(全局聚合操作),Trident 需要你提供一个实现了Snapshottable接口的对象: public interface Snapshottable<T> extends State { T get(); T update(ValueUpdater updater); void set(T o); } MemoryMapState与MemcachedState都实现了上面两个接口。 实现 Map State 接口 实现MapState接口非常简单,Trident 几乎已经为你做好了所有的准备工作。OpaqueMap、TransactionalMap、与NonTransactionalMap类都分别实现了各自的容错性语义。你只需要为这些类提供一个用于对不同的 key/value 进行 multiGets 与 multiPuts 处理的 IBackingMap 实现类。IBackingMap接口是这样的: public interface IBackingMap<T> { List<T> multiGet(List<List<Object>> keys); void multiPut(List<List<Object>> keys, List<T> vals); } OpaqueMap 会使用OpaqueValue作为 vals 参数来调用 multiPut 方法,TransactionalMap 会使用TransactionalValue作为参数,而 NonTransactionalMap 则直接将拓扑中的对象传入。 Trident 也提供了一个CachedMap用于实现 K-V map 的自动 LRU 缓存功能。 最后,Trident 还提供了一个SnapshottableMap类,该类通过将全局聚合结果存入一个固定的 key 中的方法将 MapState 对象转化为一个 Snapshottable 对象。 可以参考MemcachedState的实现来了解如何将这些工具结合到一起来提供一个高性能的 MapState。MemcachedState支持选择模糊事务型、事务型或者非事务型语义。 转载自并发编程网 - ifeve.com
优秀的个人博客,低调大师

Apache Storm 官方文档 —— Trident Spouts

与一般的 Storm API 一样,spout 也是 Trident 拓扑的数据来源。不过,为了实现更复杂的功能服务,Trident Spout 在普通的 Storm Spout 之上另外提供了一些 API 接口。 数据源、数据流以及基于数据流更新 state(比如数据库)的操作,他们之间的耦合关系是不可避免的。Trident State一文中有这方面的详细解释,理解他们之间的这种联系对于理解 spout 的运作方式非常重要。 Trident 拓扑中的大部分 spout 都是非事务型 spout。在 Trident 拓扑中可以使用普通的IRichSpout接口来创建数据流: TridentTopology topology = new TridentTopology(); topology.newStream("myspoutid", new MyRichSpout()); Trident 拓扑中的所有 spout 都必须有一个唯一的标识,而且这个标识必须在整个 Storm 集群中都是唯一的。Trident 需要使用这个标识来存储 spout 从 ZooKeeper 中消费的元数据(metadata),包括 txid 以及其他相关的 spout 元数据。 你可以使用以下配置项来设置用于存储 spout 元数据的 ZooKeeper 地址(一般情况下不需要设置以下选项,因为 Storm 默认会直接使用集群的 ZooKeeper 服务器来存储数据 —— 译者注): transactional.zookeeper.servers:ZooKeeper 的服务器列表 transactional.zookeeper.port:ZooKeeper 集群的端口 transactional.zookeeper.root:元数据在 ZooKeeper 中存储的根目录。元数据会直接存储在该设置目录下。 管道 默认情况下,Trident 每次处理只一个 batch,知道该 batch 处理成功或者失败之后才会开始处理其他的 batch。你可以通过将 batch 管道化来提高吞吐率,降低每个 batch 的处理延时。同时处理的 batch 的最大数量可以通过topology.max.spout.pending来进行配置。 不过,即使在同时处理多个 batch 的情况下,Trident 也会按照 batch 的顺序来更新 state。例如,假如你正在处理一个将全局计数结果整合并更新到数据库中的任务,那么在你向数据库中更新 batch1 的计数结果时,你同时可以继续处理 batch2、batch3 甚至 batch10 的计数工作。不过,Trident 只会在 batch1 的 state 更新结束之后才会处理后续 batch 的 state 更新操作。这是实现恰好一次处理的语义的必要基础,我们已经在Trident State一文中讨论了这一点。 Trident spout 类型 下面列出了一些可用的 spout API 接口: ITridentSpout:这是最常用的 API,支持事务型和模糊事务型的语义实现。不过一般会根据需要使用它的某个已有的实现,而不是直接实现该接口。 IBatchSpout:非事务型 spout,每次会输出一个 batch 的 tuple。 IPartitionedTridentSpout:可以从分布式数据源(比如一个集群或者 Kafka 服务器)读取数据的事务型 spout。 OpaquePartitionedTridentSpout:可以从分布式数据源读取数据的模糊事务型 spout。 当然,正如这篇教程的开头提到的,除了这些 API 之外,你还可以使用普通的IRichSpout。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 本地模式

本地模式是一种在本地进程中模拟 Storm 集群的工作模式,对于开发和测试拓扑很有帮助。在本地模式下运行拓扑与在集群模式下运行拓扑的方式很相似。 创建一个进程内的“集群”只需要使用LocalCluster类即可,例如: import backtype.storm.LocalCluster; LocalCluster cluster = new LocalCluster(); 随后,你就可以使用LocalCluster中的submitTopology方法来提交拓扑了。与StormSubmitter中相应的方法相似,submitTopology接收一个拓扑名称、拓扑配置以及拓扑对象作为输入参数。你也可以以拓扑名称为参数,使用killTopology方法来 kill 掉对应的拓扑。 使用以下语句关闭本地模式集群运行: cluster.shutdown(); 本地模式的常用配置 你可以在这里找到完整的配置项列表。以下是几个比较有用的配置项说明: Config.TOPOLOGY_MAX_TASK_PARALLELISM:该配置项设置了单个组件(bolt/spout)的线程数上限。生产环境下的拓扑往往含有很高的并行度(数百个线程),导致在本地模式下测试拓扑时会有较大的负载。这个配置项可以让你很容易地控制并行度。 Config.TOPOLOGY_DEBUG:此配置项设置为 true 时 Storm 会打印出 spout 或者 bolt 每一次发送消息的日志记录。这个功能对于调试拓扑很有用。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark官方文档》提交Spark应用

提交Spark应用 spark-submit脚本在Spark的bin目录下,可以利用此脚本向集群提交Spark应用。该脚本为所有Spark所支持的集群管理器(cluster managers)提供了统一的接口,因此,你基本上可以用同样的配置和脚本,向不同类型的集群管理器提交你的应用。 打包应用程序依赖 如果你的代码依赖于其他工程,那么你需要把依赖项也打包进来,并发布给Spark集群。这需要创建一个程序集jar包(或者uber jar),包含你自己的代码,同时也包含其依赖项。sbtandMaven都有assembly插件。创建程序集jar包时,注意,要把Spark和Hadoop的jar包都可设为provided;这些jar包在Spark集群上已经存在,不需要再打包进来。完成jar包后,你就可以使用bin/spark-submit来提交你的jar包了。 对于Python,你可以使用spark-submit的–py-files参数,将你的程序以.py、.zip 或.egg文件格式提交给集群。如果你需要依赖很多Python文件,我们推荐你使用.zip或者.egg来打包。 利用spark-submit启动应用 一旦打包好一个应用程序,你就可以用bin/spark-submit来提交之。这个脚本会自动设置Spark及其依赖的classpath,同时可以支持多种不同类型的集群管理器、以及不同的部署模式: ./bin/spark-submit \ --class <main-class> --master <master-url> \ --deploy-mode <deploy-mode> \ --conf <key>=<value> \ ... # 其他选项 <application-jar> \ [application-arguments] 一些常用的选项如下: --class: 应用入口类(例如:org.apache.spark.examples.SparkPi)) --master: 集群的master URL(如:spark://23.195.26.187:7077) --deploy-mode:驱动器进程是在集群上工作节点运行(cluster),还是在集群之外客户端运行(client)(默认:client) --conf: 可以设置任意的Spark配置属性,键值对(key=value)格式。如果值中包含空白字符,可以用双引号括起来(”key=value“)。 application-jar: 应用程序jar包路径,该jar包必须包括你自己的代码及其所有的依赖项。如果是URL,那么该路径URL必须是对整个集群可见且一致的,如:hdfs://path 或者file://path(要求对所有节点都一致) application-arguments: 传给入口类main函数的启动参数,如果有的话。 一种常见的部署策略是,在一台网关机器上提交你的应用,这样距离工作节点的物理距离比较近。这种情况下,client模式会比较适合。client模式下,驱动器直接运行在spark-submit的进程中,同时驱动器对于集群来说就像是一个客户端。应用程序的输入输出也被绑定到控制台上。因此,这种模式特别适用于交互式执行(REPL),spark-shell就是这种模式。 当然,你也可以从距离工作节点很远的机器(如:你的笔记本)上提交应用,这种情况下,通常适用cluster模式,以减少网络驱动器和执行器之间的网络通信延迟。注意:对于Mesos集群管理器,Spark还不支持cluster模式。目前,只有YARN上Python应用支持cluster模式。 对于Python应用,只要把<application-jar>换成一个.py文件,再把.zip、.egg或者.py文件传给–py-files参数即可。 有一些参数是专门用于设置集群管理器的(cluster manager)。例如,在独立部署(Spark standalone cluster)时,并且使用cluster模式,你可以用–supervise参数来确保驱动器在异常退出情况下(退出并返回非0值)自动重启。spark-submit –help可查看完整的选项列表。这里有几个常见的示例: # 本地运行,占用8个core ./bin/spark-submit \ --class org.apache.spark.examples.SparkPi \ --master local[8] \ /path/to/examples.jar \ 100 # 独立部署,client模式 ./bin/spark-submit \ --class org.apache.spark.examples.SparkPi \ --master spark://207.184.161.138:7077 \ --executor-memory 20G \ --total-executor-cores 100 \ /path/to/examples.jar \ 1000 # 独立部署,cluster模式,异常退出时自动重启 ./bin/spark-submit \ --class org.apache.spark.examples.SparkPi \ --master spark://207.184.161.138:7077 \ --deploy-mode cluster --supervise --executor-memory 20G \ --total-executor-cores 100 \ /path/to/examples.jar \ 1000 # YARN上运行,cluster模式 export HADOOP_CONF_DIR=XXX ./bin/spark-submit \ --class org.apache.spark.examples.SparkPi \ --master yarn \ --deploy-mode cluster \ # 要client模式就把这个设为client --executor-memory 20G \ --num-executors 50 \ /path/to/examples.jar \ 1000 # 独立部署,运行python ./bin/spark-submit \ --master spark://207.184.161.138:7077 \ examples/src/main/python/pi.py \ 1000 # Mesos集群上运行,cluster模式,异常时自动重启 ./bin/spark-submit \ --class org.apache.spark.examples.SparkPi \ --master mesos://207.184.161.138:7077 \ --deploy-mode cluster --supervise --executor-memory 20G \ --total-executor-cores 100 \ http://path/to/examples.jar \ 1000 Master URLs 传给Spark的master URL可以是以下几种格式: Master URL 含义 local 本地运行Spark,只用1个worker线程(没有并行计算) local[K] 本地运行Spark,使用K个worker线程(理论上,最好将这个值设为你机器上CPU core的个数) local[*] 本地运行Spark,使用worker线程数同你机器上逻辑CPU core个数 spark://HOST:PORT 连接到指定的Spark独立部署的集群管理器(Spark standalone cluster)。端口是可以配置的,默认7077。 mesos://HOST:PORT 连接到指定的Mesos集群。端口号可以配置,默认5050。如果Mesos集群依赖于ZooKeeper,可以使用 mesos://zk://… 来提交,注意 –deploy-mode需要设置为cluster,同时,HOST:PORT应指向MesosClusterDispatcher. yarn 连接到指定的YARN集群,使用–deploy-mode来指定 client模式 或是 cluster 模式。YARN集群位置需要通过 $HADOOP_CONF_DIR 或者 $YARN_CONF_DIR 变量来查找。 yarn-client YARN client模式的简写,等价于 –master yarn –deploy-mode client yarn-cluster YARN cluster模式的简写,等价于 –master yarn –deploy-mode cluster 从文件加载配置 spark-submit脚本可以从一个属性文件加载默认的Spark属性配置值(Spark configuration values),并将这些属性传给你的应用程序。默认Spark会从 conf/spark-defaults.conf读取这些属性配置。更详细信息,请参考loading default configurations. 用这种方式加载默认Spark属性配置,可以在调用spark-submit脚本时省略一些参数标志。例如:如果属性文件中设置了spark.master属性,那么你就以忽略spark-submit的–master参数。通常,在代码里用SparkConf中设置的参数具有最高的优先级,其次是spark-submit中传的参数,再次才是spark-defaults.conf文件中的配置值。 如果你总是搞不清楚最终生效的配置值是从哪里来的,你可以通过spark-submit的–verbose选项来打印细粒度的调试信息。 高级依赖管理 通过spark-submit提交应用时,application jar和–jars选项中的jar包都会被自动传到集群上。Spark支持以下URL协议,并采用不同的分发策略: file:– 文件绝对路径,并且file:/URI是通过驱动器的HTTP文件服务器来下载的,每个执行器都从驱动器的HTTP server拉取这些文件。 hdfs:,http:,https:,ftp:– 设置这些参数后,Spark将会从指定的URI位置下载所需的文件和jar包。 local:– local:/ 打头的URI用于指定在每个工作节点上都能访问到的本地或共享文件。这意味着,不会占用网络IO,特别是对一些大文件或jar包,最好使用这种方式,当然,你需要把文件推送到每个工作节点上,或者通过NFS和GlusterFS共享文件。 注意,每个SparkContext对应的jar包和文件都需要拷贝到所对应执行器的工作目录下。一段时间之后,这些文件可能会占用相当多的磁盘。在YARN上,这些清理工作是自动完成的;而在Spark独立部署时,这种自动清理需要配置 spark.worker.cleanup.appDataTtl 属性。 用户还可以用–packages参数,通过给定一个逗号分隔的maven坐标,来指定其他依赖项。这个命令会自动处理依赖树。额外的maven库(或者SBT resolver)可以通过–repositories参数来指定。Spark命令(pyspark,spark-shell,spark-submit)都支持这些参数。 对于Python,也可以使用等价的–py-files选项来分发.egg、.zip以及.py文件到执行器上。 更多信息 部署完了你的应用程序后,cluster mode overview描述了分布式执行中所涉及的各个组件,以及如何监控和调试应用程序。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》Spark快速入门

快速入门 本教程是对Spark的一个快速简介。首先,我们通过Spark的交互式shell介绍一下API(主要是Python或Scala),然后展示一下如何用Java、Scala、Python写一个Spark应用。更完整参考看这里:programming guide 首先,请到Spark website下载一个Spark发布版本,以便后续方便学习。我们暂时还不会用到HDFS,所以你可以使用任何版本的Hadoop。 使用Spark shell交互式分析 基础 利用Spark shell 很容易学习Spark API,同时也Spark shell也是强大的交互式数据分析工具。Spark shell既支持Scala(Scala版本的shell在Java虚拟机中运行,所以在这个shell中可以引用现有的Java库),也支持Python。在Spark目录下运行下面的命令可以启动一个Spark shell: Scala Python ./bin/spark-shell Spark最主要的抽象概念是个分布式集合,也叫作弹性分布式数据集(Resilient Distributed Dataset –RDD)。RDD可以由Hadoop InputFormats读取HDFS文件创建得来,或者从其他RDD转换得到。下面我们就先利用Spark源代码目录下的README文件来新建一个RDD: scala> val textFile = sc.textFile("README.md") textFile: spark.RDD[String] = spark.MappedRDD@2ee9b6e3 RDD有两种算子,action算子(actions)返回结果,transformation算子(transformations)返回一个新RDD。我们先来看一下action算子: scala> textFile.count() // Number of items in this RDD res0: Long = 126 scala> textFile.first() // First item in this RDD res1: String = # Apache Spark 再来看下如何使用transformation算子。我们利用filter这个transformation算子返回一个只包含原始文件子集的新RDD。 scala> val linesWithSpark = textFile.filter(line => line.contains("Spark")) linesWithSpark: spark.RDD[String] = spark.FilteredRDD@7dd4af09 把这两个例子串起来,我们可以这样写: scala> textFile.filter(line => line.contains("Spark")).count() // How many lines contain "Spark"? res3: Long = 15 更多RDD算子 RDD action 和 transformation 算子可以做更加复杂的计算。下面的代码中,我们将找出文件中包含单词数最多的行有多少个单词: Scala Python scala> textFile.map(line => line.split(" ").size).reduce((a, b) => if (a > b) a else b) res4: Long = 15 首先,用一个map算子将每一行映射为一个整数,返回一个新RDD。然后,用reduce算子找出这个RDD中最大的单词数。map和reduce算组的参数都是scala 函数体(闭包),且函数体内可以使用任意的语言特性,或引用scala/java库。例如,我们可以调用其他函数。为了好理解,下面我们用Math.max作为例子: scala> import java.lang.Math import java.lang.Math scala> textFile.map(line => line.split(" ").size).reduce((a, b) => Math.max(a, b)) res5: Int = 15 Hadoop上的MapReduce是大家耳熟能详的一种通用数据流模式。而Spark能够轻松地实现MapReduce流程: scala> val wordCounts = textFile.flatMap(line => line.split(" ")).map(word => (word, 1)).reduceByKey((a, b) => a + b) wordCounts: spark.RDD[(String, Int)] = spark.ShuffledAggregatedRDD@71f027b8 这个例子里,我使用了flatMap,map, andreduceByKey这几个transformation算子,把每个单词及其在文件中出现的次数转成一个包含(String,int)键值对的RDD,计算出每个单词在文件中出现的次数 scala> wordCounts.collect() res6: Array[(String, Int)] = Array((means,1), (under,2), (this,3), (Because,1), (Python,2), (agree,1), (cluster.,1), ...) 缓存 Spark同样支持把数据集拉到集群范围的内存缓存中。这对于需要重复访问的数据非常有用,比如:查询一些小而”热“(频繁访问)的数据集 或者 运行一些迭代算法(如 PageRank)。作为一个简单的示例,我们把 linesWithSpark 这个数据集缓存一下: Scala Python scala> linesWithSpark.cache() res7: spark.RDD[String] = spark.FilteredRDD@17e51082 scala> linesWithSpark.count() res8: Long = 19 scala> linesWithSpark.count() res9: Long = 19 用Spark来缓存一个100行左右的文件,看起来确实有点傻。但有趣的是,同样的代码可以用于缓存非常大的数据集,即使这些数据集可能分布在数十或数百个节点,也是一样。你可以用 bin/spark-shell 连到一个集群上来验证一下,更详细的请参考:programming guide. 独立的应用程序 假设我们想写一个独立的Spark应用程序。我们将快速的过一下一个简单的应用程序,分别用Scala(sbt编译),Java(maven编译)和Python。 Scala Java Python 首先用Scala新建一个简单的Spark应用 – 简单到连名字都叫SimpleApp.scala /* SimpleApp.scala */ import org.apache.spark.SparkContext import org.apache.spark.SparkContext._ import org.apache.spark.SparkConf object SimpleApp { def main(args: Array[String]) { val logFile = "YOUR_SPARK_HOME/README.md" // Should be some file on your system val conf = new SparkConf().setAppName("Simple Application") val sc = new SparkContext(conf) val logData = sc.textFile(logFile, 2).cache() val numAs = logData.filter(line => line.contains("a")).count() val numBs = logData.filter(line => line.contains("b")).count() println("Lines with a: %s, Lines with b: %s".format(numAs, numBs)) } } 注意,应用程序需要定义一个main方法,而不是继承scala.App。scala.App的子类可能不能正常工作。 这个程序,统计了Spark README文件中分别包含‘a’和’b’的行数。注意,你需要把YOUR_SPARK_HOME换成你的Spark安装目录。与之前用spark-shell不同,这个程序有一个单独的SparkContext对象,我们初始化了这个SparkContext对象并将其作为程序的一部分。 我们把一个SparkConf对象传给SparkContext的构造函数,SparkConf对象包含了我们这个应用程序的基本信息和配置。 我们的程序需要依赖Spark API,所以我们需要包含一个sbt配置文件,simple.sbt,在这个文件里,我们可以配置Spark依赖项。这个文件同时也添加了Spark本身的依赖库: name := "Simple Project" version := "1.0" scalaVersion := "2.10.5" libraryDependencies += "org.apache.spark" %% "spark-core" % "1.6.0" 为了让sbt能正常工作,我们需要一个典型的目录结构来放SimpleApp.scala和simple.sbt程序。一旦建立好目录,我们就可以创建一个jar包,然后用spark-submit脚本运行我们的代码。 # Your directory layout should look like this $ find . . ./simple.sbt ./src ./src/main ./src/main/scala ./src/main/scala/SimpleApp.scala # Package a jar containing your application $ sbt package ... [info] Packaging {..}/{..}/target/scala-2.10/simple-project_2.10-1.0.jar # Use spark-submit to run your application $ YOUR_SPARK_HOME/bin/spark-submit \ --class "SimpleApp" \ --master local[4] \ target/scala-2.10/simple-project_2.10-1.0.jar ... Lines with a: 46, Lines with b: 23 下一步 恭喜你!你的首个Spark应用已经跑起来了! 进一步的API参考,请看这里:Spark programming guide,或者在其他页面上点击“Programming Guides”菜单 如果想了解集群上运行应用程序,请前往:deployment overview 最后,Spark examples子目录下包含了多个示例,你可以这样来运行这些例子: # For Scala and Java, use run-example: ./bin/run-example SparkPi # For Python examples, use spark-submit directly: ./bin/spark-submit examples/src/main/python/pi.py # For R examples, use spark-submit directly: ./bin/spark-submit examples/src/main/r/dataframe.R 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark官方文档》集群模式概览

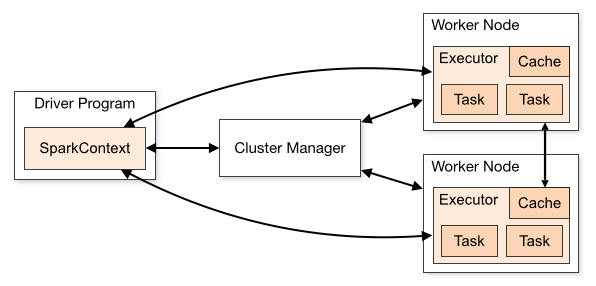
集群模式概览 本文简要描述了Spark在集群中各个组件如何运行。想了解如何在集群中启动Spark应用,请参考application submission guide。 组件 Spark应用在集群上运行时,包括了多个独立的进程,这些进程之间通过你的主程序(也叫作驱动器,即:driver)中的SparkContext对象来进行协调。 特别要指出的是,SparkContext能与多种集群管理器通信(包括:Spark独立部署时自带的集群管理器,Mesos或者YARN)。一旦连接上集群管理器,Spark会为该应用在各个集群节点上申请执行器(executor),用于执行计算任务和存储数据。接下来,Spark将应用程序代码(JAR包或者Python文件)发送给所申请到的执行器。最后SparkContext将分割出的任务(task)发送给各个执行器去运行。 这个架构中有几个值得注意的地方: 每个Spark应用程序都有其对应的多个执行器进程,执行器进程在整个应用程序生命周期内,都保持运行状态,并以多线程方式运行所收到的任务。这样的好处是,可以隔离各个Spark应用,从调度角度来看,每个驱动器可以独立调度本应用程序内部的任务,从执行器角度来看,不同的Spark应用对应的任务将会在不同的JVM中运行。然而这种架构同样也有其劣势,多个Spark应用程序之间无法共享数据,除非把数据写到外部存储中。 Spark对底层的集群管理器一无所知。只要Spark能申请到执行器进程,并且能与之通信即可。这种实现方式可以使Spark相对比较容易在一个支持多种应用的集群管理器上运行(如:Mesos或YARN) 驱动器(driver)程序在整个生命周期内必须监听并接受其对应的各个执行器的连接请求(参考:spark.driver.port and spark.fileserver.port in the network config section)。因此,驱动器程序必须能够被所有worker节点访问到。 因为集群上的任务是由驱动器来调度的,所以驱动器应该和worker节点距离近一些,最好在同一个本地局域网中。如果你需要远程对集群发起请求,最好还是在驱动器节点上启动RPC服务,来响应这些远程请求,同时把驱动器本身放在集群worker节点比较近的机器上。 集群管理器类型 Spark支持以下3中集群管理器: Standalone– Spark自带的一个简单的集群管理器,这使得启动一个Spark集群变得非常简单。 Apache Mesos– 一种可以运行Hadoop MapReduce或者服务型应用的通用集群管理器。 Hadoop YARN– Hadoop 2的集群管理器。 另外,使用Spark的EC2 launch scripts可以轻松地在Amazon EC2上启动一个独立集群。 提交Spark应用 利用spark-submit脚本,可以向Spark所支持的任意一种集群提交应用。详见:application submission guide 监控 每一个驱动器(driver)都有其对应的web UI,默认会绑定4040端口(多个并存会按顺序绑定4041、4042…),这个web UI会展示该Spark应用正在运行的任务(task)、执行器(executor)以及所使用的存储信息。只需在浏览器种打开http://<driver-node>:4040即可访问。monitoring guide详细描述了其他监控选项。 作业调度 Spark可以在应用程序之间(集群管理器这一层面)和之内(如:同一个SparkContext对象运行了多个计算作业)控制资源分配。job scheduling overview描述了更详细的信息。 概念和术语 下表简要说明了集群模式下的一些概念和术语: 术语 含义 Application(应用) Spark上运行的应用。包含了驱动器(driver)进程(一个)和集群上的执行器(executor)进程(多个) Application jar(应用jar包) 包含Spark应用程序的jar包。有时候,用户会想要把应用程序代码及其依赖打到一起,形成一个“uber jar”(包含自身以及所有依赖库的jar包),注意这时候不要把Spark或Hadoop的库打进来,这些库会在运行时加载 Driver program(驱动器) 运行main函数并创建SparkContext的进程。 Cluster manager(集群管理器) 用于在集群上申请资源的 外部服务(如:独立部署的集群管理器、Mesos或者YARN) Deploy mode(部署模式) 用于区分驱动器进程在哪里运行。在”cluster”模式下,驱动器将运行在集群上某个节点;在”client“模式下,驱动器在集群之外的客户端运行。 Worker node(工作节点) 集群上运行应用程序代码的任意一个节点。 Executor(执行器) 在集群工作节点上,为某个应用启动的工作进程;专门用于运行计算任务,并在内存或磁盘上保存数据。每个应用都独享其对应的多个执行器。 Task(任务) 下发给执行器的工作单元。 Job(作业) 一个并行计算作业,由一组任务(Task)组成,并由Spark的行动(action)算子(如:save、collect)触发启动;你会在驱动器日志中看到这个术语。 Stage(步骤) 每个作业(Job)可以划分为更小的任务(Task)集合,这就是步骤(Stage),这些步骤彼此依赖形成一个有向无环图(类似于MapReduce中的map和reduce);你会在驱动器日志中看到这个术语。 转载自并发编程网 - ifeve.com

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册