首页 文章 精选 留言 我的

精选列表

搜索[布隆过滤器],共6713篇文章
优秀的个人博客,低调大师

Diboot 2.1.1发布,新增前端代码生成,CRUD 等不再手写

Diboot 2.1.1版本已于近日发布,带来若干项优化,增加对关联表字段查询条件的支持,Devtools新增前端代码生成等支持,CRUD、导入、导出等不再手写,CRUD的表单类型多达13项,涵盖了常规需求的表单范围,此次更新也对文档结构与内容进行了相关调整,重新录制了上手视频,整理出了playground包等。 一、快速体验 上手视频 playgroud弹药包 官网地址 Gitee Github 二、前端设计器展示 前端生成表选择 前端设计器 前端设计器功能示例 三、案例展示 登录页面示例 列表页示例 表单示例 详情示例 数据上传示例 四、新特性 diboot-core 🔨增强@BindQuery注解,支持跨表字段的动态Join查询 🎉新增@BindFieldList注解,用于绑定某个字段的集合 🎉新增@DataAccessCheckpoint注解,以支持数据权限相关处理 🎉新增@Accept(name)注解,支持非同名字段间的值拷贝 🎉新增:V.equals()对Map类型的比较 🍻优化BindQuery注解,支持BETWEEN绑定List类型对象 🍻优化: 统一注入request到BaseController中,移除方法中的request参数 🍻优化:BaseCrudRestController,类定义中移除VO泛型参数,改为调用时指定VO类,以适配多个VO 🍻优化:批量大小BatchSize支持可配置 🍻优化: @Bind注解的中间表查询解析支持首选调用对应Mapper执行,无Mapper再用JDBC 🍻优化:动态关联的逻辑删除字段的处理 🍻优化:主键不为Long时,查询列表默认是用createTime倒序排序 🍻BaseServiceImpl增加beforeCreateEntity,用以Insert前字段值的填充 🍻BaseExtEntity添加Deprecated注解,不再推荐继承 🍻fastjson默认配置增加条件初始化,首选以用户自定义配置为准 🍻fastjson默认配置移除日期格式的全局配置,以字段指定为准 🐛修复: ContextHelper缓存支持刷新,以解决启用热更新时报错的问题 升级依赖组件: Spring Boot 2.3.1,Mybatis-Plus 3.3.2,fastjson 1.2.72 文档优化完善 diboot-devtools 🎉新增:前端界面设计器,可以根据自己需求定制化地配置前端页面功能项 🎉新增:前端代码生成功能,根据设计器配置结果,可生成带关联的CRUD、导入导出等完整功能 🎉新增:前端代码生成后对前端项目的路由进行自动配置 🎉新增:前端代码生成后对前端项目菜单、按钮权限的自动配置 🎉新增:组件初始化页面,由之前版本的随项目启动自动生成基础代码改为手动点击按钮生成 🎉新增:diboot.devtools.output-path配置项,以简化devtools对于生成后端代码路径的配置 🎉新增:在设置关联字段后,可以设置在当前表中绑定关联的实体 🎉新增:多种与前端相结合的表单类型 🍻优化:优化后端代码生成,支持DTO,ListVO,DetailVO相关生成及绑定 🍻优化:n-n关联的中间表后端代码生成,默认中间表不再生成VO, DTO, Controller相关代码 🍻优化:字段关联配置以点击弹出配置面板呈现 🍻优化:数据结构管理页面,左侧表列表栏可折叠 🍻优化:支持在中文路径、带有空格路径下的项目中启动 🍻优化:提升devtool启动速度 IAM-base 🎉新增:BaseLoginUser用以可登录的用户类继承,并支持附加扩展对象 🎉新增:配置参数diboot.iam.enable-permission-check,结合anno-urls=/**配置,可忽略权限检查,便于开发环境调试 🍻更新:shiro版本至最新,优化shiro相关自动配置 🍻去除extdata相关继承,移除BeanUtils diboot-file 🎉新增@ExcelBindField注解,用于excel导入导出自动转化name-id 🎉新增@ExcelBindDict注解,用于excel导入导出自动转化字典name-value 🎉新增文件上传策略,适配前端项目diboot-**-admin 🍻升级依赖组件版本至当前最新:easyexcel、okhttp 前端: diboot-antd-admin & diboot-element-admin 🎉新增:可通过在data中配置attachMoreList列表,来自动从同一关联数据列表接口获取关联数据列表 🎉新增:列表表格支持字段排序(与后端实现整合) 🎉新增:单文件上传、多文件上传、单图片上传、多图片上传、导入、导出、富文本等基础表单类型在mixins中的支持 🎉新增:v-viewer和图片预览功能 🎉新增:针对这两个基础项目的前端自动生成功能(需使用devtools) 🍻更新:将antdv更新到最新版 🍻更新:将element-ui更新到最新版 🐛修复:表单页在uuid为主键的业务中不能正常更新记录的问题

优秀的个人博客,低调大师

FHS-Framework 开源快速开发平台V2.0.2发布

本版本新增功能: 更容易看懂的操作日志 (审计日志)-基于翻译服务&swagger 类属性注解&AOP+自定义注解 进程日志-(基于websocket+logback filter 无需ssh到服务器,方便线上找问题) Redis 在线管理 FHS Framework简介: FHS Framework是一款真开源,久维护的快速开发平台,平台轻量级,组件可拆装,集成了开发常用的用户角色权限/数据权限 字典,代码生成器,工作流,操作日志,登录日志,swagger,前后端校验,多数据源管理,重复提交拦截器,XSS拦截器,统一异常处理器 常见的功能。 FHS Framework 技术栈: SpringBoot/Cloud(cloud为可选组件,支持单机部署)+Beetl+Mybatis Plus/Jpa+VUE&Element | Easyui +Jetcache + Mysql+Redis FHS Framework 架构图: FHS Framework 思维导图: FHS Framework 特有功能之翻译服务即: 无需表关联,将id 翻译为其他表的title/name FHS Framework 特有功能之PAGEX 即:可实现无JAVA+HTML 只写JS实现复杂CRUD的方案(可自定义后台接口和HTML+JS扩展) 以下代码就是我们一个CRUD的代码 var modelConfig= {title:'月租户类型',pkey:'id',type:'uuid',orderBy:'update_time Desc', namespace:"parking_lease_type",table:'t_park_lease_type',trans:true,db:"park"}; var listPage={ listFieldSett:function(){ return [ {name:'lease_name',title:'类型名称',width:'20%',align:'center'}, {name:'park_id',title:'停车场名称',width:'20%',isJoin:true,namespace:'parking',showField:'transMap.parkName',align:'center'},//自动表关联 {name:'is_disable',title:'是否禁用',width:'10%',formart:'formatRowColor',align:'center',trans:'book',key:'is_disable',showField:'transMap.is_disableName'},//字典翻译 {name:'create_user',title:'创建人',width:'8%',align:'center',trans:'user',showField:'transMap.create_userUserName'},//用户翻译 {name:'create_time',title:'创建时间',width:'10%',align:'center'}, {name:'update_user',title:'更新人',width:'8%',align:'center',trans:'user',showField:'transMap.create_userUserName'}, {name:'update_time',title:'更新时间',width:'10%',align:'center'}, {name:'is_sync',title:'是否已下发',width:'5%',align:'center',trans:'book',key:'yesOrNo',showField:'transMap.is_syncName'},//字典翻译 ]}, filters:function(){ return [ {name:'park_id',type:'select',url:'${path.basePath}/ms/x/parking/findListData', valuefield:'id',textfield:'parkName',title:'停车场'},//下拉插件 {name:'lease_name',type:'input',title:'出入口名称',filterType:'like'}, ]; }, buttons:function(){ return [ //自定义按钮数组 ]; }, disableButtons:function(){ return [];//禁用掉默认提供的按钮 默认提供了增删改查 + 导出 }, otherFunctions:function(){ return {}//其他的自定义方法 } }; var add={ formFields:function(){//表单内容 return [ {name:'park_id',type:'select',url:'${path.basePath}/ms/x/parking/findListData', valuefield:'id',textfield:'parkName',title:'停车场',required:true,},//一个下拉 {name:'lease_name',title:'名称',required:true,type:'input'},//一个input {name:'is_disable',title:'是否禁用',type:'switch',dft:false},//一个开关滑块 {name:'is_sync',title:'是否下发',type:'hide'},//一个隐藏域 ]; }, otherFunctions:function(){ return { ready:function(){ }, loadSuccess:function(info){//加载后台数据成功的事件 }, onSave:function(){//保存前执行方法 $('#isSync').val(0); }, saveSucess:function(){//保存成功执行方法 }, saveError:function(){//保存失败执行的方法 }, } } } 系统预览

优秀的个人博客,低调大师

Source Insight 3.X 标签插件v1.0发布

Source Insight可以说是一款程序员必备的开发/阅读源码工具,美中不足的是SI没有标签栏,多个源码之间切换很不方便,于是我就乘闲暇之余写了该作品sihook:标签插件;不过严格意义上来说sihook并不算是插件,而是一个内挂:) 如何给Source Insight添加标签栏呢?可以查看orbit的博客<<给Source Insight做个外挂>>系列;感谢orbit的分析,而且orbit再很早的时候就已经做了一个标签插件,我也下载和试用了他的插件,不过orbit的像个外挂,而我的更像内挂:),由于很久没写win程序,对windows消息也不熟悉,手头连spy++都没有,开始以为要hook住SI的某个内部函数来挂钩子窗口的创建和销毁,看了orbit的博客后发现原来SI是个标准的MDI程序,子窗口的创建和销毁都是WM_MDI*的消息,那事情就简单了,只要替换原SI的wndproc就可以实现我们想要的事情.orbit的插件居然是用mfc做的dll,代码中还有线程和定时器,用起来还要个loader来加载,使用起来不太方便,在线程中操作UI怎么看都觉得有点别扭,既然已经注入SI程序了,那我们就因该做的更彻底更底层一点:). 经过几年的编程积累,也有点感悟,越来越觉得c++太繁杂了,而c的清晰精简让我越来越欣赏,一段c代码能很好表达清楚的逻辑,c++开发者喜欢绕上一大圈来实现,更不提那些变形的VC和我从来没搞懂过的MFC,几年以前接触MFC依葫芦画瓢的时候总是搞不懂MFC在干些什么,现在回过头来看,MFC完全就是一个失败的设计.好了,不吐槽c++和该死的VC+MFC了,这次sihook用c开发,gcc编译,偷懒没装MSYS用CodeBlocks做IDE,Makefile都省了:) 下面我简单介绍一下sihook的实现原理: 1,插件的自动加载msimg32 几年前dll都是用CreateRemoteThread方法来加载,就是必须要有个exe的loader,而现在有了msimg32延迟加载漏洞,腰不酸了腿不疼了,加载外挂更方便了:),具体原理我就不多介绍了,网上一搜一大把. 2,肢解SI之siframe SI主窗体是siframe,由于msimg32是延迟加载,由hook CreateWindowEx调试发现,当我们的dll载入的时候,siframe和mdiclient已经创建了,而si_sw未创建,那么我们直接得到当前进程的HWND就是siframe的HWND了,然后SetWindowLong替换窗口过程,只关心WM_SETTEXT消息,WM_SETTEXT设置标题的时候我们在后面加上"加强版"的字样,然后以siframe为父窗体创建我们的systabcontrol32控件. 3,肢解SI之mdiclient mdiclient是SI中最重要的一个窗口,它管理着源码窗口的创建销毁,首先用FindWindowEx得到mdiclinet的句柄,然后SetWindowLong替换窗口过程,这里面要处理的消息有WM_WINDOWPOSCHANGING;WM_MDICREATE;WM_MDIDESTROY;WM_MDIACTIVATE; WM_WINDOWPOSCHANGING是窗口大小改变的消息,这时候要处理tab的大小和mdiclient自身的大小,要在oldwndproc执行之前处理; WM_MDICREATE;WM_MDIDESTROY;WM_MDIACTIVATE;要在oldwndproc执行之后处理,这样就可以直接拿到子窗口的句柄处理了. WM_MDICREATE消息用FindWindowEx得到新创建的si_sw源码窗口的句柄,替换窗口过程 WM_MDIDESTROY消息直接能拿到HWND,同步删除tab标签 WM_MDIACTIVATE也能直接拿到HWND,同步激活tab标签 4,肢解SI之si_sw si_sw子窗口就是源码显示窗口了,这个窗口我们只关心WM_SETTEXT消息,得到当前源码的标题(包括标题的变更),直接显示在tab上,这样就不用一个定时器去不停的比较了; 5,tabctl控件 为了精简,直接用sdk编程,只能用系统自带的systabcontrol32控件来做标签了,我封装了一层接口方便上层调用,包括增加,删除,双击关闭,改变选项卡颜色,调整位置高度等.说起来这是我第一次用systabcontrol32这个控件,做的很难看,如果有sdk美化高手知道怎么做的漂亮一点,可以给我留言,再此先表示感谢.另外双击关闭标签的同时要关闭源码窗口,看orbit的介绍要发WM_CLOSE消息,而且他的代码确实是这么实现的,并且有效,但是我怎么试都不灵,最后用OD一调试,发现SI自己发的是WM_SYSCOMMAND消息,WPARAM参数是SC_CLOSE,于是我也用SC_CLOSE消息来关闭文档:) OK,基本原理就是上面几点,理清楚了制作标签内挂就很容易了,整个工程不算tabctl控件源码不超过10个函数,以下是效果图和插件下载包 sihookv1.0下载:[点我] 安装:解压sihook.zip两个dll放到SI目录即可 删除:删除SI目录msimg32.dll和sihook.dll即可 源代码地址:https://github.com/redxu/sihook 注:测试发现某些XP sp2装了某些卫士的机器会无法使用此插件,msimg未加载,原因调查中
优秀的个人博客,低调大师

华平监控系统布智慧天网,守一方平安

2016年7月25日中午12:42分,新乡市新世纪网吧门口,一名中年男子鬼鬼祟祟的探头探脑,看四下无人,他在网吧门口停放的电动车旁蹲下,几分钟之后,他旁若无人的骑着盗窃得来的电动车,消失在路口。 男子大概没有想到,在无人的小巷,有一双“眼睛”始终注视着他,并忠实记录了他的犯罪行为——那就是遍布新乡市重点道路口、治安刑事案件多发地、交通要道等区域的“360度‘天眼’视频监控系统”。 民警接获报案后,通过“天眼”视频系统,成功提取到一张较为清晰的人像截图。紧接着,民警利用人脸识别系统对嫌疑人截图照片进行比对,迅速识别出该嫌疑人为吸毒、盗窃前科人员李某。 李某居无定所,但民警通过视频大数据系统的信息检索功能,仍然锁定了其重点活动区域,并将该区域确定为每日重点巡查区域。 8月6日晚19时许,民警巡屏发现嫌疑人出现,立即与110指挥中心联系,通过监控中心与路面民警的联动配合,对嫌疑人实时追踪,成功将嫌疑人抓获。根据前期收集的图侦线索,带破案件5起。 这起案件最后能够成功破获,视频监控系统可谓功不可没。“天眼”的建设和不断升级,给犯罪分子更大震慑,成为公安机关维护社会稳定的一柄利剑。 由华平股份承建的新乡市城区视频监控系统,通过在重点道路口、要害部位、治安、刑事案件多发地段、交通要道等安装高清监控点,构建分层防控体系和城区网格化的防控网络,形成“外成圈、内成网、点连线、线保面”监控格局,让犯罪分子无处藏身! 系统与警用地理信息(PGIS)、综合研判、情报信息等公安内部相关信息系统或平台,实现有效关联和对接,为各部门、各警种提供实战支撑。同时,系统还与省公安厅视频监控管理平台成功对接,从而实现互联互通。省厅等上级部门可对新乡市监控平台的图像资源进行查看、控制、存储等操作。 新乡市公安局监控中心自2016年7月正式启动以来,短短2个月内主动发现案件线索133起,服务基层办案单位调取视频153起,直接通过视频巡逻破获各类案件11起,抓获犯罪嫌疑人5名,网上逃犯1名。 新乡视频监控项目的建成和投入使用,实现了新乡天网“全域覆盖、全网共享、全时可用、全程可控”的目标,大大提升了新乡群众安全感,为建设平安新乡作出了贡献。 本文转自d1net(转载)

优秀的个人博客,低调大师

SmartCall v1.0.4发布 支持端到端全双工对话

📖 项目简介 SmartCall 是一套基于 AI 大模型 + Asterisk 通信引擎构建的新一代智能客服呼叫中心系统。系统深度融合了 AI 语音机器人、智能 IVR 流程编排、端到端双工对话模型、实时语音识别(ASR)、语音合成(TTS)、大模型意图识别 等核心能力,为企业提供从呼入智能应答到智能外呼的全链路 AI 客服解决方案。 无论是电商售后、金融催收、教育招生还是企业客服,SmartCall 都能通过灵活的流程编排和强大的 AI 能力,帮助企业大幅降低人工成本、提升服务效率与客户满意度。 1.0.4发布特性: ✨ 新增端到端全双工对话 支持自定义扩展端到端对接 优化asterisk音频流为实时流传输 修改删除租户的BUG 新增端到端变量配置 修复部分线路呼入时获取用户手机号错误问题 修复坐席在线时偶发前端下线问题 修复已知BUG ✨ 核心能力 大模型意图识别 — 集成通义千问(DashScope)、DeepSeek 等主流大模型,通过 Prompt 工程实现精准的来电意图分类,支持自定义意图配置 AI 智能体对话 — 内置知识库智能体集成能力(已对接 MaxKB),AI 机器人可基于企业知识库进行多轮智能问答,支持按来电号码自动维护对话上下文、智能体选择与会话管理。架构上采用 NodeGranter 插件化设计,可扩展对接 Dify、Coze、FastGPT 等任意 AI Agent 平台 正则 + 模型双引擎 — 意图判断支持正则表达式快速匹配与 AI 模型深度识别的双重策略,兼顾响应速度与识别精度 情绪分析 — 集成阿里云 NLP 情感分析能力,实时感知客户情绪变化,负面情感自动升级至人工坐席 AI 信息提取 — 基于大模型自动从客户对话中提取姓名、地址、订单号等结构化关键信息,无需人工录入 端到端实时对话模型支持 — 原生支持端对端实时语音大模型,策略模式对接阿里云百炼 Omni / Audio 系列、豆包等厂商,支持流式语音交互、服务端 VAD 打断与采样率自动适配 项目地址 项目地址:https://gitee.com/gdzWork/SmartCall 项目演示地址: https://smartaster.qidiangk.com 官网:https://qidiangk.com

优秀的个人博客,低调大师

lamp-cloud 5.6.1发布,依赖更新与体验增强双加持

更新日志 🎉 版本核心依赖 - spring-boot-starter-parent:3.5.6 - spring-framework.version:6.2.12+ - nacos.version:3.1.0+ - spring-boot-admin.version:3.5.5+ - smart-doc.version:3.1.2+ - hutool.version:5.8.41+ - lombok.version:1.18.42+ - mybatis-plus.version:3.5.14+ - fastjson2.version:2.0.59+ - fastexcel.version:1.3.0+ - 前端框架:Vxe-PC-UI 4.9.29 + Vxe-Table 4.16.11 #🎉 五大核心功能升级 导航栏吸顶:首选项导航栏支持外观/布局/快捷键吸顶悬浮 水印自定义:动态配置水印文案,支持一键清除 动画交互:主题切换/语言选择/全屏按钮新增丝滑动画 权限控制:表单字段动态权限校验 组件增强:Input输入框新增清除按钮 效果截图 体验网址 vben2 版 vben5 版 soybean 版 数据源模式 点我体验 点我体验 点我体验 字段模式 点我体验 点我体验 点我体验 关于 lamp 灯灯(简称灯,英文名:lamp),她是一个项目集,为满足高内聚低耦合设计原则,将一个大项目拆解为以下几个子项目: lamp-util:后端工具集 lamp-cloud:基于 Spring Cloud 实现的后台 lamp-boot:基于 Spring Boot 实现的后台 lamp-job:基于 xxl-job 集成本项目的分布式定时任务 lamp-generator:代码生成器 lamp-web:前端 lamp-cloud简介 lamp-cloud是基于SpringCloudAlibaba、SpringCloud、SpringBoot开发的微服务中后台快速开发平台,支持jdk17、jdk11和jdk8,专注于多租户 (SaaS 架构) 解决方案,亦可作为普通项目(非 SaaS 架构)的基础开发框架使用,目前已实现数据库隔离、字段隔离等租户隔离方案以及非租户隔离的解决方案。 她拥有自研 RBAC(基于租户应用的角色权限控制体系)、网关统一鉴权、数据权限、优雅缓存解决方案、防缓存击穿、前后端统一表单校验、字典数据自动回显、可视化前后端代码生成器、支持多种文件存储、支持多种短信邮件发送接口、灰度发布、防 XSS 攻击、防 SQL 注入、分布式事务、分布式定时任务等功能;支持多业务系统并行开发,支持多服务并行开发,是中后台系统开发脚手架的最佳选择。 lamp-cloud 代码简洁,注释齐全,架构清晰,非常适合个人学习以及中小企业作为基础框架使用。采用 Spring Cloud Alibaba、SpringBoot、Mybatis、Seata、Sentinel、RabbitMQ、FastDFS/MinIO、SkyWalking 等主要框架和中间件。本项目旨在实现基础框架能力,不涉及具体业务。 关注项目 官网:https://tangyh.top 源码:https://github.com/dromara/lamp-cloud 源码:https://gitee.com/dromara/lamp-cloud

优秀的个人博客,低调大师

DistilQwen2.5发布:通义千问蒸馏小模型再升级

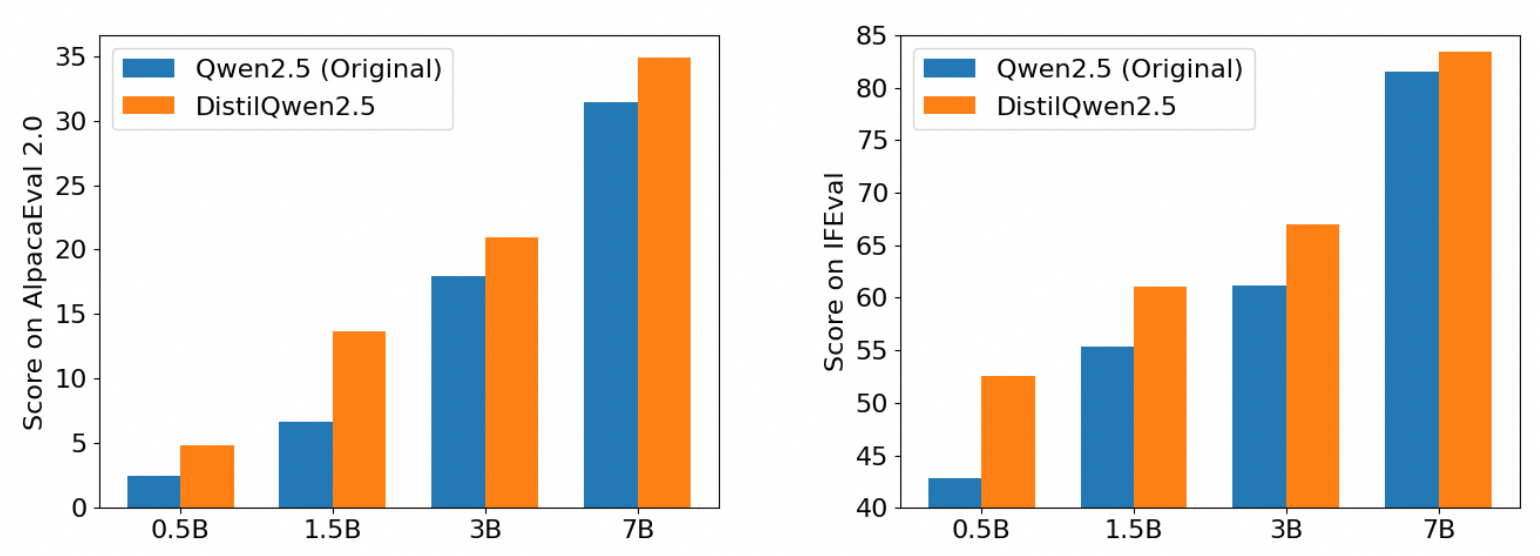
引言 因高计算成本和复杂性,在例如移动设备和边缘计算场景等资源有限的环境中,限制了大语言模型的普及。如何在保留模型性能的同时提高计算效率并降低部署成本,已成为研究和工业界必须面对的关键挑战。 在此背景下,我们正式推出基于Qwen2.5的轻量化大模型系列DistilQwen2.5。该模型通过创新的双层蒸馏框架实现突破,基于数据优化策略重构指令数据集强化模型理解能力,并且采用参数融合技术实现细粒度知识迁移。实验表明,DistilQwen2.5 在多项基准测试中性能超越原模型,同时显著降低计算资源消耗。 DistilQwen2.5 蒸馏模型的 Checkpoint 已在Hugging Face及Model Scope全面开源。本文将介绍 DistilQwen2.5 的蒸馏算法、效果评测,以及 DistilQwen2.5 模型在阿里云人工智能平台 PAI 上的使用方法,并提供在各开源社区的下载使用教程。 DistilQwen2.5中的知识蒸馏技术 本节中,主要描述DistilQwen2.5模型训练中使用的黑盒化和白盒化的知识蒸馏技术。其中,DistilQwen2.5模型蒸馏的算法框架如下图所示。 指令数据搜集层 DistilQwen2.5模型蒸馏算法的首要步骤是指令数据收集层,旨在搜集大量高质量指令数据,以供后续教师模型使用。为了确保数据的多样性和高效性,整合了多个来源的数据集,包括开源数据集Magpie、Openhermes和Mammoth 2等。此外,还引入了大量私有合成数据集,以丰富指令样本的多样性。为有效整合数据源,确保指令语言主要涵盖中英文,同时对指令进行了难度打分和任务相关的重新抽样。 首先,在许多应用场景中,模型需要能够跨语言工作。为应对中文数据相对不足的挑战,利用Qwen-max进行了数据扩展。通过设计特定的Prompt,让Qwen-max生成了内容不同但任务类型相同的中英文指令,从而平衡了中英文数据的比例。 其次,任务多样性是实现模型全面能力的关键环节。借鉴WizardLM中对大语言模型能力的评估维度,在DistilQwen2模型蒸馏中继续使用之前的方法,定义了33种任务类型,涵盖广泛的应用场景。我们创建了一个包含3万条任务的分类数据集,并基于Deberta v3训练了任务分类器。该分类器在测试集上的准确性与ChatGPT相当,使得指令数据标注具备高度的可靠性和准确性。通过如此精细的任务标签,能够更好地控制数据集中不同任务类型的分布,确保模型在训练过程中获得全面和深入的能力。 此外,在评估指令数据的难易程度时,采用了LLM-as-a-Judge的范式。利用教师模型对指令执行的准确性、相关性、帮助性和详细程度进行评分,这为模型提供了一种客观的指令难度评估机制。具体而言,我们引入了一种名为模型拟合难度分数(MFD Score)的指标来衡量每条指令在蒸馏训练中的价值。MFD分数是根据学生模型得分与教师模型得分之间的差值计算得出的。如果某条指令的MFD分数较高,则说明该指令对蒸馏训练更具价值,而低难度的指令则可以从训练集中移除。 指令遵循优化层(黑盒化蒸馏) 黑盒化蒸馏主要依赖于教师模型的输出,而非其内部表征。我们选择采用黑盒化蒸馏算法的原因有两个:首先,这种算法的训练速度比白盒化蒸馏更快,有助于节省训练时间和计算资源;其次,黑盒化蒸馏适用于开源和闭源的大型模型。在指令遵循优化层中,我们并不直接通过蒸馏微调的方法来优化学生模型,而是利用教师大模型,首先引入一种Multi-Agent模式,以对指令数据进行大幅度提升和优化。 指令扩展:在这一过程中,教师大模型充当指令扩展的Agent,生成与输入指令相似的新指令。在扩展指令时,我们要求该Agent始终保持原始任务的自然语言处理类别不变,以避免产生不必要的幻觉。例如,当输入的指令为“简要概述牛顿第一运动定律”时,输出可以是“解释开普勒第三定律的含义”,而不是“介绍爱因斯坦的生平”。 指令选择:指令选择Agent的目标是筛选出对模型训练具有高度价值的指令,筛选标准包括信息量、实用性和泛化潜力等。这一过程不仅保证了增强数据集的质量,也有效过滤了对模型蒸馏训练帮助不大的指令数据。 指令改写:在经过指令扩展和选择后,指令改写Agent进一步提升数据的质量和多样性,同时保持指令意图不变。例如,将“提供气候变化经济影响的总结”改写为“解释气候变化如何影响经济”。此外,对于复杂任务如逻辑推理、数学问题和编程等,我们鼓励生成链式思维(Chain-of-Thought, CoT)输出,以进一步提升小模型的推理能力和解决问题的逻辑性。 黑盒化蒸馏过程遵循监督学习范式,以增强的指令响应对作为训练样本。学生模型能够在有限的参数量下,充分吸收和理解来自大模型的知识。这种方法不仅增强了学生模型解决任务的能力,也使其能够在多任务环境中取得更好的效果。 知识融合优化层(白盒化蒸馏) 黑盒化知识蒸馏仅依赖教师模型输出的概率最高的token,而白盒化知识蒸馏则更关注教师模型输出logits的分布,从而为学生模型提供更丰富的信息。通过模仿教师模型的logits分布,白盒化蒸馏可以更有效地传递知识,进一步提升学生模型的性能。 传统的白盒化蒸馏算法对于工业大规模数据的蒸馏场景是不可行的,原因有三个: GPU内存消耗过高:如果在训练学生模型的同时进行教师模型的前向传播,所需的计算资源将显著增加。对于拥有32B或者72B参数的巨型教师模型,GPU内存甚至可能无法承受。这种情况严重限制了模型的训练效率。 长时间的存储和读取:对于离线生成的教师模型logits,其存储和读取通常需要占用大量的时间。尤其是当数据集非常庞大时,磁盘空间的消耗也变得难以忽视。这种高昂的存储和读取开销成为了系统瓶颈。 词汇表不匹配问题:教师模型和学生模型通常使用不同的词汇表,导致它们的logits张量无法直接匹配。这种不匹配阻碍了知识的准确传递,降低了蒸馏过程的有效性。 我们在教师模型的输出中观察到,前10个token的概率之和几乎为1,这表明教师模型的所有知识几乎都包含在前10个token中。因此只保存教师模型每个序列位置中概率最大的10个token的概率。由此我们构建了一个对于大模型和大数据量下可扩展的白盒化知识蒸馏系统,支持以下功能: DistilQwen2.5模型效果评测 在本节中,从多个角度评测DistilQwen2.5蒸馏小模型的实际效果;同时,我们对使用不同规模的教师大模型进行模型融合训练的效果进行评测。 模型综合能力评测 我们在多个权威指令遵循评测基准上测试了DistilQwen2.5蒸馏小模型的能力。AlpacaEval 2.0使用GPT-4作为评判员来评估生成回复的质量。特别地,AlpacaEval 2.0引入了长度控制的胜率(Length-controlled Win Rates),以避免GPT-4偏向于较长回复,从而减少评估偏差。MT-Bench是包括来自8个类别的80个任务,同样使用GPT-4作为评判标准,并提供两种不同的评估模式:多轮对话和单轮对话。IFEval专注于使用“可验证的指令”进行模型效果的评估,这使得结果更加客观。根据所使用的Prompt不同,IFEval提供了instruction-loose和strict-prompt两种评估模式。如下表所示,DistilQwen2.5在0.5B、1.5B、3B和7B四个参数量级的模型中,与原始Qwen2.5模型的效果进行了对比。可以看出,本文描述的知识蒸馏算法显著提升了现有大语言模型的指令遵循能力,并在多个评测基准上取得了一致而明显的效果提升。 模型细粒度能力评测 我们进一步使用MT-bench基准测试对DistilQwen2.5模型的各项细粒度能力进行评测,例如文本生成、代码生成、数学问题、角色扮演等,每个任务都旨在从不同的角度测试模型的能力。通过对DistilQwen2.5模型模型在MT-bench基准测试中的表现进行分析,我们可以准确量化DistilQwen2.5模型在各个方面的细粒度能力,并将其与原始模型进行比较。从实验结果可以看出,在绝大部分细粒度能力层面,DistilQwen2.5模型比原始Qwen2.5模型有明显的提升。下图给出0.5B和1.5B模型在各个细粒度能力的对比。 与其他模型能力对比 为了横向比较同期发布的不同参数规模的模型效果,下表展示了这些模型在AlpacaEval 2.0的评测结果,对于每个参数量级,从低到高进行排序。我们重点对比了Qwen2、Qwen2.5以及先前发布的DistilQwen2模型。对于英文模型,我们也横向对比Llama、Phi3、Mistral等系列模型。模型效果排序如下所示。可以看出,DistilQwen2.5系列模型对比其他各类模型,具有很高的性价比,其效果接近了参数量接近或大于其参数量两倍的模型。 模型融合实验评测 经过对大模型logtis生成速度的优化,我们对logits的推理速度提升了至少4倍,节省存储空间为原本的1/1000。使用5万条数据时,时间具体耗时如下: 针对不同训练数据量级(1K/10K/100K/200K)下和不同教师模型(7B/14B/32B/72B)大小的蒸馏效果,我们也进行了探索,效果如下图所示,从中可以得到一些关于蒸馏数据量和教师模型参数量大小的结论: 数据量和模型大小都存在边际效应,随着数据量的成倍提升,效果提升减缓;随着模型规模的上升(32B/72B)并没有对比14b模型带来更明显的提升。这表明,学生模型和教师模型在参数量差距过大的情况下,对教师模型的学习能力有限。 在小数据量(~1K)或充分数据量(>200K)的情况下,提升教师模型规模带来的效果提升不明显。在10K-100K条数据量下,不同规模的教师模型提升较为明显。这可能是由于在小数据的场景下,学生模型对教师模型的能力还没有充分学习;而在大数据场景下随着数据量大饱和,学生模型已经能从数据中学习到充分的知识。 模型输出案例 对于同一指令,我们对比了DistilQwen2.5-7B-Instruct和GPT-4o、DeepSeek-V3、Qwen2.5-Max、Qwen2-7B-Instruct回复对比结果,特别是知识性和逻辑推理类问题。从输出结果可以看出,DistilQwen2.5-7B-Instruct的输出在一些场景上具有更好的事实正确性和逻辑推理能力。 示例一:知识性问题 示例二:知识性问题 示例三:逻辑推理类问题 模型下载和使用 DistilQwen2.5在阿里云人工智能平台PAI上的实践 以下HuggingFace transformers库为例,简要介绍如何在PAI-DSW上使用DistilQwen2.5模型。首先需要保证PAI-DSW镜像内transformers版本大于等于4.37.0,否则会在加载模型时报错: KeyError: 'qwen2' 以DistilQwen2.5-7B-Instruct为例,我们可以使用如下代码调用模型: from transformers import AutoModelForCausalLM, AutoTokenizer model_name = "alibaba-pai/DistilQwen2.5-7B-Instruct" model = AutoModelForCausalLM.from_pretrained(model_name) tokenizer = AutoTokenizer.from_pretrained(model_name) prompt = "请给我简单介绍一下杭州西湖。" messages = [ {"role": "system", "content": "You are a helpful assistant."}, {"role": "user", "content": prompt} ] text = tokenizer.apply_chat_template( messages, tokenize=False, add_generation_prompt=True ) model_inputs = tokenizer([text], return_tensors="pt").to(model.device) generated_ids = model.generate( **model_inputs, max_new_tokens=512 ) generated_ids = [ output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids) ] response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0] print(response) DistilQwen2.5在开源社区的下载 我们在HuggingFace和ModelScope上开源了我们蒸馏后的模型,分别为alibaba-pai/DistilQwen2.5-0.5B-Instruct、alibaba-pai/DistilQwen2.5-1.5B-Instruct、alibaba-pai/DistilQwen2.5-3B-Instruct和alibaba-pai/DistilQwen2.5-7B-Instruct。以HuggingFace为例,用户可以使用如下代码下载这两个模型: from huggingface_hub import snapshot_download model_name = "alibaba-pai/DistilQwen2.5-0.5B-Instruct" snapshot_download(repo_id=model_name, cache_dir="./DistilQwen2.5-0.5B/") model_name = "alibaba-pai/DistilQwen2.5-1.5B-Instruct" snapshot_download(repo_id=model_name, cache_dir="./DistilQwen2.5-1.5B/") model_name = "alibaba-pai/DistilQwen2.5-3B-Instruct" snapshot_download(repo_id=model_name, cache_dir="./DistilQwen2.5-3B/") model_name = "alibaba-pai/DistilQwen2.5-7B-Instruct" snapshot_download(repo_id=model_name, cache_dir="./DistilQwen2.5-7B/") 数据集下载和使用 为了支持社区开发者在微调DistilQwen2.5模型时避免“灾难性遗忘”(catastrophic forgetting)现象,我们开源了部分用于模型训练的数据集。这一数据集旨在为模型微调提供坚实的基础,有助于提升模型在新任务上的适应性的同时,保持在之前任务上的性能。此外,在微调其他类似大语言模型时,也可以利用这一数据集进行指令遵循能力的增强。以下是关于数据集的信息和下载使用说明。 数据格式等相关信息 该部分数据包含了数学、代码、知识问答、指令遵循、创意生成等内容,总数据量为100K。用户可以在用自己的数据对模型微调时加入DistilQwen_100K,或者其子集,从而使其在下游任务表现良好的同时不至于丧失其通用能力,保证模型的泛化性。数据格式为JSON格式,示例数据如下: [ { "instruction": "The ratio of the number of molar teeth in the human upper jaw at the age of 6 is 2:1 compared to number of incisors teeth. There are total 8 incisors in the human mouth. What is the number of molar teeth in the human upper jaw for this age group?", "output": "## Step 1: Determine the total number of incisors in the upper jaw.\nSince there are a total of 8 incisors in the human mouth and the incisors are evenly distributed between the upper and lower jaw, we divide the total number of incisors by 2 to find the number in the upper jaw. So, 8 incisors / 2 = 4 incisors in the upper jaw.\n\n## Step 2: Use the given ratio to find the number of molar teeth in the upper jaw.\nThe ratio of molar teeth to incisors in the upper jaw at the age of 6 is given as 2:1. This means for every 1 incisor, there are 2 molar teeth. Since we determined there are 4 incisors in the upper jaw, we multiply this number by 2 to find the number of molar teeth. So, 4 incisors * 2 = 8 molar teeth.\n\nThe final answer is: $\\boxed{8}$" }, { "instruction": "This is the text of a lecture I am giving tomorrow. Can you go over it and make recommendations to improve clarity and flow?", "output": "I'd be happy to help you review your lecture text and provide suggestions for improvement. Please go ahead and share the text with me, and I'll get started.\n\nAdditionally, it would be helpful to know a bit more about the context of your lecture. Could you tell me:\n\n* What is the topic of your lecture?\n* Who is your audience (e.g. students, professionals, general public)?\n* What is the purpose of the lecture (e.g. to inform, to persuade, to educate)?\n* How long is the lecture supposed to be?\n\nThis information will help me provide more targeted and relevant feedback." } ] 数据集在开源社区的下载 该数据集已上传至ModelScope,用户可以使用ModelScope提供的脚本和命令行工具自行下载使用该数据集。 #验证SDK token from modelscope.hub.api import HubApi api = HubApi() api.login('your_token_id') #数据集下载 from modelscope.msdatasets import MsDataset ds = MsDataset.load('PAI/DistilQwen_100k') 小结与未来工作 在当前人工智能领域的快速发展中,大语言模型(LLMs)凭借其出色的自然语言理解和生成能力,已在多个应用场景中得到广泛应用。然而,随着这些应用的扩展,其高计算成本和复杂性在资源有限的环境下的接受度逐渐降低,成为行业普及的一大瓶颈。为了解决这一问题,我们提出了DistilQwen2.5轻量化模型系列,依托Qwen2.5大模型,通过一系列创新的知识蒸馏技术,使得模型在保留原有优越性能的同时显著降低了计算资源需求。为了进一步促进技术的推广与应用,我们将DistilQwen2.5模型的Checkpoint以及部分训练数据集开源至Hugging Face和Model Scope等社区,力图为开发者和企业提供更为便捷的操作环境,助力他们在实际项目中迅速实现技术落地。在未来,我们将继续致力于优化并发布DistilQwen系列模型,并且针对特定领域(如深度推理等)进行模型的定制化优化,使得DistilQwen系列模型在多样化需求下展现出更强的专业能力。 参考资料 相关发表论文 Yuanhao Yue, Chengyu Wang, Jun Huang, Peng Wang. Building a Family of Data Augmentation Models for Low-cost LLM Fine-tuning on the Cloud. COLING 2025 Yuanhao Yue, Chengyu Wang, Jun Huang, Peng Wang. Distilling Instruction-following Abilities of Large Language Models with Task-aware Curriculum Planning. EMNLP 2024 技术文章 DistilQwen2:通义千问大模型的知识蒸馏实践:https://developer.aliyun.com/article/1633882 DistilQwen2蒸馏小模型的训练、评测、压缩与部署实践:https://help.aliyun.com/zh/pai/user-guide/training-evaluation-compression-and-deployment-of-distilqwen2 大语言模型数据增强与模型蒸馏解决方案:https://help.aliyun.com/zh/pai/user-guide/llm-data-enhancement-and-model-distillation-solution

优秀的个人博客,低调大师

开源工具Dopamine 2.0发布:支持越狱苹果iOS 15.0-16.6.1

IT之家 2 月 17 日消息,Dopamine 2.0 版本更新,支持越狱多款 iPhone 和 iPad 设备。 2.0.5 Improve kfd reliability by memory hogging, also fixes support for devices with 16GB RAM, contributed by@dhinakg Fix an issue where /var/jb/var/mobile would get the wrong file permissions on new bootstraps (Fixed retroactively on next rejailbreak) Improve the way injection into problematic processes is blocked Block injection intodataaccessdbecause it seemed to be crash looping for some users Fix verbose logs not showing in error log when they aren't enabled Actually print the error that caused the failure in the error log........ Fix app crash on iPads when sharing log Fix a random app crash while jailbreaking 2.0.4 Actually fix libkrw not working (The 2.0 changelog was lying...) 2.0.3 Fix localization fallback not properly working (would show placeholder instead of english when no localization for the selected language was available) Don't attempt jbupdate if the phone is not already jailbroken Fix an issue where PAC primitives would get lost during a jbupdate, causing the launch of a sideloaded Dopamine app to trigger a kernel panic on <15. 2.0.2 Fix new bootstrap getting created every rejailbreak (super dumb 2.0.1 regression...) 2.0.1 Fix XPF not working on 15.0.x arm64e Fix an app crash during the jailbreak process Fix an app crash when launching the app on a jailbreak that is not Dopamine (this is still not really supported) 2.0 Add support for arm64e iOS 15.5 - 16.5.1 Add support for arm64 15.0 - 16.6.1 (A8 not supported for now) (by@kok3shidoll) Support installation via sideloading (Only works on non beta iOS versions using libgrabkernel for now, also a few features are only supported when installing via TrollStore) Rewrite the jailbreak app in Objective C with flexibility in mind (UI has been written by@tomt000) Add exploit picker (only kfd for now, more exploits for older versions will be added later) Add themes to app (in app + icon) Add support for using NSTask from tweaks, previously was unsupported, calling it from apps and other processes is also possible but you will have to calldopamine_fix_NSTask()yourself beforehand Remove libfilecom, switch to using XPC for handoff communication Deprecate jailbreakd in favor of launchd hook Instead of boot_info.plist, all jailbreak related info is now stored inside launchd and can be retrieved via XPC Rework kcall handoff to be stateless Rework trustcaching to be stateless Replace kernel patchfinder with XPF (https://github.com/opa334/XPF) Fix various issues with trustcaching Include libroot provider library (https://github.com/opa334/libroot) Make libkrw actually work (Yes, it was broken all throughout 1.x and nobody noticed) Dopamine (多巴胺)越狱工具由巨魔商店 TrollStore 的作者 opa334 联合 ellekit 开发,基于 Fugu15 越狱代码,是公开的开源越狱工具。 IT之家基于推文内容,Dopamine 2.0 更新适用于 arm64(A9 及更新芯片)设备,此外还适用于 M1 / M2 的 iPad 型号。 对于搭载 A12-A14 的 iPhone 设备,支持 iOS 15.0 到 iOS 16.5.1 越狱 对于搭载 A15-A16 的 iPhone 设备,支持 iOS 15.0 到 iOS 16.5 越狱 对于搭载 M1 的 iPad 设备,支持 iPadOS 15.0 到 iPadOS 16.5.1 越狱 对于搭载 M1 的 iPad 设备,支持 iPadOS 15.0 到 iPadOS 16.5 越狱 此外还支持 iOS / iPadOS 16.6 Beta 1 到 Beta 4 越狱,不过 A15 / A16 / M2 芯片设备仅验证到 iOS 16.6 Beta 2,后续仍待测试 Beta 3 和 Beta 4 更新。 Dopamine 还启用了由 @tomt000 开发的全新用户界面,以及 @xerusdesign 设计了新的主题图标。

优秀的个人博客,低调大师

🍁CXYGZL - 程序员工作流 V2.0.7发布

CXYGZL 介绍 现在开源的工作流引擎,基本都是以 BPMN.js 为基础的,导致使用门槛过高,非专业人员无法驾驭。本工作流借鉴钉钉 / 飞书的方式,以低代码方式降低用户使用门槛,即使是普通企业用户也可以几分钟内就能搭建自己的工作流引擎。 体验地址:https://pro.cxygzl.com 文档地址:https://www.cxygzl.com V2.0.7版本介绍 开源版本记录 👑修改表单编辑页面的UI 👑审批人:支持表单部门控件 👑审批人:添加拒绝操作选项 👑审批人:审批人为空,自动结束改为自动拒绝 🎯修复条件分支多条执行的bug #💎PRO版本记录: 👑支持表单多选作为分支条件 👑审批人:添加发起人与当前审批人一直的操作选项 👑发起人范围移到基本信息页面 👑审批人:指定成员选项可以选择部门 👑审批人:支持部门主管为空 #📢注意事项 PRO版本有数据库脚本需要执行

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册