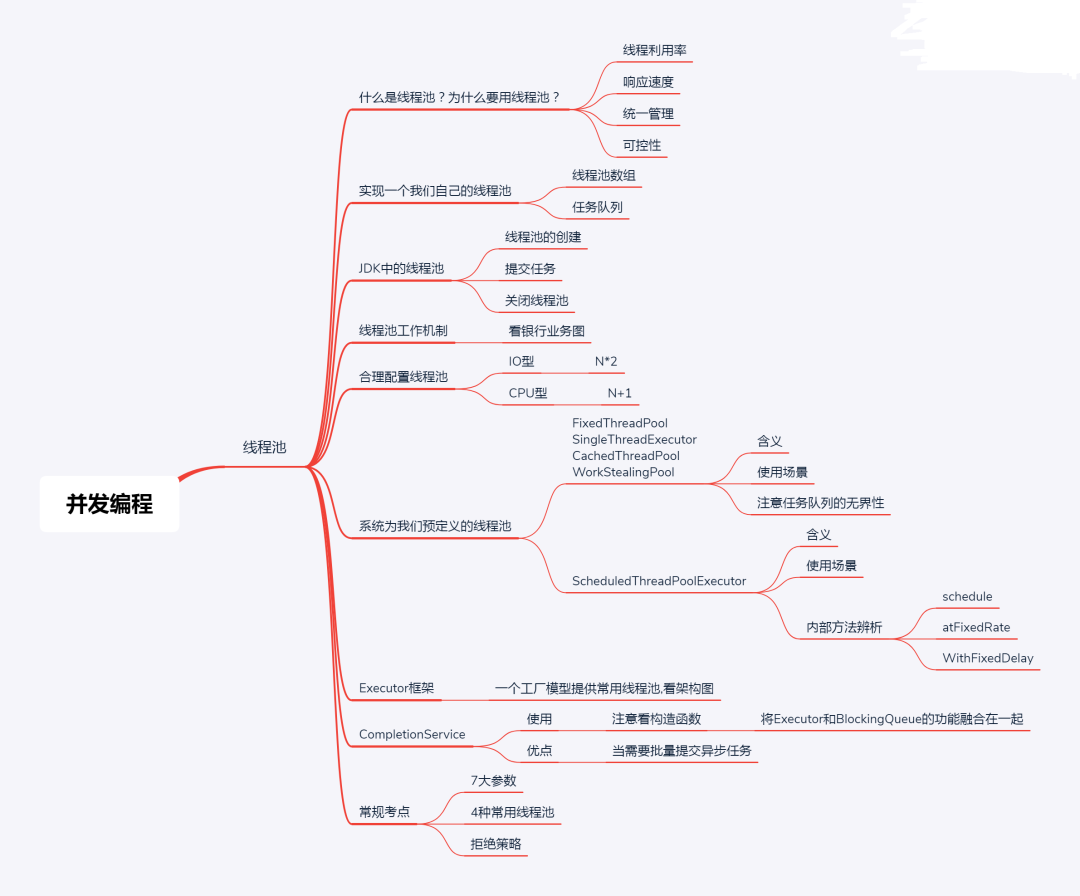
讲真 这次绝对让你轻松学习线程池
在这里插入图片描述 5分钟了解线程池 老王 是个深耕在帝都的一线码农,辛苦一年挣了点钱,想把钱存储到银行卡里,钱银行卡办理遇到了如下的遭遇 老王 银行门口取号后发现有柜台营业但是没人办理业务 直接办理了。 老王 取号后发现柜台都有人在办理,等待席有空地,去 坐着等办理去了。 老王 取号后发现柜台都有人办理,等待席也人坐满了,这个时候银行经理看到小麦是老实人本着关爱老实人的态度,新开一个 临时窗口给他办理了。 老王 取号后发现柜台都满了,等待座位席也满了, 临时窗口也人满了。这个时候银行经理给出了若干 解决策略。 直接告知人太多不给你办理了。 看到 老王 就来气,也不给不办理也不让他走。 经理让 老王 取尝试跟座位席中最前面的人聊一聊看是否可以加塞,可以就办理,不可以还是被踢走。 经理直接跟 老王 说谁让你来的你找谁去我这办理不了。 上面的这个流程几乎就跟JDK线程池的大致流程类似, 营业中的3个窗口对应核心线程池数:corePoolSize 银行总的营业窗口数对应:maximumPoolSize 打开的临时窗口在多少时间内无人办理则关闭对应:unit 银行里的等待座椅就是等待队列:workQueue 无法办理的时候银行给出的解决方法对应:RejectedExecutionHandler threadFactory 该参数在JDK中是 线程工厂,用来创建线程对象,一般不会动。 5分钟线程池的核心工作流程讲解完毕,更细节的知识看下面。 什么是线程池 简单理解就是 预先创建好一定数量的线程对象,存入缓冲池中,需要用的时候直接从缓冲池中取出,用完之后不要销毁,还回到缓冲池中。 线程池存在必要性 提高线程的利用率,降低资源的消耗。 提高响应速度,线程的创建时间为T1,执行时间T2,销毁时间T3,用线程池可以免去T1和T3的时间。 便于统一管理线程对象 可控制最大并发数 手动实现 如果先不看线程池源码让我们自己手动实现一个线程池你可以考虑到几个重要点? 有若干个初始化好的线程数组来充当线程池。 线程池要去一个 等待的任务队列 中去拿任务。 简单来说就是初始化N个线程充当线程池然后一起去阻塞队列中进行阻塞take,新添加的任务都通过put将任务追加到任务队列,关于任务队列的讲解看这blog 核心类 publicclassMyThreadPool2{//线程池中默认线程的个数为5privatestaticintWORK_NUM=5;//队列默认任务个数为100来不及保存任务privatestaticintTASK_COUNT=100;//工作线程组privateWorkThread[]workThreads;//任务队列,作为一个缓冲privatefinalBlockingQueue<Runnable>taskQueue;//用户在构造这个池,希望的启动的线程数privatefinalintworker_num;//创建具有默认线程个数的线程池publicMyThreadPool2(){this(WORK_NUM,TASK_COUNT);}//创建线程池,worker_num为线程池中工作线程的个数publicMyThreadPool2(intworker_num,inttaskCount){if(worker_num<=0)worker_num=WORK_NUM;if(taskCount<=0)taskCount=TASK_COUNT;this.worker_num=worker_num;taskQueue=newArrayBlockingQueue<>(taskCount);workThreads=newWorkThread[worker_num];for(inti=0;i<worker_num;i++){workThreads[i]=newWorkThread();workThreads[i].start();}Runtime.getRuntime().availableProcessors();}//执行任务,其实只是把任务加入任务队列,什么时候执行有线程池管理器决定publicvoidexecute(Runnabletask){try{taskQueue.put(task);//阻塞放置任务}catch(InterruptedExceptione){e.printStackTrace();}}//销毁线程池,该方法保证在所有任务都完成的情况下才销毁所有线程,否则等待任务完成才销毁publicvoiddestroy(){//工作线程停止工作,且置为nullSystem.out.println("准备关闭线程池");for(inti=0;i<worker_num;i++){workThreads[i].stopWorker();workThreads[i]=null;//helpgc}taskQueue.clear();//清空任务队列}//覆盖toString方法,返回线程池信息:工作线程个数和已完成任务个数@OverridepublicStringtoString(){return"线程池大小:"+worker_num+"等待执行任务个数:"+taskQueue.size();}//内部类,工作线程privateclassWorkThreadextendsThread{@Overridepublicvoidrun(){Runnabler=null;try{while(!isInterrupted()){r=taskQueue.take();//阻塞获得任务if(r!=null){System.out.println(getId()+"准备执行:"+r);r.run();}r=null;//helpgc;}}catch(Exceptione){//TODO:handleexception}}publicvoidstopWorker(){interrupt();}}} 测试类 publicclassTestMyThreadPool{publicstaticvoidmain(String[]args)throwsInterruptedException{//创建3个线程的线程池MyThreadPool2t=newMyThreadPool2(3,5);t.execute(newMyTask("testA"));t.execute(newMyTask("testB"));t.execute(newMyTask("testC"));t.execute(newMyTask("testD"));t.execute(newMyTask("testE"));System.out.println(t);Thread.sleep(10000);t.destroy();//所有线程都执行完成才destorySystem.out.println(t);}//任务类staticclassMyTaskimplementsRunnable{privateStringname;privateRandomr=newRandom();publicMyTask(Stringname){this.name=name;}publicStringgetName(){returnname;}@Overridepublicvoidrun(){//执行任务try{Thread.sleep(r.nextInt(1000)+2000);//随机休眠}catch(InterruptedExceptione){System.out.println(Thread.currentThread().getId()+"被打断:"+Thread.currentThread().isInterrupted());}System.out.println("任务"+name+"完成");}}} ThreadPoolExecutor ThreadPoolExecutor是JDK中所有线程池实现类的父类,构造函数有多个入参通过灵活的组合来实现线程池的初始化,核心构造函数如下。 publicThreadPoolExecutor(intcorePoolSize,intmaximumPoolSize,longkeepAliveTime,TimeUnitunit,BlockingQueue<Runnable>workQueue,ThreadFactorythreadFactory,RejectedExecutionHandlerhandler) 重要参数解析 corePoolSize 此值是用来初始化线程池中核心线程数,当线程池中线程池数< corePoolSize时,系统默认是添加一个任务才创建一个线程池。可以通过调用prestartAllCoreThreads方法一次性的启动corePoolSize个数的线程。当线程数 = corePoolSize时,新任务会追加到workQueue中。 maximumPoolSize maximumPoolSize表示允许的最大线程数 = (非核心线程数+核心线程数),当BlockingQueue也满了,但线程池中总线程数 < maximumPoolSize时候就会再次创建新的线程。 keepAliveTime 非核心线程 =(maximumPoolSize - corePoolSize ) ,非核心线程闲置下来不干活最多存活时间。 unit 线程池中非核心线程保持存活的时间 TimeUnit.DAYS; 天 TimeUnit.HOURS; 小时 TimeUnit.MINUTES; 分钟 TimeUnit.SECONDS; 秒 TimeUnit.MILLISECONDS; 毫秒 TimeUnit.MICROSECONDS; 微秒 TimeUnit.NANOSECONDS; 纳秒 workQueue 线程池 等待队列,维护着等待执行的Runnable对象。当运行当线程数= corePoolSize时,新的任务会被添加到workQueue中,如果workQueue也满了则尝试用非核心线程执行任务,另外等待队列尽量用有界的哦!! threadFactory 创建一个新线程时使用的工厂,可以用来设定线程名、是否为daemon线程等等。 handler corePoolSize、workQueue、maximumPoolSize都不可用的时候执行的 饱和策略。 AbortPolicy :直接抛出异常,默认用此 CallerRunsPolicy:用调用者所在的线程来执行任务 DiscardOldestPolicy:丢弃阻塞队列里最老的任务,队列里最靠前的任务 DiscardPolicy :当前任务直接丢弃 想实现自己的饱和策略,实现RejectedExecutionHandler接口即可 形象流程图如下: 提交 execute 不需要返回 //核心思想跟上面的流程图类似publicvoidexecute(Runnablecommand){if(command==null)//规范性检查thrownewNullPointerException();intc=ctl.get();//当前工作的线程数跟线程状态ctl=AtomicIntegerCAS级别if(workerCountOf(c)<corePoolSize){if(addWorker(command,true))//如果当前线程池中工作线程数小于核心线程数,直接添加任务然后returnreturn;c=ctl.get();//添加失败了重新获得线程池中工作线程数}if(isRunning(c)&&workQueue.offer(command)){//线程池状态是否处于可用,可用就尝试将线程添加到queueintrecheck=ctl.get();//获得线程池状态if(!isRunning(recheck)&&remove(command))reject(command);//如果线程状态不在运行中则remove该任务elseif(workerCountOf(recheck)==0)addWorker(null,false);}elseif(!addWorker(command,false))//尝试将任务用非核心线程执行,reject(command);//失败了则执行失败策略。} submit 需要返回值 ThreadPoolExecutor extends AbstractExecutorService父类中存在一个submit方法, public<T>Future<T>submit(Callable<T>task){if(task==null)thrownewNullPointerException();RunnableFuture<T>ftask=newTaskFor(task);execute(ftask);returnftask;} 关闭线程池 注意线程之间是协作式的哦,所以的关闭只是发出关闭指令。 shutdown() 将线程池状态置为shutdown,并不会立即停止: 停止接收外部submit的任务 内部正在跑的任务和队列里等待的任务,会执行完 等到第二步完成后,才真正停止 shutdownNow() 将线程池状态置为stop。企图立即停止,事实上不一定: 跟shutdown()一样,先停止接收外部提交的任务 忽略队列里等待的任务 尝试将正在跑的任务interrupt中断 返回未执行的任务列表 shutdown 跟shutdownnow简单来说区别如下: shutdownNow()能立即停止线程池,正在跑的和正在等待的任务都停下了。这样做立即生效,但是风险也比较大。shutdown()只是关闭了提交通道,用submit()是无效的;而内部该怎么跑还是怎么跑,跑完再停。 awaitTermination pool.showdown()booleanb=pool.awaitTermination(3,TimeUnit.SECONDS) awaitTermination有两个参数,一个是timeout即超时时间,另一个是unit即时间单位。这个方法会使线程等待timeout时长,当超过timeout时间后,会监测ExecutorService是否已经关闭,若关闭则返回true,否则返回false。一般情况下会和shutdown方法组合使用,调用后当前线程会阻塞,直到 等所有已提交的任务(包括正在跑的和队列中等待的)执行完 或者等超时时间到 或者线程被中断,抛出InterruptedException 总结 优雅的关闭,用shutdown() 想立马关闭,并得到未执行任务列表,用shutdownNow() 优雅的关闭,发出关闭指令后看下是否真的关闭了用awaitTermination()。 合理配置线程池 线程在Java中属于稀缺资源,线程池不是越大越好也不是越小越好。任务分为计算密集型、IO密集型、混合型。 计算密集型:大部分都在用CPU跟内存,加密,逻辑操作业务处理等。 IO密集型:数据库链接,网络通讯传输等。 计算密集型一般推荐线程池不要过大,一般是CPU数 + 1,+1是因为可能存在 页缺失(就是可能存在有些数据在硬盘中需要多来一个线程将数据读入内存)。如果线程池数太大,可能会频繁的 进行线程上下文切换跟任务调度。获得当前CPU核心数代码如下: Runtime.getRuntime().availableProcessors(); IO密集型:线程数适当大一点,机器的Cpu核心数*2。 混合型:如果密集型站大头则拆分的必要性不大,如果IO型占据不少有必要,Mark 下。 常见线程池 每个线程池都是一个实现了接口ExecutorService并且继承自ThreadPoolExecutor的具体实现类,这些类的创建统一由一个工厂类Executors来提供对外创建接口。Executors框架图如下: ThreadPoolExecutor中一个线程就是一个Worker对象,它与一个线程绑定,当Worker执行完毕就是线程执行完毕。而Worker带了锁AQS,根据我后面准备写的读写锁的例子,发现线程池是线程安全的。看看图二的类图。下面简单介绍几个常用的线程池模式。 FixedThreadPool 定长的线程池,有核心线程,核心线程的即为最大的线程数量,没有非核心线程。 使用的 无界的等待队列是 LinkedBlockingQueue。使用时候小心堵满等待队列。 SingleThreadPool 只有一条线程来执行任务,适用于有顺序的任务的应用场景,也是用的无界等待队列 CachedThreadPool 可缓存的线程池,该线程池中没有核心线程,非核心线程的数量为Integer.max_value,就是无限大,当有需要时创建线程来执行任务,没有需要时回收线程,适用于耗时少,任务量大的情况。任务队列用的是SynchronousQueue如果生产多快消费慢,则会导致创建很多线程需注意。 WorkStealingPool JDK7以后 基于ForkJoinPool实现。PS:其中FixedThreadPool、SingleThreadPool、CachedThreadPool都用的无界等待队列,因此实际工作中都不建议这样做的哦,阿里巴巴Java编程规范建议如下:最后来个简单的线程使用demo: publicclassUseThreadPool{//工作线程staticclassWorkerimplementsRunnable{privateStringtaskName;privateRandomr=newRandom();publicWorker(StringtaskName){this.taskName=taskName;}publicStringgetName(){returntaskName;}@Overridepublicvoidrun(){System.out.println(Thread.currentThread().getName()+"当前任务:"+taskName);try{TimeUnit.MILLISECONDS.sleep(r.nextInt(100)*5);}catch(Exceptione){e.printStackTrace();}}}staticclassCallWorkerimplementsCallable<String>{privateStringtaskName;privateRandomr=newRandom();publicCallWorker(StringtaskName){this.taskName=taskName;}publicStringgetName(){returntaskName;}@OverridepublicStringcall()throwsException{System.out.println(Thread.currentThread().getName()+"当前任务:"+taskName);returnThread.currentThread().getName()+":"+r.nextInt(100)*5;}}publicstaticvoidmain(String[]args)throwsInterruptedException,ExecutionException{ExecutorServicepool=newThreadPoolExecutor(2,4,3,TimeUnit.SECONDS,newArrayBlockingQueue<Runnable>(10),newThreadPoolExecutor.DiscardOldestPolicy());//ExecutorServicepool=Executors.newCachedThreadPool();for(inti=0;i<5;i++){Workerworker=newWorker("Runnable_"+i);pool.execute(worker);}for(inti=0;i<5;i++){CallWorkercallWorker=newCallWorker("CallWorker_"+i);Future<String>result=pool.submit(callWorker);System.out.println(result.get());}pool.shutdown();}} ScheduledThreadPoolExecutor 周期性执行任务的线程池,按照某种特定的计划执行线程中的任务,有核心线程,但也有非核心线程,非核心线程的大小也为无限大。适用于执行周期性的任务。看构造函数:调用的还是ThreadPoolExecutor构造函数,区别不同点在于任务队列是用的DelayedWorkQueue,没什么新奇的了。 核心函数讲解: schedule 只执行一次,任务还可以延时执行,传入待执行任务跟延时时间。 scheduleAtFixedRate 提交固定时间间隔的任务,提交任务,延时时间,已经循环时间间隔时间。这个的含义是只是在固定的时间间隔尝试运行该任务。 scheduleWithFixedDelay 提交固定延时间隔执行的任务。上一个任务执行完毕后等多久再执行下个任务,这个中间时间叫 FixedDelay 其中 scheduleAtFixedRate 跟 scheduleWithFixedDelay区别如下图 scheduleAtFixedRate任务超时状态,比如我们设定60s执行一次,其中第一个任务时长 80s,第二个任务20s,第三个任务 50s。 第一个任务第0秒开始,第80s结束. 第二个任务第80s开始,在第100s结束. 第三个任务第120s秒开始,170s结束. 第四个任务从180s开始. 简单Mark个循环任务demo: classScheduleWorkerimplementsRunnable{publicfinalstaticintNormal=0;//普通任务类型publicfinalstaticintHasException=-1;//会抛出异常的任务类型publicfinalstaticintProcessException=1;//抛出异常但会捕捉的任务类型publicstaticSimpleDateFormatformater=newSimpleDateFormat("yyyy-MM-ddHH:mm:ss");privateinttaskType;publicScheduleWorker(inttaskType){this.taskType=taskType;}@Overridepublicvoidrun(){if(taskType==HasException){System.out.println(formater.format(newDate())+"异常产生");thrownewRuntimeException("有异常");}elseif(taskType==ProcessException){try{System.out.println(formater.format(newDate())+"异常产生被捕捉");thrownewRuntimeException("异常被捕捉");//异常导致下个任务无法执行}catch(Exceptione){System.out.println("异常被主播");}}else{System.out.println("正常"+formater.format(newDate()));}}}publicclassSchTest{publicstaticvoidmain(String[]args){ScheduledThreadPoolExecutorschedule=newScheduledThreadPoolExecutor(1);schedule.scheduleAtFixedRate(newScheduleWorker(ScheduleWorker.HasException),1000,3000,TimeUnit.MILLISECONDS);//任务在1秒后执行周期3秒schedule.scheduleAtFixedRate(newScheduleWorker(ScheduleWorker.Normal),1000,3000,TimeUnit.MILLISECONDS);}} CompletionService JDK8中新添加的一个类,摄像一个场景你去询问两个商品价格然后将价格保存数据库。 ExecutorServiceexecutor=Executors.newFixedThreadPool(2);//异步向电商S1询价Future<Integer>f1=executor.submit(()->getPriceByS1());//异步向电商S2询价Future<Integer>f2=executor.submit(()->getPriceByS2());//获取电商S1报价并保存r=f1.get();executor.execute(()->save(r));//获取电商S2报价并保存r=f2.get();executor.execute(()->save(r)); 上面的这个方案本身没有太大问题,但是有个地方的处理需要你注意,那就是如果获取电商 S1 报价的耗时很长,那么即便获取电商 S2 报价的耗时很短,也无法让保存 S2 报价的操作先执行,因为这个主线程都阻塞在了 f1.get(),那我们如何解决了?解决方法:结果都存入到一个阻塞队列中去。 //创建阻塞队列BlockingQueue<Integer>bq=newLinkedBlockingQueue<>();//电商S1报价异步进入阻塞队列executor.execute(()->bq.put(f1.get()));//电商S2报价异步进入阻塞队列executor.execute(()->bq.put(f2.get()));//异步保存所有报价for(inti=0;i<2;i++){Integerr=bq.take();executor.execute(()->save(r));} 在JDK8中不建议上面的工作都手动实现,JDK提供了CompletionService ,它实现原理也是内部维护了一个阻塞队列,它的核心功效就是让先执行的任务先放到结果集。当任务执行结束就把任务的执行结果加入到阻塞队列中,不同的是CompletionService是把任务执行结果的 Future 对象加入到阻塞队列中,而上面的示例代码是把任务最终的执行结果放入了阻塞队列中。CompletionService将Executor和BlockingQueue的功能融合在一起,CompletionService内部有个阻塞队列。CompletionService 接口的实现类是 ExecutorCompletionService,这个实现类的构造方法有两个,分别是: ExecutorCompletionService(Executorexecutor)ExecutorCompletionService(Executorexecutor,BlockingQueue<Future<V>>completionQueue) 这两个构造方法都需要传入一个线程池,如果不指定 completionQueue,那么默认会使用无界的 LinkedBlockingQueue。任务执行结果的 Future 对象就是加入到 completionQueue 中。 //创建线程池ExecutorServiceexecutor=Executors.newFixedThreadPool(2);//创建CompletionServiceCompletionService<Integer>cs=newExecutorCompletionService<>(executor);//异步向电商S1询价cs.submit(()->getPriceByS1());//异步向电商S2询价cs.submit(()->getPriceByS2());//将询价结果异步保存到数据库for(inti=0;i<2;i++){Integerr=cs.take().get();executor.execute(()->save(r));} 来一个整体的demo加深印象: //任务类classWorkTaskimplementsCallable<Integer>{privateStringname;publicWorkTask(Stringname){this.name=name;}@OverridepublicIntegercall(){intsleepTime=newRandom().nextInt(1000);try{Thread.sleep(sleepTime);}catch(InterruptedExceptione){e.printStackTrace();}returnsleepTime;}}publicclassCompletionCase{privatefinalintPOOL_SIZE=Runtime.getRuntime().availableProcessors();privatefinalintTOTAL_TASK=Runtime.getRuntime().availableProcessors();publicvoidselfByQueue()throwsException{longstart=System.currentTimeMillis();//统计所有任务休眠的总时长AtomicIntegercount=newAtomicInteger(0);ExecutorServicepool=Executors.newFixedThreadPool(POOL_SIZE);//创建线程池BlockingQueue<Future<Integer>>queue=newLinkedBlockingQueue<Future<Integer>>();//容器存放提交给线程池的任务,list,map,for(inti=0;i<TOTAL_TASK;i++){Future<Integer>future=pool.submit(newWorkTask("要执行的第几个任务"+i));queue.add(future);//i=0先进队列,i=1的任务跟着进}for(inti=0;i<TOTAL_TASK;i++){intsleptTime=queue.take().get();//检查线程池任务执行结果i=0先取到,i=1的后取到System.out.println("休眠毫秒数="+sleptTime+"ms");count.addAndGet(sleptTime);}pool.shutdown();System.out.println("休眠时间"+count.get()+"ms,耗时时间"+(System.currentTimeMillis()-start)+"ms");}publicvoidtestByCompletion()throwsException{longstart=System.currentTimeMillis();AtomicIntegercount=newAtomicInteger(0);//创建线程池ExecutorServicepool=Executors.newFixedThreadPool(POOL_SIZE);CompletionService<Integer>cService=newExecutorCompletionService<>(pool);//向里面扔任务for(inti=0;i<TOTAL_TASK;i++){cService.submit(newWorkTask("执行任务"+i));}//检查线程池任务执行结果for(inti=0;i<TOTAL_TASK;i++){intsleptTime=cService.take().get();System.out.println("休眠毫秒数="+sleptTime+"ms...");count.addAndGet(sleptTime);}pool.shutdown();System.out.println("休眠时间"+count.get()+"ms,耗时时间"+(System.currentTimeMillis()-start)+"ms");}publicstaticvoidmain(String[]args)throwsException{CompletionCaset=newCompletionCase();t.selfByQueue();t.testByCompletion();}} 在这里插入图片描述 常见考题 为什么用线程池? 线程池的作用? 常用的线程池模版? 7大重要参数? 4大拒绝策略? 常见线程池任务队列,如何理解有界跟无界?7.如何分配线程池个数? 单机线程池执行一般断电了如何考虑? 正在处理的实现事务功能,下次自动回滚,队列实现持久化储存,下次启动自动载入。 设定一个线程池优先级队列,Runable类要实现可对比功能,任务队列使用优先级队列 本文分享自微信公众号 - sowhat1412(sowhat9094)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。