Apache Spark Jobs 性能调优
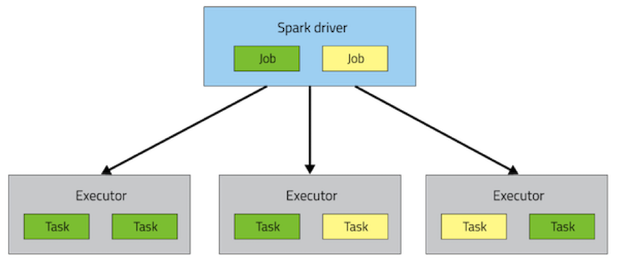
当你开始编写 Apache Spark 代码或者浏览公开的 API 的时候,你会遇到各种各样术语,比如transformation,action,RDD(resilient distributed dataset)等等。 了解到这些是编写 Spark 代码的基础。 同样,当你任务开始失败或者你需要透过web界面去了解自己的应用为何如此费时的时候,你需要去了解一些新的名词:job,stage,task。对于这些新术语的理解有助于编写良好Spark 代码。这里的良好主要指更快的 Spark 程序。对于 Spark 底层的执行模型的了解对于写出效率更高的 Spark 程序非常有帮助。 Spark 是如何执行程序的 一个 Spark 应用包括一个driver进程和若干个分布在集群的各个节点上的executor进程。 driver主要负责调度一些高层次的任务流(flow of work)。exectuor负责执行这些任务,这些任务以task的形式存在, 同时存储用户设置需要caching的数据。task和所有的executor的生命周期为整个程序的运行过程(如果使用了dynamic resource allocation 时可能不是这样的)。如何调度这些进程是通过集群管理应用完成的(比如YARN,Mesos,Spark Standalone),但是任何一个 Spark 程序都会包含一个driver和多个executor进程。 在执行层次结构的最上方是一系列 Job。调用一个Spark内部的action会产生一个 Spark job 来完成它。 为了确定这些job实际的内容,Spark 检查RDD的DAG再计算出执行 plan 。这个 plan 以最远端的RDD为起点(最远端指的是对外没有依赖的RDD或者 数据已经缓存下来的RDD),产生结果RDD的action为结束 。 执行的 plan 由一系列stage组成,stage是job的transformation的组合,stage对应于一系列task,task指的对于不同的数据集执行的相同代码。每个stage包含不需要shuffle数据的transformation的序列。 什么决定数据是否需要shuffle?RDD包含固定数目的partition, 每个partiton包含若干的record。对于那些通过narrow tansformation(比如map和filter)返回的RDD,一个partition中的record只需要从父RDD对应的partition中的record计算得到。每个对象只依赖于父RDD的一个对象。有些操作(比如coalesce)可能导致一个task处理多个输入partition,但是这种transformation仍然被认为是narrow的,因为用于计算的多个输入record始终是来自有限个数的partition。 然而 Spark 也支持需要wide依赖的transformation,比如groupByKey,reduceByKey。在这种依赖中,计算得到一个partition中的数据需要从父RDD中的多个partition中读取数据。所有拥有相同key的元组最终会被聚合到同一个partition中,被同一个stage处理。为了完成这种操作, Spark需要对数据进行shuffle,意味着数据需要在集群内传递,最终生成由新的partition集合组成的新的stage。 举例,以下的代码中,只有一个action以及 从一个文本串下来的一系列RDD, 这些代码就只有一个stage,因为没有哪个操作需要从不同的partition里面读取数据。 sc.textFile("someFile.txt"). map(mapFunc). flatMap(flatMapFunc). filter(filterFunc). count() 跟上面的代码不同,下面一段代码需要统计总共出现超过1000次的单词: val tokenized = sc.textFile(args(0)).flatMap(_.split(' ')) val wordCounts = tokenized.map((_, 1)).reduceByKey(_ + _) val filtered = wordCounts.filter(_._2 >= 1000) val charCounts = filtered.flatMap(_._1.toCharArray).map((_, 1)). reduceByKey(_ + _) charCounts.collect() 这段代码可以分成三个stage。recudeByKey操作是各stage之间的分界,因为计算recudeByKey的输出需要按照可以重新分配partition。 这里还有一个更加复杂的transfromation图,包含一个有多路依赖的join transformation。 粉红色的框框展示了运行时使用的stage图。 运行到每个stage的边界时,数据在父stage中按照task写到磁盘上,而在子stage中通过网络按照task去读取数据。这些操作会导致很重的网络以及磁盘的I/O,所以stage的边界是非常占资源的,在编写 Spark 程序的时候需要尽量避免的。父stage中partition个数与子stage的partition个数可能不同,所以那些产生stage边界的transformation常常需要接受一个 numPartition 的参数来觉得子stage中的数据将被切分为多少个partition。 正如在调试MapReduce是选择reducor的个数是一项非常重要的参数,调整在stage边届时的partition个数经常可以很大程度上影响程序的执行效率。我们会在后面的章节中讨论如何调整这些值。 选择正确的Operator 当需要使用 Spark 完成某项功能时,程序员需要从不同的action和transformation中选择不同的方案以获得相同的结果。但是不同的方案,最后执行的效率可能有云泥之别。回避常见的陷阱选择正确的方案可以使得最后的表现有巨大的不同。一些规则和深入的理解可以帮助你做出更好的选择。 在最新的Spark5097文档中开始稳定SchemaRDD(也就是 Spark 1.3 开始支持的DataFrame),这将为使用 Spark 核心API的程序员打开 Spark的 Catalyst optimizer,允许 Spark 在使用Operator时做出更加高级的选择。当SchemaRDD稳定之后,某些决定将不需要用户去考虑了。 选择Operator方案的主要目标是减少shuffle的次数以及被shuffle的文件的大小。因为shuffle是最耗资源的操作,所以有shuffle的数据都需要写到磁盘并且通过网络传递。repartition,join,cogroup,以及任何*By或者*ByKey的transformation都需要shuffle数据。不是所有这些Operator都是平等的,但是有些常见的性能陷阱是需要注意的。 当进行联合的规约操作时,避免使用groupByKey。举个例子,rdd.groupByKey().mapValues(_ .sum) 与 rdd.reduceByKey(_ + _) 执行的结果是一样的,但是前者需要把全部的数据通过网络传递一遍,而后者只需要根据每个key局部的partition累积结果,在shuffle的之后把局部的累积值相加后得到结果。 当输入和输入的类型不一致时,避免使用reduceByKey。举个例子,我们需要实现为每一个key查找所有不相同的 string。一个方法是利用map把每个元素的转换成一个 Set,再使用reduceByKey将这些 Set 合并起来 rdd.map(kv => (kv._1, new Set[String]() + kv._2)) .reduceByKey(_ ++ _) 这段代码生成了无数的非必须的对象,因为每个需要为每个 record 新建一个 Set。这里使用aggregateByKey更加适合,因为这个操作是在map阶段做聚合。 val zero = new collection.mutable.Set[String]() rdd.aggregateByKey(zero)( (set, v) => set += v, (set1, set2) => set1 ++= set2) 避免 flatMap-join-groupBy 的模式。当有两个已经按照key分组的数据集,你希望将两个数据集合并,并且保持分组,这种情况可以使用cogroup。这样可以避免对group进行打包解包的开销。 什么时候不发生Shuffle 当然了解在哪些transformation上不会发生shuffle也是非常重要的。当前一个transformation已经用相同的patitioner把数据分 patition 了,Spark知道如何避免shuffle。参考一下代码: rdd1 = someRdd.reduceByKey(...) rdd2 = someOtherRdd.reduceByKey(...) rdd3 = rdd1.join(rdd2) 因为没有partitioner传递给reduceByKey,所以系统使用默认的partitioner,所以 rdd1 和 rdd2 都会使用 hash 进行分partition。代码中的两个reduceByKey会发生两次shuffle。如果RDD包含相同个数的partition,join的时候将不会发生额外的shuffle。因为这里的RDD使用相同的 hash 方式进行partition,所以全部RDD中同一个partition中的 key的集合都是相同的。因此,rdd3中一个partiton的输出只依赖rdd2和rdd1的同一个对应的partition,所以第三次shuffle是不必要的。 举个例子说,当someRdd有4个partition,someOtherRdd有两个partition,两个reduceByKey都使用3个partiton,所有的task会按照如下的方式执行: 如果 rdd1 和 rdd2 在reduceByKey时使用不同的partitioner或者使用相同的partitioner但是partition的个数不同的情况,那么只有一个RDD(partiton数更少的那个)需要重新shuffle。 相同的tansformation,相同的输入,不同的partition个数: 当两个数据集需要join的时候,避免shuffle的一个方法是使用broadcast variables。如果一个数据集小到能够塞进一个executor的内存中,那么它就可以在driver中写入到一个 hash table中,然后 broadcast 到所有的executor中。然后map transformation可以引用这个 hash table 作查询。 什么情况下Shuffle越多越好 尽可能减少shuffle的准则也有例外的场合。如果额外的shuffle能够增加并发那么这也能够提高性能。比如当你的数据保存在几个没有切分过的大文件中时,那么使用 InputFormat 产生分 partition 可能会导致每个 partiton 中聚集了大量的record,如果partition不够,导致没有启动足够的并发。在这种情况下,我们需要在数据载入之后使用repartiton(会导致shuffle)提高 partiton 的个数,这样能够充分使用集群的CPU。 另外一种例外情况是在使用 recude 或者 aggregateaction聚集数据到driver时,如果数据把很多partititon个数的数据,单进程执行的drivermerge 所有partition的输出时很容易成为计算的瓶颈。为了缓解driver的计算压力,可以使用reduceByKey或者aggregateByKey执行分布式的 aggregate 操作把数据分布到更少的partition上。每个partition中的数据并行的进行 merge,再把 merge 的结果发个driver以进行最后一轮 aggregation。查看treeReduce和treeAggregate查看如何这么使用的例子。 这个技巧在已经按照 Key 聚集的数据集上格外有效,比如当一个应用是需要统计一个语料库中每个单词出现的次数,并且把结果输出到一个map中。一个实现的方式是使用aggregation,在每个partition中本地计算一个 map,然后在driver中把各个partition中计算的 map merge 起来。另一种方式是通过aggregateByKey把 merge 的操作分布到各个partiton中计算,然后在简单地通过collectAsMap把结果输出到driver中。 二次排序 还有一个重要的技能是了解接口repartitionAndSortWithinPartitionstransformation。这是一个听起来很晦涩的transformation,但是却能涵盖各种奇怪情况下的排序,这个transformation把排序推迟到shuffle操作中,这使大量的数据有效的输出,排序操作可以和其他操作合并。 举例说,Apache Hive on Spark 在join的实现中,使用了这个transformation。而且这个操作在secondary sort模式中扮演着至关重要的角色。secondary sort 模式是指用户期望数据按照 key 分组,并且希望按照特定的顺序遍历 value。使用repartitionAndSortWithinPartitions再加上一部分用户的额外的工作可以实现 secondary sort。 在这篇文章中,首先完成在 Part I中提到的一些东西。作者将尽量覆盖到影响 Spark 程序性能的方方面面,你们将会了解到资源调优,或者如何配置 Spark 以压榨出集群每一分资源。然后我们将讲述调试并发度,这是job性能中最难也是最重要的参数。最后,你将了解到数据本身的表达形式,Spark 读取在磁盘的上的形式(主要是Apache Avro和 Apache Parquet)以及当数据需要缓存或者移动的时候内存中的数据形式。 调试资源分配 Spark 的用户邮件邮件列表中经常会出现 “我有一个500个节点的集群,为什么但是我的应用一次只有两个task在执行”,鉴于 Spark 控制资源使用的参数的数量,这些问题不应该出现。但是在本章中,你将学会压榨出你集群的每一分资源。推荐的配置将根据不同的集群管理系统(YARN、Mesos、Spark Standalone)而有所不同,我们将主要集中在YARN上,因为这个Cloudera推荐的方式。 我们先看一下在YARN 上运行 Spark 的一些背景。查看之前的博文:点击这里查看 Spark(以及YARN) 需要关心的两项主要的资源是 CPU 和 内存, 磁盘 和 IO 当然也影响着 Spark 的性能,但是不管是 Spark 还是 Yarn 目前都没法对他们做实时有效的管理。 在一个 Spark 应用中,每个 Sparkexecutor拥有固定个数的 core 以及固定大小的堆大小。core 的个数可以在执行 spark-submit 或者 pyspark 或者 spark-shell 时,通过参数 --executor-cores 指定,或者在 spark-defaults.conf 配置文件或者 SparkConf 对象中设置 spark.executor.cores 参数。同样地,堆的大小可以通过 --executor-memory 参数或者 spark.executor.memory 配置项。core 配置项控制一个executor中task的并发数。 --executor-cores 5 意味着每个executor中最多同时可以有5个task运行。memory 参数影响 Spark 可以缓存的数据的大小,也就是在groupaggregate以及join操作时shuffle的数据结构的最大值。 --num-executors 命令行参数或者spark.executor.instances 配置项控制需要的executor个数。从 CDH 5.4/Spark 1.3 开始,你可以避免使用这个参数,只要你通过设置 spark.dynamicAllocation.enabled 参数打开动态分配。动态分配可以使的 Spark 的应用在有后续积压的在等待的task时请求executor,并且在空闲时释放这些executor。 同时 Spark 需求的资源如何跟YARN中可用的资源配合也是需要着重考虑的,YARN相关的参数有: yarn.nodemanager.resource.memory-mb 控制在每个节点上container能够使用的最大内存; yarn.nodemanager.resource.cpu-vcores 控制在每个节点上container能够使用的最大core个数; 请求5个 core 会生成向YARN要5个虚拟core的请求。从YARN 请求内存相对比较复杂因为以下的一些原因: --executor-memory/spark.executor.memory 控制executor的堆的大小,但是 JVM 本身也会占用一定的堆空间,比如内部的 String 或者直接 byte buffer,executormemory 的 spark.yarn.executor.memoryOverhead 属性决定向YARN请求的每个executor的内存大小,默认值为max(384, 0.7 * spark.executor.memory); YARN可能会比请求的内存高一点,YARN的 yarn.scheduler.minimum-allocation-mb 和 yarn.scheduler.increment-allocation-mb 属性控制请求的最小值和增加量。 下面展示的是 Spark onYARN内存结构: 如果这些还不够决定Sparkexecutor个数,还有一些概念还需要考虑的: 应用的master,是一个非executor的容器,它拥有特殊的从YARN请求资源的能力,它自己本身所占的资源也需要被计算在内。在yarn-client模式下,它默认请求 1024MB 和 1个core。在yarn-cluster模式中,应用的 master 运行driver,所以使用参数 --driver-memory 和 --driver-cores 配置它的资源常常很有用。 在executor执行的时候配置过大的 memory 经常会导致过长的GC延时,64G是推荐的一个executor内存大小的上限。 我们注意到HDFSclient 在大量并发线程是时性能问题。大概的估计是每个executor中最多5个并行的task就可以占满的写入带宽。 在运行微型executor时(比如只有一个core而且只有够执行一个task的内存)扔掉在一个JVM上同时运行多个task的好处。比如 broadcast 变量需要为每个executor复制一遍,这么多小executor会导致更多的数据拷贝。 为了让以上的这些更加具体一点,这里有一个实际使用过的配置的例子,可以完全用满整个集群的资源。假设一个集群有6个节点有NodeManager在上面运行,每个节点有16个core以及64GB的内存。那么 NodeManager的容量:yarn.nodemanager.resource.memory-mb 和 yarn.nodemanager.resource.cpu-vcores 可以设为 63 * 1024 = 64512 (MB) 和 15。我们避免使用 100% 的YARNcontainer 资源因为还要为 OS 和 hadoop 的 Daemon 留一部分资源。在上面的场景中,我们预留了1个core和1G的内存给这些进程。Cloudera Manager 会自动计算并且配置。 所以看起来我们最先想到的配置会是这样的:--num-executors 6 --executor-cores 15 --executor-memory 63G。但是这个配置可能无法达到我们的需求,因为: - 63GB+ 的executormemory 塞不进只有 63GB 容量的 NodeManager; - 应用的 master 也需要占用一个core,意味着在某个节点上,没有15个core给executor使用; - 15个core会影响 HDFS IO的吞吐量。 配置成 --num-executors 17 --executor-cores 5 --executor-memory 19G 可能会效果更好,因为: - 这个配置会在每个节点上生成3个executor,除了应用的master运行的机器,这台机器上只会运行2个executor - --executor-memory 被分成3份(63G/每个节点3个executor)=21。 21 * (1 - 0.07) ~ 19。 调试并发 我们知道 Spark 是一套数据并行处理的引擎。但是 Spark 并不是神奇得能够将所有计算并行化,它没办法从所有的并行化方案中找出最优的那个。每个 Sparkstage中包含若干个task,每个task串行地处理数据。在调试 Spark 的job时,task的个数可能是决定程序性能的最重要的参数。 那么这个数字是由什么决定的呢?在之前的博文中介绍了 Spark 如何将RDD转换成一组stage。task的个数与stage中上一个RDD的partition个数相同。而一个RDD的partition个数与被它依赖的RDD的partition个数相同,除了以下的情况:coalescetransformation 可以创建一个具有更少partition个数的RDD,uniontransformation 产出的RDD的partition个数是它父RDD的partition个数之和,cartesian返回的RDD的partition个数是它们的积。 如果一个RDD没有父RDD呢? 由textFile或者hadoopFile生成的RDD的partition个数由它们底层使用的 MapReduce InputFormat 决定的。一般情况下,每读到的一个 HDFS block 会生成一个partition。通过parallelize接口生成的RDD的partition个数由用户指定,如果用户没有指定则由参数 spark.default.parallelism 决定。 要想知道partition的个数,可以通过接口 rdd.partitions().size() 获得。 这里最需要关心的问题在于task的个数太小。如果运行时task的个数比实际可用的 slot 还少,那么程序解没法使用到所有的 CPU 资源。 过少的task个数可能会导致在一些聚集操作时, 每个task的内存压力会很大。任何join,cogroup,*ByKey操作都会在内存生成一个 hash-map或者 buffer 用于分组或者排序。join,cogroup,groupByKey会在shuffle时在 fetching 端使用这些数据结构,reduceByKey,aggregateByKey会在shuffle时在两端都会使用这些数据结构。 当需要进行这个聚集操作的record不能完全轻易塞进内存中时,一些问题会暴露出来。首先,在内存 hold 大量这些数据结构的record会增加 GC的压力,可能会导致流程停顿下来。其次,如果数据不能完全载入内存,Spark 会将这些数据写到磁盘,这会引起磁盘 IO和排序。在 Cloudera 的用户中,这可能是导致 Spark Job 慢的首要原因。 那么如何增加你的partition的个数呢?如果你的问题stage是从 Hadoop 读取数据,你可以做以下的选项: - 使用repartition选项,会引发shuffle; - 配置 InputFormat 用户将文件分得更小; - 写入 HDFS 文件时使用更小的block。 如果问题stage从其他stage中获得输入,引发stage边界的操作会接受一个 numPartitions 的参数,比如 val rdd2 = rdd1.reduceByKey(_ + _, numPartitions = X) X 应该取什么值?最直接的方法就是做实验。不停的将partition的个数从上次实验的partition个数乘以1.5,直到性能不再提升为止。 同时也有一些原则用于计算 X,但是也不是非常的有效是因为有些参数是很难计算的。这里写到不是因为它们很实用,而是可以帮助理解。这里主要的目标是启动足够的task可以使得每个task接受的数据能够都塞进它所分配到的内存中。 每个task可用的内存通过这个公式计算:spark.executor.memory * spark.shuffle.memoryFraction * spark.shuffle.safetyFraction)/spark.executor.cores 。 memoryFraction 和 safetyFractio 默认值分别 0.2 和 0.8. 在内存中所有shuffle数据的大小很难确定。最可行的是找出一个stage运行的 Shuffle Spill(memory) 和 Shuffle Spill(Disk) 之间的比例。在用所有shuffle 写乘以这个比例。但是如果这个stage是 reduce 时,可能会有点复杂: 在往上增加一点因为大多数情况下partition的个数会比较多。 试试在,在有所疑虑的时候,使用更多的task数(也就是partition数)都会效果更好,这与 MapRecuce 中建议task数目选择尽量保守的建议相反。这个因为 MapReduce 在启动task时相比需要更大的代价。 压缩你的数据结构 Spark 的数据流由一组record构成。一个record有两种表达形式:一种是反序列化的 Java 对象另外一种是序列化的二进制形式。通常情况下,Spark 对内存中的record使用反序列化之后的形式,对要存到磁盘上或者需要通过网络传输的record使用序列化之后的形式。也有计划在内存中存储序列化之后的record。 spark.serializer 控制这两种形式之间的转换的方式。Kryo serializer,org.apache.spark.serializer.KryoSerializer 是推荐的选择。但不幸的是它不是默认的配置,因为 KryoSerializer 在早期的 Spark 版本中不稳定,而 Spark 不想打破版本的兼容性,所以没有把 KryoSerializer 作为默认配置,但是 KryoSerializer 应该在任何情况下都是第一的选择。 你的record在这两种形式切换的频率对于 Spark 应用的运行效率具有很大的影响。去检查一下到处传递数据的类型,看看能否挤出一点水分是非常值得一试的。 过多的反序列化之后的record可能会导致数据到处到磁盘上更加频繁,也使得能够 Cache 在内存中的record个数减少。点击这里查看如何压缩这些数据。 过多的序列化之后的record导致更多的 磁盘和网络 IO,同样的也会使得能够 Cache 在内存中的record个数减少,这里主要的解决方案是把所有的用户自定义的 class 都通过SparkConf#registerKryoClasses的API定义和传递的。 数据格式 任何时候你都可以决定你的数据如何保持在磁盘上,使用可扩展的二进制格式比如:Avro,Parquet,Thrift或者Protobuf,从中选择一种。当人们在谈论在Hadoop上使用Avro,Thrift或者Protobuf时,都是认为每个record保持成一个 Avro/Thrift/Protobuf 结构保存成 sequence file。而不是JSON。 每次当时试图使用JSON存储大量数据时,还是先放弃吧... 本文转自阿凡卢博客园博客,原文链接:http://www.cnblogs.com/luxiaoxun/p/6361298.html,如需转载请自行联系原作者