前言
目前很多用户在阿里云es设置白名单都会比较迷糊,或者没有详细阅读官方文档设置错误,这里给大家梳理一下三大ip设置操作:ip白名单/ip黑名单,Kibana访问白名单,公网地址访问白名单
ip白名单/ip黑名单:
具体参考官网文档:
https://help.aliyun.com/document_detail/67848.html?spm=a2c4g.11186623.6.554.FRJsh8
这里要说明如下两点内容:
阿里云ES实例提供了商业版的 X-pack 插件,在使用阿里云ES实例内网地址访问相应Node时,增加了进一步的安全控制,用户可以通过配置IP黑/白名单的方式来控制对阿里云ES实例访问。
注意:
主要针对内网地址(VPC)访问控制。
通过内网地址来访问阿里云ES实例,如果一个节点的IP地址在IP黑名单上,X-Pack的安全性仍然允许该节点被链接,但请求将被直接抛弃不会被处理。
-------重点字样:内网地址,没错这个是用于内网地址ip控制的。
优先级
允许规则优先于拒绝规则。
-------如果想只允许少数ip访问,那么就需要黑白名单搭配使用,黑名单_all 设置,然后白名单配置允许访问ip。
Kibana访问白名单
具体参考官网文档:
https://help.aliyun.com/document_detail/86330.html?spm=a2c4g.11186623.6.557.0IvuU2
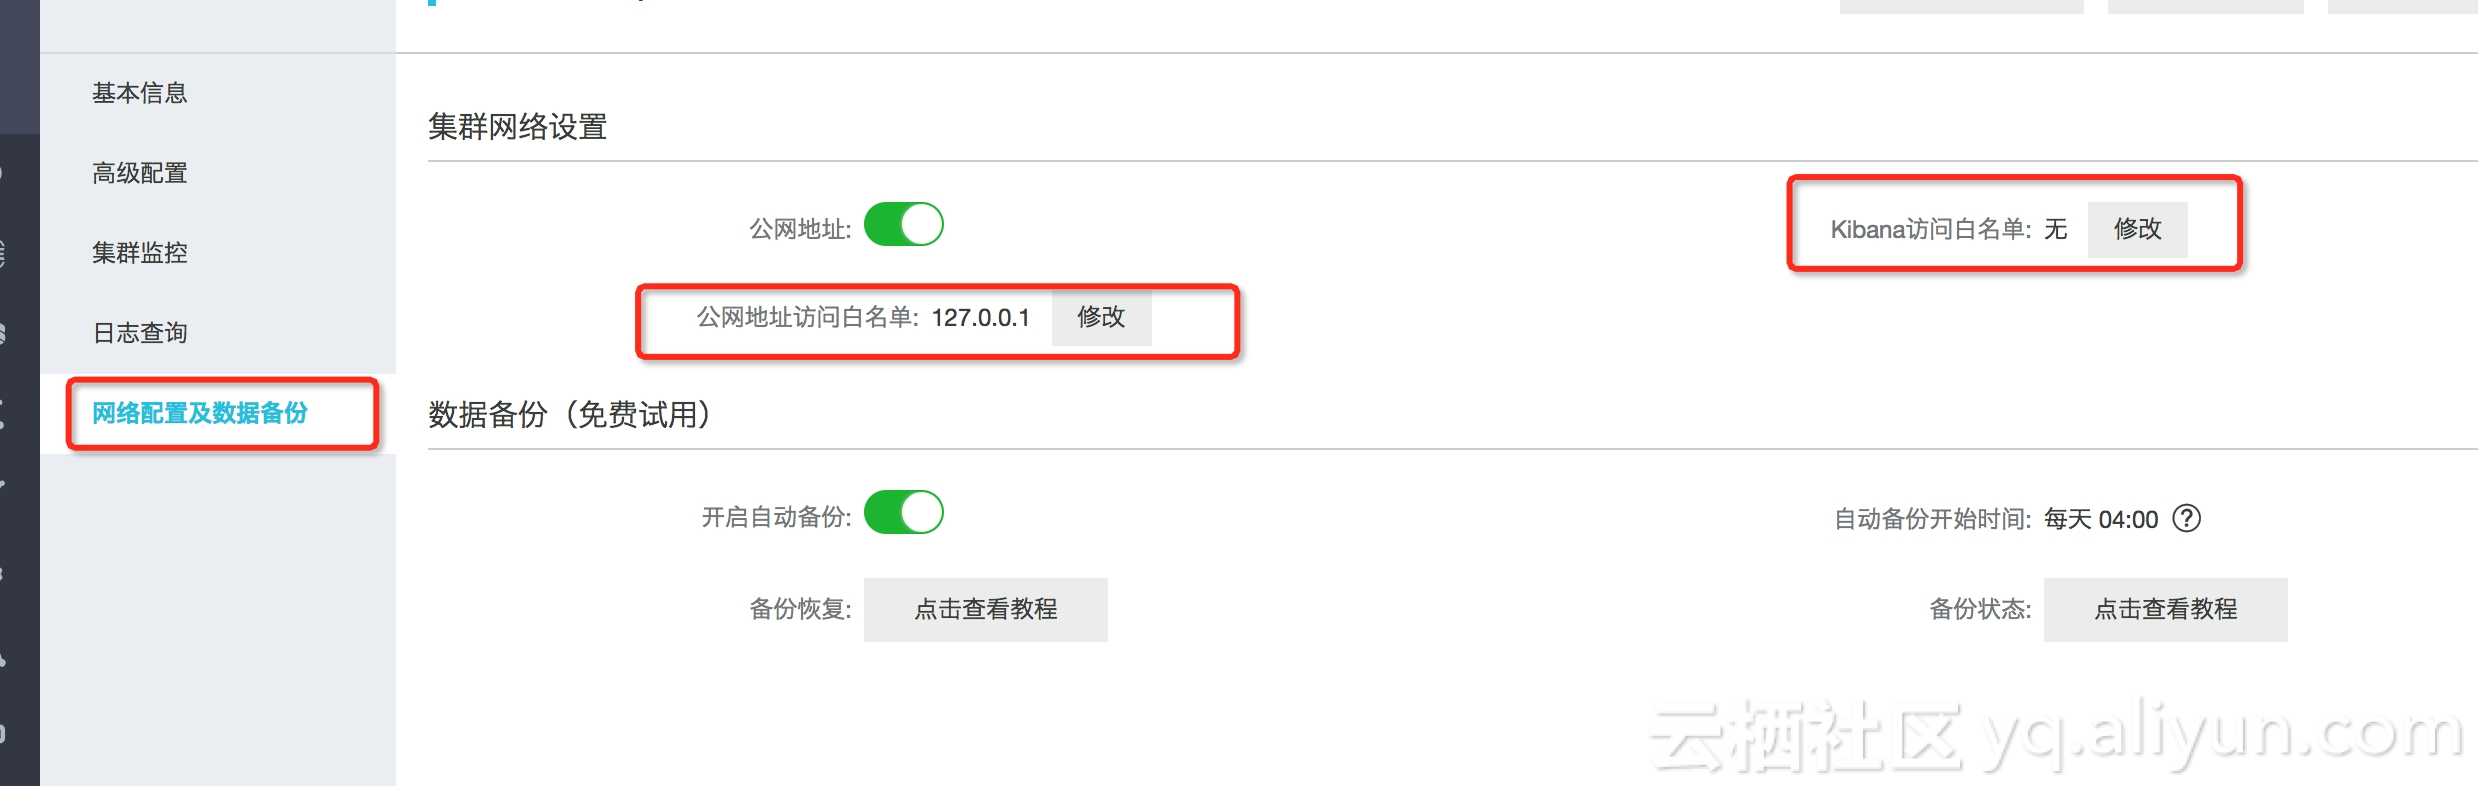
这个没有没有特殊操作,就是配置Kibana访问的。主要在无法访问Kibana重点关注这个。
支持配置单个IP或IP网段的形式,格式为192.168.0.1或192.168.0.1/24,多个IP之间用英文逗号隔开。
注意:
- Kibana访问白名单,默认允许所有公网地址访问。
- Kibana访问白名单设置为 127.0.0.1,代表禁止所有地址访问。
- kibana访问控制只支持白名单。
公网地址访问白名单
具体参考官网文档:
https://help.aliyun.com/document_detail/86330.html?spm=a2c4g.11186623.6.557.0IvuU2
很多用户无法通过公网地址访问,主要就是没有配置公网地址访问白名单或者配置错误了ip。
公网地址开关按钮为绿色时表示启用,默认是关闭状态。
公网地址访问白名单
支持配置单个IP或IP网段的形式,格式为192.168.0.1或192.168.0.1/24,多个IP之间用英文逗号隔开。
注意:
公网地址访问白名单默认为 127.0.0.1,代表禁止所有地址访问。
公网地址访问控制只支持白名单。
不支持配置允许所有地址访问。
重要截图:
设置地方一定要正确哟,截图如下: