首页 文章 精选 留言 我的

精选列表

搜索[世界模型],共10004篇文章
优秀的个人博客,低调大师

Elasticsearch:无状态世界中的数据安全

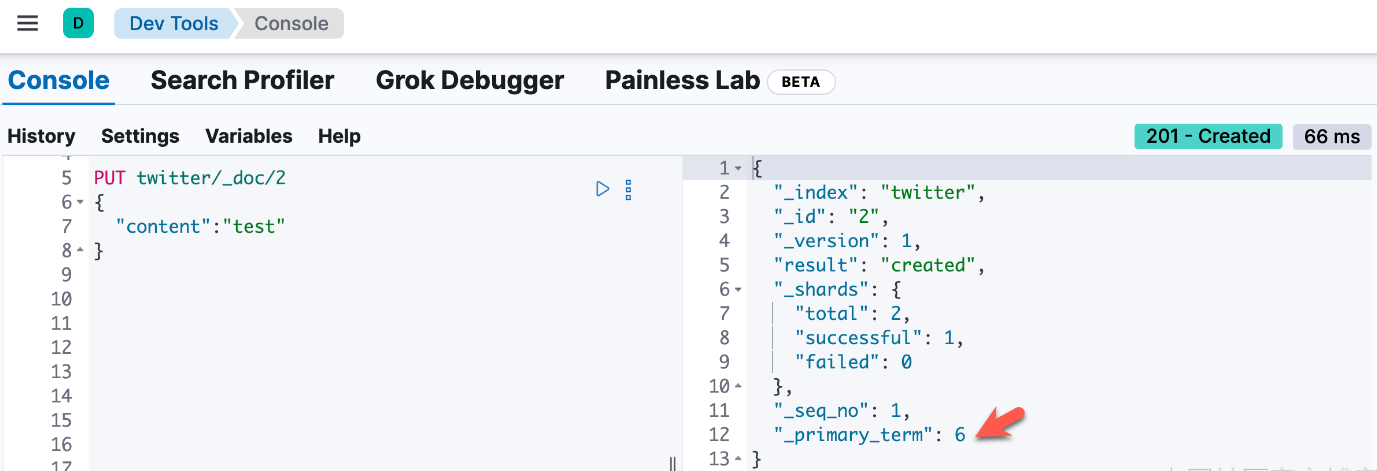
作者:来自 ElasticHenning Andersen 在最近的博客文章中,我们宣布了支持 Elastic Cloud Serverless 产品的无状态架构。通过将持久性保证和复制卸载到对象存储(例如 Amazon S3),我们获得了许多优势和简化。 从历史上看,Elasticsearch 依靠本地磁盘持久性来确保数据安全并处理陈旧或孤立的节点。在本博客中,我们将讨论无状态的数据持久性保证,包括我们如何使用安全检查隔离新的写入和删除,以防止陈旧节点不安全地确认这些操作。 在以下博客文章中,我们将介绍持久性承诺的基础知识以及 Elasticsearch 如何使用操作日志 (translog) 来快速安全地确认对客户端的写入。接下来,我们将深入研究问题,介绍对我们有帮助的概念,最后解释额外的安全检查,使我们能够自信地确认对客户端的写入。 持久性承诺和 translog 当客户端将数据写入 Elasticsearch 时(例如使用 _bulk API),Elasticsearch 将为该请求提供 HTTP 响应代码。Elasticsearch 仅在数据已安全存储时才提供成功的 HTTP 响应代码 (200/201)。我们使用操作日志(称为 translog),请求在确认写入之前附加并存储在其中。translog 允许我们重放未成功持久化到底层 Lucene 索引的操作(例如,如果在我们确认写入到客户端后节点崩溃)。有关 translog 和 Lucene 索引的更多信息,请参阅我们最近关于薄索引分片的博客文章中的此部分,其中我们解释了我们现在如何在对象存储中存储 Lucene 索引和 translog。 不知道是最糟糕的 - 问题 主节点将分片分配给索引节点,然后该节点负责将传入的数据索引到该分片中。但是,我们必须考虑此节点与主节点和/或集群其余部分失去通信的情况。 在这种情况下,主节点将(在超时后)假定该节点不再运行,并将受影响的分片重新分配给其他节点。先前的分配现在将被视为过时或陈旧(stale)。过时的节点可能仍在运行,试图索引和保存它收到的数据。 在这种情况下,可能有两个分片所有者试图确认写入但彼此失去通信,我们有两个问题需要解决: 避免对象存储中的文件覆盖 确保已确认的写入不会丢失 Primary terms - 数量增加以求得救 Elasticsearch 多年来一直使用我们称为 primary terms 的东西。每当将主分片分配给节点时,都会为其分配一个 primary term。如果主分片发生故障或从未分配(unassigned)变为已分配(assiined),主服务器(master)将在重新分配主分片之前增加 promary term 的值。这给出了主分片分配和所有权的严格顺序,在较低的 primary terms 之后分配较高的 primary terms。 对于无状态(stateless),我们在写入对象存储的索引文件路径中使用 primary terms,以确保不会发生上述第一个问题。如果分片发生故障并被重新分配,我们知道它将具有更高的 primary term。分片只会在 primary term 特定的路径中写入文件,因此较旧的分片分配和较新的分片分配不可能写入相同的文件。它们只是写入不同的路径。 Primary term 也用于最终提供耐用性保证,稍后会详细介绍。 请注意,主分片重定位不会增加 primary term 的值,而是涉及主分片重定位的两个节点通过明确的协议交接所有权。 Coordination term 和节点离开生成(node-left generation) Elasticsearch 中的协调子系统是一种用于集群级别协调的强一致性机制,包括集群成员资格和集群元数据(均称为集群状态)。 在无状态(stateless)中,此系统还建立在对象存储之上,上传新的集群状态版本。与有状态一样,它为称为 “term” 的选举维护一个不断增加的数字(我们在此将其称为 coordination term,以将其与上一节中描述的primary term 区分开来)。每当一个节点决定开始新的选举时,它都会在新的 coordination term 内这样做,该 term 高于之前看到的任何 term(有关有状态中此工作的更多详细信息,请参阅此处的博客文章)。 在无状态中,选举通过我们称为租约(lease file)文件的对象存储文件进行。此文件包含 coordination term 和声称该 term 是该 term 的当选主节点的节点。 此文件将有助于我们在此处感兴趣的安全检查。如果 coordination term 仍然相同,我们就知道当选主节点没有改变。 然而,仅有协调项是不够的,因为即使节点离开集群,这也不一定会发生改变。为了检测数据节点是否未离开集群,我们还将节点离开生成添加到租约文件中。这是一个递增的数字,每次节点离开集群时都会增加。当 term 发生变化时,它会从零重置(但在这里我们可以忽略这一点)。 租约文件作为持久化新集群状态的一部分写入对象存储。此写入发生在根据新集群状态采取任何操作(如分片恢复)之前。 对象存储先读后写语义 我们使用对象存储以无状态存储所有数据,因此对象存储的可见性保证非常重要。最终,安全检查建立在这些保证之上。 以下是我们依赖的主要对象存储可见性保证: 先读后写:成功写入后,任何读取都将返回新内容。 先列表后写入:成功写入后,任何与新文件匹配的列表都将返回该文件。 这些在几年前并不是必然的,但现在已在 AWS S3、GCP 和 Azure blob 存储中提供。 安全检查 有了上述必要的构建块,我们现在可以进行实际的安全检查和安全论证。虽然 translog 保证了写入的持久性,但在确认写入之前,我们需要确保节点仍然是指定的索引节点。事实来源是集群状态,因此数据节点需要确定它具有足够新的集群状态,以确定确认写入是否安全。 我们只对非优雅事件感兴趣,例如节点崩溃、网络分区等。分片重定位等优雅事件通过显式交接来处理,以保证其正确性(我们不会在本篇博文中深入讨论这个问题)。 让我们考虑一个非优雅事件,例如主节点检测到保存分片的数据节点不再响应,因此它将节点从集群中弹出。我们将在这种情况下检查安全检查,看看它如何避免陈旧的节点可能错误地确认对客户端的写入。 安全检查在响应客户端之前添加了一项额外检查: 从对象存储中读取租约文件。如果 coordination term 或节点左代已超过节点本地集群状态中的值,则它不能依赖集群状态,直到收到具有更高或相等coordination term 和节点离开生成的更新版本。有了足够新的集群状态,可以使用它来检查分片的 primary term 是否已更改。如果已更改,则写入将失败。 在理想情况下,这里不会有任何等待,因为与正常写请求的频率相比,term 和节点离开生成的变化非常不频繁。因此,这个检查的开销很小。 请注意,顺序是重要的:在安全检查之前,translog 文件已经成功上传。稍后我们将解释原因。 非正常的节点离开事件会导致租约文件中的节点离开生成编号递增。之后,一个新节点可能会被分配到该分片并开始恢复数据(这可能只是一次集群状态更新,但这里唯一重要的部分是租约文件写入和节点开始恢复的顺序,这一点是有保证的)。 新分配的节点随后会读取分片数据并恢复 translog 中包含的数据。 我们看到事件的顺序如下: 原始数据节点在读取租约文件之前写入 translog。 主节点在新数据节点开始恢复之前(因此也在读取 translog 之前)将递增的节点离开生成写入租约文件。 对象存储保证了对租约文件和 translog 文件的先读后写(read-after-write)。 这里需要考虑两种主要情况: 原始数据节点写入了 translog 文件,并读取了一个租约文件,表明它仍在集群中且是分片的拥有者(primary term 没有改变)。 我们可以确定主节点在数据节点读取之前未成功更新租约文件。因此,原始数据节点对 translog 的写入发生在新节点分配读取 translog 之前,保证这些操作可供新节点进行恢复。 原始数据节点写入了 translog 文件,但在等待租约文件中的信息反映的新集群状态后,它不再是分片的拥有者(导致写入请求失败)。 我们不会成功响应该写入请求,因此不会承诺持久性。 translog 数据可能在恢复期间对新节点分配可用,但这没问题。写入失败的请求实际上持久化了数据,这也是可以接受的。 因此,我们可以看到,Elasticsearch 成功响应的任何写入将对同一分片的未来拥有者可用,进而证明了我们的安全性论点。 同样,我们可以论证主节点故障转移的情况也是安全的。在这种情况下,coordination term 而不是节点离开生成会发生变化。我们这里不再详细说明。 这种相同的安全检查也应用于其他一些关键情况: 在索引文件删除期间。当 Lucene 合并段时,旧段可以被删除。我们在这里添加了安全检查,以防止删除新节点分配可能需要的文件。 在 translog 文件删除期间。当对象存储中的索引数据包含所有操作时,translog 可以被删除。同样,我们在这里添加了安全检查,以防止删除新节点分配可能需要的 translog 文件。 结论 恭喜,你已经读到了最后,希望你喜欢这里的深入研究。我们描述了一种新颖的机制,用于确保 Elasticsearch 持久安全地将写入持久化到对象存储,即使在出现任何类型的中断导致 Elasticsearch 有两个节点拥有对同一分片的索引的情况下也是如此。我们非常关心这些方面,如果你也这样做,也许可以看看我们的开放职位。 向 David Turner、Francisco Fernández Castaño 和 Tim Brooks 致敬,他们在这里完成了大部分实际工作。 准备好自己尝试一下了吗?开始免费试用。 想要获得 Elastic 认证?了解下一次 Elasticsearch 工程师培训何时开始! 原文:Data safety in a stateless world — Search Labs

优秀的个人博客,低调大师

Awfice —— 世界上最小的 Office 套件

Awfice 是一系列微型办公套件应用程序: 文字处理器、电子表格、绘图应用程序和演示文稿制作工具 每个小于 1KB 的纯 JavaScript 每个实际上只是一行代码 打包为数据 URL,因此你可以立即使用它们,无需下载或安装 你也可以离线使用它们 但是它们不能存储它们的状态,所以无论你输入什么都会在页面刷新时丢失 也可以作为“保护你的隐私”功能出售 保存作业的唯一方法是保存 HTML 或将其发送到打印机/打印为 PDF。 文本编辑器 - 59 字节 一个简单的富文本编辑器。输入任何你想要的,它不会被保存在任何地方,但它可能对快速一次性笔记很方便。你应该能够使用 Ctrl+B 和 Ctrl+I 将文本选择标记为粗体或斜体。撤消/重做也应该有效。你还可以从其他来源复制/粘贴文本和图像。 复制并添加到书签或在 URL 栏中打开: data:text/html,<body contenteditable style=line-height:1.5;font-size:20px> 尝试一下 电子表格 - 679 字节 带有数学公式的非常基本的电子表格。它有 100 行和 26 列 (A..Z)。如果单元格中的值以“=”开头,则将其计算为公式。你可以参考其他单元格值,即“=(A10+A11)/A12”。在引擎盖下它使用 eval(),所以要小心。 复制并添加到书签或在 URL 栏中打开: data:text/html,<table id=t><script>z=Object.defineProperty,p=parseFloat;for(I=[],D={},C={},q=_=>I.forEach(e=>{try{e.value=D[e.id]}catch(e){}}),i=0;i<101;i++)for(r=t.insertRow(-1),j=0;j<27;j++)c=String.fromCharCode(65+j-1),d=r.insertCell(-1),d.innerHTML=i?j?"":i:c,i*j&&I.push(d.appendChild((f=>(f.id=c+i,f.onfocus=e=>f.value=C[f.id]||"",f.onblur=e=>{C[f.id]=f.value,q()},get=_=>{v=C[f.id]||"";if("="!=v.charAt(0))return isNaN(p(v))?v:p(v);with(D)return eval(v.slice(1))},a={get},z(D,f.id,a),z(D,f.id.toLowerCase(),a),f))(document.createElement`input`)))</script><style>#t{border-collapse:collapse}td{border:1px solid gray;text-align:right}input{border:none;width:4rem;text-align:center}</style> 尝试一下 绘图应用程序 - 327 字节 复制并添加到书签或在 URL 栏中打开: data:text/html,<canvas id=v><script>d=document,d.body.style.margin=0,P="onpointer",c=v.getContext`2d`,v.width=innerWidth,v.height=innerHeight,c.lineWidth=2,f=0,d[P+"down"]=e=>{f=e.pointerId+1;e.preventDefault();c.beginPath();c.moveTo(e.x,e.y)};d[P+"move"]=e=>{f==e.pointerId+1&&c.lineTo(e.x,e.y);c.stroke()},d[P+"up"]=_=>f=0</script></canvas> 尝试一下

优秀的个人博客,低调大师

React 世界的一等公民 - 组件

Choerodon猪齿鱼平台使用 React 作为前端应用框架,对前端的展示做了一定的封装和处理,并配套提供了前端组件库Choerodon UI。结合实际业务情况,不断对组件优化设计,提高代码质量。 本文将结合Choerodon猪齿鱼平台使用案例,简单说明组件的分类、设计原则和设计模式,帮助开发者在不同场景下选择正确的设计和方案编写组件(示例代码基于ES6/ES7的语法,适于有一定前端基础的读者)。 本文作者:Choerodon猪齿鱼社区 王柯 文章的主要内容包括: React 组件简介 组件分类 组件设计原则、最佳实践 组件设计模式简介 React 组件简介 React是指用于构建用户界面的 JavaScript 库。换言之,React是一个构建视图层的类库(或框架)。不管 React 本身如何复杂,不管其生态如何庞大,构建视图始终是它的核心。 可以用个公式说明: UI = f(data) React的基础原则有三条,分别是: React 界面完全由数据驱动; React 中一切都是组件; props 是 React 组件之间通讯的基本方式。 那么组件又是什么? 组件是一个函数或者一个 Class(当然 Class 也是 function),它根据输入参数,最终返回一个 React Element。简单地说,React Element 描述了“你想”在屏幕上看到的事物。抽象地说,React Element 元素是一个描述了 Dom Node 的对象。 所以实际上使用 React Component 来生成 React Element,对于开发体验有巨大的提升,比如不需要手写React.createElement等。 那么所有 React Component 都需要返回 React Element 吗?显然是不需要的。 return null; 或者返回其他的 React 组件都有存在的意义,它能完成并实现很多巧妙的设计、思想和副作用,在下文会有所扩展。 可以说,在 React 中一切皆为组件: 用户界面就是组件; 组件可以嵌套包装组成复杂功能; 组件可以用来实现副作用。 React 也提供了多种编写组件的方法适用于各种场景实例。 组件分类 如何在场景下快速正确地选择组件设计模式和方案,首先得有一个自己接受和常用的组件分类,以便从分类中快速确定编写方法,再考虑设计模式等后续问题。 Vue的作者尤雨溪在一场Live中也表达过自己对前端组件的看法,“组件可以是函数,是有分类的。”从功能维度对组件进行了分类,这四种分类方式也适用于Choerodon猪齿鱼前端开发中的业务场景: 纯展示型组件:数据进,DOM出,直观明了 接入型组件:在React场景下的container component,这种组件会跟数据层的service打交道,会包含一些跟服务器或者说数据源打交道的逻辑,container会把数据向下传递给展示型组件、 交互型组件:典型的例子是对于表单组件的封装和加强,大部分的组件库都是以交互型组件为主,比如说Element UI,特点是有比较复杂的交互逻辑,但是是比较通用的逻辑,强调组件的复用 功能型组件:以Vue的应用场景举例,路由的router-view组件、transition组件,本身并不渲染任何内容,是一个逻辑型的东西,作为一种扩展或者是抽象机制存在 在此以Choerodon猪齿鱼平台的一个创建界面来分析。 红色布局:功能型组件 蓝色菜单:交互型组件,菜单项:遍历菜单数据输出DOM的纯展示型组件 右块内容:接入型组件(容器组件) Table、btn等:交互型组件 可以看到,一个复杂界面可以分割成很多简单或复杂的组件,复杂组件还包括子组件等。此外,除了从功能维度对组件进行划分,也可以从开发者对组件的使用习惯进行分类(以下分类非对立关系): 无状态组件 有状态组件 容器组件 高阶组件 Render Callback组件 简单说明一下几种组件: 无状态组件:无状态组件(Stateless Component)是最基础的组件形式,由于没有状态的影响所以就是纯静态展示的作用。基本组成结构就是属性(props)加上一个渲染函数(render)。由于不涉及到状态的更新,所以这种组件的复用性也最强。例如在各UI库中开发的按钮、输入框、图标等等。 有状态组件:组件内部包含状态(state)且状态随着事件或者外部的消息而发生改变的时候,这就构成了有状态组件(Stateful Component)。有状态组件通常会带有生命周期(lifecycle),用以在不同的时刻触发状态的更新。在写业务逻辑时常用到,不同场景所用的状态和生命周期也会不同。 容器组件:为使组件的职责更加单一,耦合性进一步地降低,引入了容器组件(Container Component)的概念。重要负责对数据获取以及处理的逻辑。下文的设计模式也会提到。 高阶组件:“高阶组件(HoC)”也算是种组件设计模式。做为一个高阶组件,可以在原有组件的基础上,对其增加新的功能和行为。如打印日志,获取数据和校验数据等和展示无关的逻辑的时候,抽象出一个高阶组件,用以给基础的组件增加这些功能,减少公共的代码。 Render Callback组件:组件模式是在组件中使用渲染回调的方式,将组件中的渲染逻辑委托给其子组件。也是种重用组件逻辑的方式,也叫render props 模式。 以上这些组件编写模式基本上可以覆盖目前工作中所需要的模式。在写一些复杂的框架组件的时候,仔细设计和研究组件间的解耦和组合方式,能够使后续的项目可维护性大大增强。 对立的两大分类: 基于类的组件:基于类的组件(Class based components)是包含状态和方法的。 基于函数的组件:基于函数的组件(Functional Components)是没有状态和方法的。它们是纯粹的、易读的。尽可能的使用它们。 当然,React v16.7.0-alpha 中第一次引入了 Hooks 的概念,Hooks 的目的是让开发者不需要再用 class 来实现组件。这是React的未来,基于函数的组件也可处理状态。 了解了这些以后就需要有一个自己开发新组件前的思考,遵循组件设计原则,快速确定分类开始编写Code。 设计原则/最佳实践 React 的组件其实是软件设计中的模块,其设计原则也需遵从通用的组件设计原则,简单说来,就是要减少组件之间的耦合性(Coupling),让组件简单,这样才能让整体系统易于理解、易于维护。 即,设计原则: 接口小,props 数量少; 划分组件,充分利用组合(composition); 把 state 往上层组件提取,让下层组件只需要实现为纯函数。 就像搭积木,复杂的应用和组件都是由简单的界面和组件组成的。划分组件也没有绝对的方法,选择在当下场景合适的方式划分,充分利用组合即可。实际编写代码也是逐步精进的过程,努力做到: 功能正常; 代码整洁; 高性能。 取Choerodon猪齿鱼平台Devops项目的应用管理模块实例,导入应用: 这个界面看起来很简单,功能简介 + 导入步骤条,实际因为存在步骤条,内容很丰富。 首先组件叫做AppImport,组件内包含简介和步骤条,需要记录当前步骤条第几步状态’current‘,所以需要维持状态(state),可以肯定,AppImport 是一个有状态的组件,不能只是一个纯函数,而是一个继承自 Component 的类。 class AppImport extends React.Component { constructor() { super(...arguments); this.state = { current: 0, }; } render() { //TODO: 返回所有JSX } } 接下来划分组件,按照数据边界来分割组件: 使用了choerodon-front-boot 中定义好的容器组件,Page、Header、Content; 渲染 Header,返回上级菜单,渲染当前界面title。 渲染 Content,封装好的组件处理了导入应用和其详情简介; 渲染 Steps 卡片,步骤条卡片渲染,state 为当前步以及后续需要导入提交的数据 data; 最后,Steps 每一步数据需求都不同,均拆成单独子组件。 在 React 中,有一个误区,就是把 render 中的代码分拆到多个 renderXXXX 函数中去,比如下面这样: class AppImport extends React.Component { render() { const Header = this.renderHeader(); const Content = this.renderContent(); const Steps = this.renderSteps(); return ( <Page> {Header} {Content} {Steps} </Page> ); } renderHeader() { //TODO: 返回上级菜单,渲染当前界面title } renderContent() { //TODO: 导入应用和其详情简介 } renderSteps() { //TODO: 返回步骤条卡片 } } 用上面的方法组织代码,当然比写一个巨大的 render 函数要强,但是,实现这么多 renderXXXX 函数并不是一个明智之举,因为这些 renderXXXX 函数访问的是同样的 props 和 state,这样代码依然耦合在了一起。更好的方法是把这些 renderXXXX 重构成各自独立的 React 组件,像下面这样 class AppImport extends React.Component { constructor() { super(...arguments); this.state = { data: {}, current: 0, }; } next = () => {} cancel = () => {} render() { return ( <Page> <Header title='xxx' backPath='xxxxxx' /> <Content code="app.import" values={{ appName }}> <div className="c7n-app-import-wrap"> <Steps current={current} className="steps-line"> <Step key={item.key} title={item.title} /> </Steps> <div className="steps-content"> <Step0 onNext={this.next} onCancel={this.cancel} values={data} /> </div> </div> </Content> </Page> ); } } const Step = (props) => { //TODO: 返回步骤条Content }; const Steps = (props) => { //TODO: Steps }; const Page = (props) => { //TODO: Page } // Header / Content // 根据代码量,尽量每个组件都有自己专属的源代码文件 导出,再导入 // 示例代码中 Page、Header、Content 使用了choerodon-front-boot 中定义好的容器组件, // Steps 使用了choerodon-ui 库 // 所以在头部导入即可 // import { Steps } from 'choerodon-ui'; // import { Content, Header, Page } from 'choerodon-front-boot'; 实际情况下,步骤条不止一步,处理函数也不止那么简单,但是经过划分和抽取,作为展示组件的 AppImport 结构清晰,代码整洁,接口少(props只涉及公共的 store、history 等 )。再处理下StepN(子组件根据实际内容处理,这里略过),整个 AppImport 代码不超过150行,相比不划分组件,代码随便超过1000+行,划分优化后思路清晰,可维护性高。 最终代码: import React, { Component, Fragment } from 'react'; import { observer } from 'mobx-react'; import { withRouter } from 'react-router-dom'; import { injectIntl, FormattedMessage } from 'react-intl'; import { Steps } from 'choerodon-ui'; import { Content, Header, Page, stores } from 'choerodon-front-boot'; import '../../../main.scss'; import './AppImport.scss'; import { Step0, Step1, Step2, Step3 } from './steps/index'; const { AppState } = stores; const Step = Steps.Step; @observer class AppImport extends Component { constructor() { super(...arguments); this.state = { data: {}, current: 0, }; } next = (values) => { // 点击下一步处理函数,略 }; prev = () => { // 点击上一步处理函数,略 }; cancel = () => { // 点击取消处理函数,略 }; importApp = () => { // 点击导入,数据处理,略 }; render() { const { current, data } = this.state; // const ... const steps = [{ key: 'step0', title: <FormattedMessage id="app.import.step1" />, content: <Step0 onNext={this.next} onCancel={this.cancel} store={AppStore} values={data} />, }, { key: 'step1', title: <FormattedMessage id="app.import.step2" />, content: <Step1 onNext={this.next} onPrevious={this.prev} onCancel={this.cancel} store={AppStore} values={data} />, }, { key: 'step2', title: <FormattedMessage id="app.import.step3" />, content: <Step2 onNext={this.next} onPrevious={this.prev} onCancel={this.cancel} store={AppStore} values={data} />, }, { key: 'step3', title: <FormattedMessage id="app.import.step4" />, content: <Step3 onImport={this.importApp} onPrevious={this.prev} onCancel={this.cancel} store={AppStore} values={data} />, }]; return ( <Page> <Header title='xxx' backPath='xxxxxx' /> <Content code="app.import" values={{ name }}> <div className="c7n-app-import-wrap"> <Steps current={current} className="steps-line"> {steps.map(item => <Step key={item.key} title={item.title} />)} </Steps> <div className="steps-content">{steps[current].content}</div> </div> </Content> </Page> ); } } export default withRouter(injectIntl(AppImport)); 过程中会接触到一些最佳实践和技巧: 避免 renderXXXX 函数 给回调函数类型的 props 加统一前缀(onNext、onXXX 或 handleXXX 规范,可读性好) 使用 propTypes 来定义组件的 props 尽量每个组件都有自己专属的源代码文件(StepN) 用解构赋值(destructuring assignment)的方法获取参数 props 的每个属性值 利用属性初始化(property initializer)来定义 state 和成员函数 组件设计模式 不同的业务情境下使用合适的设计模式能大大提高开发效率和可维护性。了解以上内容后能更好的理解和选择设计模式。 常用的设计模式有: 容器组件和展示组件(Container and Presentational Components); 高阶组件; render props 模式; 提供者模式(Provider Pattern); 组合组件。 网上介绍这些模式的文章有很多,每个模式都可以长篇详解。但是,模式就是特定于一种问题场景的解决办法。 模式(Pattern) = 问题场景(Context) + 解决办法(Solution) 明确使用场景才能正确发挥模式的功能。所以,简单介绍一下各模式实际应用于什么场景较好。 容器组件和展示组件 React最简单也是最常用的一种组件模式就是“容器组件和展示组件”。其本质就是把一个功能分配到两个组件中,形成父子关系,外层的父组件负责管理数据状态,内层的子组件只负责展示,让一个模块都专注于一个功能,这样更利于代码的维护。 上文步骤条的实例就是把获取和管理数据这件事和界面渲染这件事分开。做法就是,把获取和管理数据的逻辑放在父组件,也就是容器组件;把渲染界面的逻辑放在子组件,也就是展示组件。有关数据处理的变动就只需要对容器组件进行修改,例如修改数据状态管理方式,完全不影响展示组件。 高阶组件 高阶组件适用场景于“不要重复自己”(DRY,Don't Repeat Yourself)编码原则,某些功能是多个组件通用的,在每个组件都重复实现逻辑,浪费、可维护行低。第一想法是共用逻辑提取为一个 React 组件,但是共用逻辑单独无法使用,不足以抽象成组件,仅仅是对其他组件的功能加强。当然,高阶组件并不是 React 中唯一的重用组件逻辑的方式,下文的 render props 模式也可处理。 例如,很多网站应用,有些模块都需要在用户已经登录的情况下才显示。比如,对于一个电商类网站,“退出登录”按钮、“购物车”这些模块,就只有用户登录之后才显示,对应这些模块的 React 组件如果连“只有在登录时才显示”的功能都重复实现,那就浪费了。 render props 模式 所谓 render props,指的是让 React 组件的 props 支持函数这种模式。因为作为 props 传入的函数往往被用来渲染一部分界面,所以这种模式被称为 render props。适用场景和高阶组件差不多,但是与其还是有一些差别: render props 模式的应用,是一个 React 组件,而高阶组件,虽然名为“组件”,其实只是一个产生 React 组件的函数 高阶组件可链式调用,因为实质是函数 render props 相对于高阶组件还有一个显著优势,就是对于新增的 props 更加灵活 所以以上对比,当需要重用 React 组件的逻辑时,建议首先看这个功能是否可以抽象为一个简单的组件;如果行不通的话,考虑是否可以应用 render props 模式;再不行的话,才考虑应用高阶组件模式。当然,没有绝对的使用顺序,实际场景为准。 提供者模式 在 React 中,props 是组件之间通讯的主要手段,但是,有一种场景单纯靠 props 来通讯是不恰当的,那就是两个组件之间间隔着多层其他组件。避免 props 逐级传递,即是提供者模式的适用场景。实现方式也分老Context API和新Context API。新版本的 Context API 才是未来,在 React v17 中,可能就会删除对老版 Context API 的支持,所以,现在大家都应该使用第二种实现方式。新版API详解。 典型用例就是实现“样式主题”(Theme),多语言支持等。 组合组件 组合组件模式要解决的是这样一类问题:父组件想要传递一些信息给子组件,但是,如果用 props 传递又显得十分麻烦。利用 Context?当然还有其他解决方案,就是组合组件模式。 应用组合组件场景的往往是共享组件库,把一些常用的功能封装在组件里,让应用层直接用就行。在 antd 和 bootstrap 这样的共享库中,都使用了组合组件这种模式。将复杂度都封装起来了,从使用者角度,连 props 都看不见。实例扩展。 总 结 对前端来说,前端不是不用设计模式,而是已经把设计模式融入到了开发的基础当中。Choerodon猪齿鱼平台前端真实的业务场景往往需要应用多个设计模式,界面也会包含多个大小不一的组件。开发设计时,符合程序设计的原则:「高内聚,低耦合」即可。本文只是简单总结,提供一些思路和简单的应用场景给开发者,真正的熟练把握和应用还得多实践开发使用,多对自己欠缺的知识点去深挖学习和思考,不断进步。 参考/引用资料: React 官网 尤雨溪不吹不黑聊聊前端框架 程墨React 实战:设计模式和最佳实践 掌握高级的React设计模式: 复合组件【译】 Reacts-new-context-api 关于Choerodon猪齿鱼 Choerodon猪齿鱼作为开源多云应用平台,是基于Kubernetes的容器编排和管理能力,整合DevOps工具链、微服务和移动应用框架,来帮助企业实现敏捷化的应用交付和自动化的运营管理,同时提供IoT、支付、数据、智能洞察、企业应用市场等业务组件,致力帮助企业聚焦于业务,加速数字化转型。 大家也可以通过以下社区途径了解猪齿鱼的最新动态、产品特性,以及参与社区贡献: 官网:http://choerodon.io 论坛:http://forum.choerodon.io Github:https://github.com/choerodon 微信:Choerodon猪齿鱼 微博:Choerodon猪齿鱼 欢迎加入Choerodon猪齿鱼社区,共同为企业数字化服务打造一个开放的生态平台。

优秀的个人博客,低调大师

python是世界上最好的语言

艾玛,起这个标题真不怕被人捶的(ノへ ̄、) 通过《数据结构》课程上的作业——(拓展)约瑟夫环问题的C语言版本和python版本来比较一下python是多么的简洁优雅。 Josephus来历: 据说著名犹太历史学家 Josephus有过以下的故事:在罗马人占领乔塔帕特后,39 个犹太人与Josephus及他的朋友躲到一个洞中,39个犹太人决定宁愿死也不要被敌人抓到,于是决定了一个自杀方式,41个人排成一个圆圈,由第1个人开始报数,每报数到第3人该人就必须自杀,然后再由下一个重新报数,直到所有人都自杀身亡为止。然而Josephus 和他的朋友并不想遵从。这个过程沿着圆圈一直进行,直到最终只剩下一个人留下,这个人就可以继续活着。问题是,给定了和,一开始要站在什么地方才能避免被处决?Josephus要他的朋友先假装遵从,他将朋友与自己安排在第16个与第31个位置,于是逃过了这场死亡游戏。平常的Josephus问题这里不再啰嗦了,以后看心情可能会补充~直接看我们数据结构的作业吧! 题目:约瑟夫环(Joseph) ① 问题描述:编号为1到n的n个人,按顺时针方向围成一个环(循环单链表),每人都持有一个密码(正整数)。任选一个正整数作为报数的上限(设为m),从第一个人开始按顺时针方向从1开始顺序报数,当报到m时,暂停报数并输出其标识(位序),同时将报数为m的人删除,并将他的密码作为新的m值,继续从1开始重新报数,直到m并输出。如此重复,直到全部人员都从队列中输出。编写程序,求出该出列顺序。② 利用循环单链表实现这个过程,单链表的结点约定如下:Typedef struct LNode {int IDCode; // 人员标识int PWD; // 人员密码struct Lnode *next; // 指针域} LNode, *LinkList;其中,L为不带头结点的单链表的头指针,mi是第i个人的密码(1≤i≤n)。请按这个约定编程。③ 测试数据:20≤n≤30要求:参数n和m从键盘上输入,同时输入每个人的密码,存放在数组PWD中,利用这些参数构建单链表并完成出列顺序的输出。输入的次序为人员标识(位序)。④ 主程序约定如下:main () { //以下仅仅是描述,请大家按照要求完善代码int PWD[30]; //定义密码数组printf(“输入人员数n”);scanf(%d,n);printf(“输入初始密码m”);scanf(%d,m);p=createJoseph( int n , int PWD); //建立Joseph环,返回指向最后一个结点的指针pprintIDCode(LinkList P , int m); //输出每个人员的编号,当m大于n时,应该取n的模printf(“以上是张三的运行结果。”);}⑤ 提升练习 构造顺序文件存放人员密码,根据n读取前n个数据作为密码,实现以上功能; 最后建立的p结点的指针,指向了前面的某一个元素结点(未必是第一个),请按上述要求,输出环中的所有人员标识符。 人丑话不多,直接上代码,如有疑问,请在最下方留言,一定尽力回复! C语言版: #include<stdio.h> #include<stdlib.h> typedef struct LNode{ int IDCoder; int PWD; struct LNode *next; }LNode,*LinkList; int PWD[100],n,m; void initpwd(){ FILE * r=fopen("data.txt","r");//把data和编译出来的应用程序放在同一个文件夹中 if(r==NULL){ printf("\nFailed to open the file"); exit(1); } int i=0; while(fscanf(r,"%d",&PWD[i])!=EOF&&i<n){ //printf("\n%d",PWD[i]); i++; } fclose(r); } LinkList createJoseph(int n,int PWD[]){ //创建Josephus int i=0; LinkList pHead=NULL; pHead=(LinkList)malloc(sizeof(LNode)); //头节点 pHead->PWD=PWD[i]; pHead->IDCoder=i+1; pHead->next=NULL; LinkList pCurr=NULL,pPrev=NULL; pPrev=pHead; while(--n){ pCurr=(LinkList)malloc(sizeof(LNode)); i++; pCurr->PWD=PWD[i]; pCurr->IDCoder=i+1; pPrev->next=pCurr; pPrev=pCurr; } pCurr->next=pHead; return pCurr; } /*void printLink(LinkList pTail){ LinkList pCurr; LinkList pHead=pTail->next; printf("%d ",pHead->IDCoder); pCurr=pHead->next; while(pCurr!=NULL){ if(pCurr->IDCoder==1){ break; } printf("%d",pCurr->IDCoder); pCurr=pCurr->next; } printf("\n"); }*/ /*void printIDCode(LinkList pTail,int m,int tot){//这是我第一次写的,虽然通过了老师的测试,但是还是觉得挺烦(其实一开始如果m=1会有bug--)。 LinkList pCurr,pPrev,pHead; pHead=pTail->next; int i=1,outNum=m; pCurr=pPrev=pHead; while(pCurr!=NULL){ if(i==outNum){ i=1; tot--; outNum=(pCurr->PWD-1)%tot+1; printf("\n%d",pCurr->IDCoder); pPrev->next=pCurr->next; free(pCurr); pCurr=pPrev->next; while(outNum==1&&tot>1){ i=1; tot--; outNum=(pCurr->PWD-1)%tot+1; printf("\n%d",pCurr->IDCoder); pPrev->next=pCurr->next; free(pCurr); pCurr=pPrev->next; } } pPrev=pCurr; pCurr=pCurr->next; if(pPrev==pCurr){ printf("\n%d",pCurr->IDCoder); free(pCurr); break; } i++; } } */ void printIDCode(LinkList pTail,int m,int tot){//这个是问了室友之后改的 int outNum=m; LinkList pCurr,pPrev,pHead; pHead=pTail->next; pCurr=pPrev=pHead; while(n>0){ if(m==1){ for(int i=1;i<n;i++){ pPrev=pPrev->next; } } for(int i=1;i<m-1;i++){ pPrev=pPrev->next; } pCurr=pPrev->next; pPrev->next=pCurr->next; printf("\n%d",pCurr->IDCoder); m=pCurr->PWD;//懒得优化了~ free(pCurr); pPrev=pPrev->next; n--; } } int main(){ LinkList pTail; printf("please input the number of people:"); scanf("%d",&n); printf("\nplease input pwd:"); scanf("%d",&m); initpwd(); pTail=createJoseph(n,PWD); printIDCode(pTail,m%n,n); printf("\nAuthor:KISS"); return 0; } Python版: #!coding:utf-8 circle=[]#人环,每个人密码在下面列表中 第n个人对应 txt[n-1] txt=[3,4,5,2,1,6,4,3,2,1,5,1,12,45,3,4,5,9,88,64,1,6,5,2,3,2,5,6,7,1,5,1,3,2,54,4,54,44,55,87,3,6,5,2,6,1,5,6,7,602,5,1,3,2,54,4,88,44,55,44,1,8,5,2,4,6,4,3,2,1,5,23,12,45,3,4,5,9,23,64,3,9,5,2,1,6,5,6,7,342,5,6,3,2,54,4,88,44,44,77] n,m=raw_input('n,m:').split(' ') class person():#人的属性 def __init__(self,n,p):#构造函数 self.number=n self.password=p for i in range(int(n)):#构造人 circle.append(person(i+1,txt[i])) curindex=0#从第一个人开始 for i in range(int(n)):#开始杀人了 curindex=(curindex+int(m)-1)%len(circle)#循环列表 print str(circle[curindex].number)#显示被杀的人 m=circle[curindex].password#根据人的密码修改m del circle[curindex]#杀人ing

优秀的个人博客,低调大师

Windows赢了桌面,而Linux赢得整个世界

最坚决推行 Linux 桌面系统项目的城市正在转回 Windows 阵营,但 Linux 的命运已经不再与 PC 休戚相关。 慕尼黑的 Linux 项目只是开源软件故事中的一小部分 在实施从 Windows 系统迁移到 Linux 系统这一项目接近十年之久后,慕尼黑却突然走上了一条戏剧性的转弯。据说是到 2021 年,该城市的地方议会就会开始用 Windows 10 替换运行 LiMux (Ubuntu 的一种自定义版本)的 PC 机。 若是回到 15 或者 20 年前,人们可能会争论什么时候 Linux 将会在桌面上取代 Windows。例如,当 Ubuntu 于 2004 年问世时,它是带着 终结 Windows 的抱负 而被设计为标准的桌面操作系统的。 剧透:这一切并没有发生。 桌面上的 Linux 在今天占有约为 2% 的市场,很多人都认为它复杂晦涩。与此同时,Windows 则航行无虞,在 PC 市场笑傲群雄,天下十有其九。但在商业领域中总还有些许 Linux 桌面的身影,它仍被需要——尤其是对开发者和数据科学家而言。 但遗憾的是,它永远也不会成为历史的主流。 慕尼黑的 Linux 项目因其规模之大,引起了许多人的兴趣。几乎没有哪家大型组织会做出从 Windows 到 Linux 的迁移,一些个别的案例像 法国宪兵队和都灵市 曾有类似之举。然而,慕尼黑作为模范:在这一事件上的失败将会大大打击那些仍在 试图用 Linux 将 Windows 取而代之的信徒们。 但现实就是如此,绝大多数公司乐于去使用主流的桌面操作系统,因为它具有完整一致、用户友好这种优势。 工作人员所抱怨的问题中,有多少是归咎于 LiMux 软件以及多少是操作系统无端被责备的,已经不可计数。但重要的是,无论慕尼黑最后何去何从,Linux 的命运都已经脱离了桌面 —— 是的,Linux 在多年前就已经输掉了桌面战争。 但这对 Linux 来说无伤大雅,因为它赢得了智能手机之战,并且在云端和物联网之战上也是捷报连连。 你的口袋里,有七八成可能装的是一个 Linux 驱动的智能手机(Android 基于 Linux 内核)。你的身边,更是有成千上万 Linux 驱动的设备,虽然这些也许你甚至都没注意到。 像树莓派这样运行大量不同类型 Linux 的设备,正在创建一个充满热情和活力的开发者社区,并且提供给初创公司一种低成本的驱动新设备的方法。 大部分公有云也是以这样或那样的形式在 Linux 上运行的;即便是微软,也已经敞开大门,拥抱开源软件。无论你站在哪一个软件平台的立场,不可否认地,开发者和用户拥有更多丰富的可选项是一件好事,对决策来说,抑或是对创新来说,都是如此。 桌面的主导地位早已不再是当年模样了:它现在只是许多计算平台中的一个。事实上,PC 的软件也已经变得越来越不相关,因为更多的应用程序都在与设备和操作系统解耦,驻留在云中。 虽然慕尼黑传奇的曲折变换与 Linux 在桌面上的冒险耐人寻味,但它们却并未给你呈现出一个完整的故事。 本文作者:佚名 来源:51CTO

优秀的个人博客,低调大师

加入阿里云MVP —— 让世界听到你

六月上海云栖大会发布阿里云MVP计划以来, 承蒙大家信任和支持,我们收到了很多的申请,每一封申请我们都在仔细对待 大家的厚爱让我们更加坚定服务好开发者的信念 阿里云并不完美,阿里云想和MVP们一起,把阿里云产品体验做到最佳,并且给大家传递更多更经济更适用的实践方案 我们希望阿里云MVP们能够“先富带动后富”,从而实现大家的“共同富裕” ^_^ 请大家再让我啰嗦一次,什么是阿里云MVP? 阿里云最有价值专家,简称 MVP(Most Valuable Professional),是专注于帮助他人充分了解和使用阿里云技术的意见领袖 阿里云 MVP 奖项为我们提供了这样一个机会,向杰出的意见领袖表示感谢,更希望通过 MVP 将开发者的声音反映到我们的技术路线图上 你是我们要找的人吗? 是否想沉淀、分享自身经验? 很多人都有阶段性总结的习惯,古人也常说温故而

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册