首页 文章 精选 留言 我的

精选列表

搜索[并发编程],共10009篇文章
优秀的个人博客,低调大师

Java并发编程笔记之FutureTask源码分析

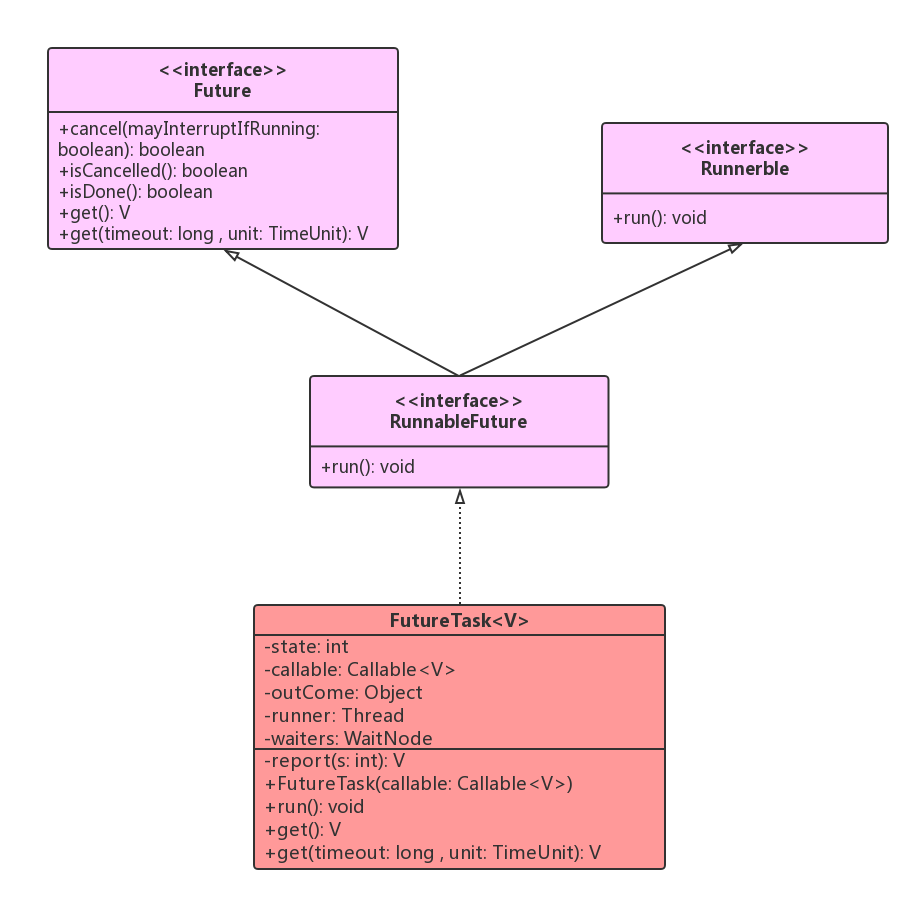
FutureTask可用于异步获取执行结果或取消执行任务的场景。通过传入Runnable或者Callable的任务给FutureTask,直接调用其run方法或者放入线程池执行,之后可以在外部通过FutureTask的get方法异步获取执行结果,因此,FutureTask非常适合用于耗时的计算,主线程可以在完成自己的任务后,再去获取结果。另外,FutureTask还可以确保即使调用了多次run方法,它都只会执行一次Runnable或者Callable任务,或者通过cancel取消FutureTask的执行等。 类图结构如下所示: 线程池使用 FutureTask 时候需要注意的一点事,FutureTask 使用不当可能会造成调用线程一直阻塞,如何避免? 线程池使用 FutureTask 的时候如果拒绝策略设置为了DiscardPolicy和DiscardOldestPolicy并且在被拒绝的任务的 Future 对象上调用无参 get 方法那么调用线程会一直被阻塞。 下面先通过一个简单的例子来复现问题,代码如下: public class FutureTest { //(1)线程池单个线程,线程池队列元素个数为1 private final static ThreadPoolExecutor executorService = new ThreadPoolExecutor(1, 1, 1L, TimeUnit.MINUTES, new ArrayBlockingQueue<Runnable>(1),new ThreadPoolExecutor.DiscardPolicy()); public static void main(String[] args) throws Exception { //(2)添加任务one Future futureOne = executorService.submit(new Runnable() { @Override public void run() { System.out.println("start runable one"); try { Thread.sleep(5000); } catch (InterruptedException e) { e.printStackTrace(); } } }); //(3)添加任务two Future futureTwo = executorService.submit(new Runnable() { @Override public void run() { System.out.println("start runable two"); } }); //(4)添加任务three Future futureThree=null; try { futureThree = executorService.submit(new Runnable() { @Override public void run() { System.out.println("start runable three"); } }); } catch (Exception e) { System.out.println(e.getLocalizedMessage()); } System.out.println("task one " + futureOne.get());//(5)等待任务one执行完毕 System.out.println("task two " + futureTwo.get());//(6)等待任务two执行完毕 System.out.println("task three " + (futureThree==null?null:futureThree.get()));// (7)等待任务three执行完毕 executorService.shutdown();//(8)关闭线程池,阻塞直到所有任务执行完毕 } 运行结果如下: 代码 (1) 创建了一个单线程并且队列元素个数为 1 的线程池,并且拒绝策略设置为了DiscardPolicy 代码(2)向线程池提交了一个任务 one,那么这个任务会使用唯一的一个线程进行执行,任务在打印start runable one后会阻塞该线程 5s. 代码(3)向线程池提交了一个任务 two,这时候会把任务 two 放入到阻塞队列 代码(4)向线程池提交任务 three,由于队列已经满了则会触发拒绝策略丢弃任务 three, 从执行结果看在任务 one 阻塞的 5s 内,主线程执行到了代码 (5) 等待任务 one 执行完毕,当任务 one 执行完毕后代码(5)返回,主线程打印出 task one null。任务 one 执行完成后线程池的唯一线程会去队列里面取出任务 two 并执行所以输出 start runable two 然后代码(6)会返回,这时候主线程输出 task two null,然后执行代码(7)等待任务 three 执行完毕,从执行结果看代码(7)会一直阻塞不会返回,至此问题产生,如果把拒绝策略修改为 DiscardOldestPolicy 也会存在有一个任务的 get 方法一直阻塞只是现在是任务 two 被阻塞。但是如果拒绝策略设置为默认的 AbortPolicy 则会正常返回,并且会输出如下结果: 要分析这个问题需要看下线程池的 submit 方法里面做了什么,submit 方法源码如下: public Future<?> submit(Runnable task) { ... //(1)装饰Runnable为Future对象 RunnableFuture<Void> ftask = newTaskFor(task, null); execute(ftask); //(6)返回future对象 return ftask; } protected <T> RunnableFuture<T> newTaskFor(Runnable runnable, T value) { return new FutureTask<T>(runnable, value); } public void execute(Runnable command) { ... //(2) 如果线程个数消息核心线程数则新增处理线程处理 int c = ctl.get(); if (workerCountOf(c) < corePoolSize) { if (addWorker(command, true)) return; c = ctl.get(); } //(3)如果当前线程个数已经达到核心线程数则任务放入队列 if (isRunning(c) && workQueue.offer(command)) { int recheck = ctl.get(); if (! isRunning(recheck) && remove(command)) reject(command); else if (workerCountOf(recheck) == 0) addWorker(null, false); } //(4)尝试新增处理线程进行处理 else if (!addWorker(command, false)) reject(command);//(5)新增失败则调用拒绝策略 } 代码(1)装饰 Runnable 为 FutureTask 对象,然后调用线程池的 execute 方法。 代码 (2) 如果线程个数消息核心线程数则新增处理线程处理 代码(3)如果当前线程个数已经达到核心线程数则任务放入队列 代码(4)尝试新增处理线程进行处理,失败则进行代码(5),否者直接使用新线程处理 代码(5)执行具体拒绝策略,从这里也可以看出拒绝策略执行是使用的业务线程。 所以要分析上面例子中问题所在只需要看步骤(5)对被拒绝任务的影响,这里先看下拒绝策略 DiscardPolicy 的源码,如下: public static class DiscardPolicy implements RejectedExecutionHandler { public DiscardPolicy() { } public void rejectedExecution(Runnable r, ThreadPoolExecutor e) { } } 可知拒绝策略 rejectedExecution 方法里面什么都没做,所以代码(4)调用 submit 后会返回一个 future 对象,这里有必要在重新说 future 是有状态的,FutureTask 内部有一个state用来展示任务的状态,并且是volatile修饰的,future 的状态枚举值如下: /** Possible state transitions: * NEW -> COMPLETING -> NORMAL 正常的状态转移 * NEW -> COMPLETING -> EXCEPTIONAL 异常 * NEW -> CANCELLED 取消 * NEW -> INTERRUPTING -> INTERRUPTED 中断 */ private volatile int state; private static final int NEW = 0; private static final int COMPLETING = 1; private static final int NORMAL = 2; private static final int EXCEPTIONAL = 3; private static final int CANCELLED = 4; private static final int INTERRUPTING = 5; private static final int INTERRUPTED = 6; 在代码(1)的时候使用 newTaskFor 方法转换 Runnable 任务为 FutureTask,而 FutureTask 的构造函数里面设置的状态就是 New。FutureTask的构造函数源码如下: public FutureTask(Runnable runnable, V result) { this.callable = Executors.callable(runnable, result); this.state = NEW; // ensure visibility of callable } 把FutureTask提交到线程池或者线程执行start时候会调用run方法,源码如下: public void run() { //如果当前不是new状态,或者当前cas设置当前线程失败则返回,只有一个线程可以成功。 if (state != NEW || !UNSAFE.compareAndSwapObject(this, runnerOffset, null, Thread.currentThread())) return; try { //当前状态为new 则调用任务的call方法执行任务 Callable<V> c = callable; if (c != null && state == NEW) { V result; boolean ran; try { result = c.call(); ran = true; } catch (Throwable ex) { result = null; ran = false; setException(ex);//完成NEW -> COMPLETING -> EXCEPTIONAL 状态转移 } //执行任务成功则保存结果更新状态,unpark所有等待线程。 if (ran) set(result); } } finally { // runner must be non-null until state is settled to // prevent concurrent calls to run() runner = null; // state must be re-read after nulling runner to prevent // leaked interrupts int s = state; if (s >= INTERRUPTING) handlePossibleCancellationInterrupt(s); } } protected void set(V v) { //状态从new->COMPLETING if (UNSAFE.compareAndSwapInt(this, stateOffset, NEW, COMPLETING)) { outcome = v; //状态从COMPLETING-》NORMAL UNSAFE.putOrderedInt(this, stateOffset, NORMAL); // final state //unpark所有等待线程。 finishCompletion(); } } 所以使用 DiscardPolicy 策略提交任务后返回了一个状态值为NEW的future对象。那么我们下面就要看下当future的无参get()方法的时候,future变为什么状态才会返回,这时候就要看一下FutureTask的get方法的源码,源码如下: public V get() throws InterruptedException, ExecutionException { int s = state; //当状态值<=COMPLETING时候需要等待,否者调用report返回 if (s <= COMPLETING) s = awaitDone(false, 0L); return report(s); } private int awaitDone(boolean timed, long nanos) throws InterruptedException { final long deadline = timed ? System.nanoTime() + nanos : 0L; WaitNode q = null; boolean queued = false; for (;;) { //如果被中断,则抛异常 if (Thread.interrupted()) { removeWaiter(q); throw new InterruptedException(); } //组建单列表 int s = state; if (s > COMPLETING) { if (q != null) q.thread = null; return s; } else if (s == COMPLETING) // cannot time out yet Thread.yield(); else if (q == null) q = new WaitNode(); else if (!queued) queued = UNSAFE.compareAndSwapObject(this, waitersOffset, q.next = waiters, q); else if (timed) { nanos = deadline - System.nanoTime(); //超时则返回 if (nanos <= 0L) { removeWaiter(q); return state; } //否者设置park超时时间 LockSupport.parkNanos(this, nanos); } else //直接挂起当前线程 LockSupport.park(this); } } private V report(int s) throws ExecutionException { Object x = outcome; //状态值为NORMAL正常返回 if (s == NORMAL) return (V)x; //状态值大于等于CANCELLED则抛异常 if (s >= CANCELLED) throw new CancellationException(); throw new ExecutionException((Throwable)x); } 也就是说当 future 的状态 > COMPLETING 时候调用 get 方法才会返回,而明显 DiscardPolicy 策略在拒绝元素的时候并没有设置该 future 的状态,后面也没有其他机会可以设置该 future 的状态,所以 future 的状态一直是 NEW,所以一直不会返回,同理 DiscardOldestPolicy 策略也是这样的问题,最老的任务被淘汰时候没有设置被淘汰任务对于 future 的状态。、 在submit任务后还可以调用futuretask的cancel来取消任务: public boolean cancel(boolean mayInterruptIfRunning) { //只有任务是new的才能取消 if (state != NEW) return false; //运行时允许中断 if (mayInterruptIfRunning) { //完成new->INTERRUPTING if (!UNSAFE.compareAndSwapInt(this, stateOffset, NEW, INTERRUPTING)) return false; Thread t = runner; if (t != null) t.interrupt(); //完成INTERRUPTING->INTERRUPTED UNSAFE.putOrderedInt(this, stateOffset, INTERRUPTED); // final state } //不允许中断则直接new->CANCELLED else if (!UNSAFE.compareAndSwapInt(this, stateOffset, NEW, CANCELLED)) return false; finishCompletion(); return true; } 那么默认的 AbortPolicy 策略为啥没问题呢? 也就是说当 future 的状态 > COMPLETING 时候调用 get 方法才会返回,而明显 DiscardPolicy 策略在拒绝元素的时候并没有设置该 future 的状态,后面也没有其他机会可以设置该 future 的状态,所以 future 的状态一直是 NEW,所以一直不会返回,同理 DiscardOldestPolicy 策略也是这样的问题,最老的任务被淘汰时候没有设置被淘汰任务对于 future 的状态。 所以当使用 Future 的时候,尽量使用带超时时间的 get 方法,这样即使使用了 DiscardPolicy 拒绝策略也不至于一直等待,等待超时时间到了会自动返回的,如果非要使用不带参数的 get 方法则可以重写 DiscardPolicy 的拒绝策略在执行策略时候设置该 Future 的状态大于 COMPLETING 即可,但是查看 FutureTask 提供的方法发现只有 cancel 方法是 public 的并且可以设置 FutureTask 的状态大于 COMPLETING,重写拒绝策略具体代码可以如下: /** * Created by cong on 2018/7/13. */ public class MyRejectedExecutionHandler implements RejectedExecutionHandler { public void rejectedExecution(Runnable runnable, ThreadPoolExecutor threadPoolExecutor) { if (!threadPoolExecutor.isShutdown()) { if(null != runnable && runnable instanceof FutureTask){ ((FutureTask) runnable).cancel(true); } } } } 使用这个策略时候由于从 report 方法知道在 cancel 的任务上调用 get() 方法会抛出异常所以代码(7)需要使用 try-catch 捕获异常代码(7)修改为如下: package com.hjc; import java.util.concurrent.*; /** * Created by cong on 2018/7/13. */ public class FutureTest { //(1)线程池单个线程,线程池队列元素个数为1 private final static ThreadPoolExecutor executorService = new ThreadPoolExecutor(1, 1, 1L, TimeUnit.MINUTES, new ArrayBlockingQueue<Runnable>(1), new MyRejectedExecutionHandler()); public static void main(String[] args) throws Exception { //(2)添加任务one Future futureOne = executorService.submit(new Runnable() { public void run() { System.out.println("start runable one"); try { Thread.sleep(5000); } catch (InterruptedException e) { e.printStackTrace(); } } }); //(3)添加任务two Future futureTwo = executorService.submit(new Runnable() { public void run() { System.out.println("start runable two"); } }); //(4)添加任务three Future futureThree = null; try { futureThree = executorService.submit(new Runnable() { public void run() { System.out.println("start runable three"); } }); } catch (Exception e) { System.out.println(e.getLocalizedMessage()); } System.out.println("task one " + futureOne.get());//(5)等待任务one执行完毕 System.out.println("task two " + futureTwo.get());//(6)等待任务two执行完毕 try{ System.out.println("task three " + (futureThree==null?null:futureThree.get()));// (7)等待任务three }catch(Exception e){ System.out.println(e.getLocalizedMessage()); } executorService.shutdown();//(8)关闭线程池,阻塞直到所有任务执行完毕 } } 运行结果如下: 当然这相比正常情况下多了一个异常捕获,其实最好的情况是重写拒绝策略时候设置 FutureTask 的状态为 NORMAL,但是这需要重写 FutureTask 方法了,因为 FutureTask 并没有提供接口进行设置。

优秀的个人博客,低调大师

Java并发编程笔记之Timer源码分析

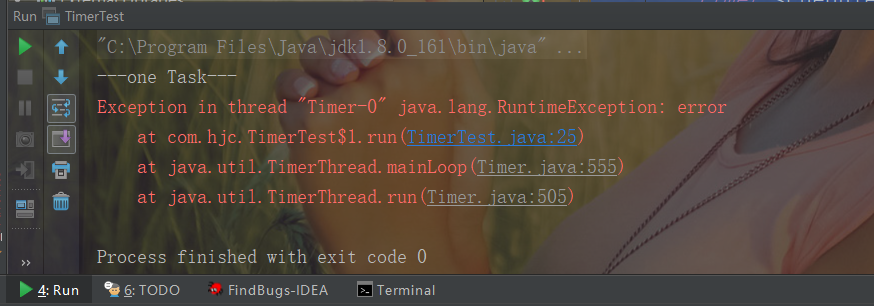
timer在JDK里面,是很早的一个API了。具有延时的,并具有周期性的任务,在newScheduledThreadPool出来之前我们一般会用Timer和TimerTask来做,但是Timer存在一些缺陷,为什么这么说呢? Timer只创建唯一的线程来执行所有Timer任务。如果一个timer任务的执行很耗时,会导致其他TimerTask的时效准确性出问题。例如一个TimerTask每10秒执行一次,而另外一个TimerTask每40ms执行一次,重复出现的任务会在后来的任务完成后快速连续的被调用4次,要么完全“丢失”4次调用。Timer的另外一个问题在于,如果TimerTask抛出未检查的异常会终止timer线程。这种情况下,Timer也不会重新回复线程的执行了;它错误的认为整个Timer都被取消了。此时已经被安排但尚未执行的TimerTask永远不会再执行了,新的任务也不能被调度了。 这里做了一个小的 demo 来复现问题,代码如下: package com.hjc; import java.util.Timer; import java.util.TimerTask; /** * Created by cong on 2018/7/12. */ public class TimerTest { //创建定时器对象 static Timer timer = new Timer(); public static void main(String[] args) { //添加任务1,延迟500ms执行 timer.schedule(new TimerTask() { @Override public void run() { System.out.println("---one Task---"); try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } throw new RuntimeException("error "); } }, 500); //添加任务2,延迟1000ms执行 timer.schedule(new TimerTask() { @Override public void run() { for (;;) { System.out.println("---two Task---"); try { Thread.sleep(1000); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } } } }, 1000); } } 如上代码先添加了一个任务在 500ms 后执行,然后添加了第二个任务在 1s 后执行,我们期望的是当第一个任务输出 ---one Task--- 后等待 1s 后第二个任务会输出 ---two Task---, 但是执行完毕代码后输出结果如下所示: 例子2, public class Shedule { private static long start; public static void main(String[] args) { TimerTask task = new TimerTask() { public void run() { System.out.println(System.currentTimeMillis()-start); try{ Thread.sleep(3000); }catch (InterruptedException e){ e.printStackTrace(); } } }; TimerTask task1 = new TimerTask() { @Override public void run() { System.out.println(System.currentTimeMillis()-start); } }; Timer timer = new Timer(); start = System.currentTimeMillis(); //启动一个调度任务,1S钟后执行 timer.schedule(task,1000); //启动一个调度任务,3S钟后执行 timer.schedule(task1,3000); } } 上面程序我们预想是第一个任务执行后,第二个任务3S后执行的,即输出一个1000,一个3000. 实际运行结果如下: 实际运行结果并不如我们所愿。世界结果,是过了4S后才输出第二个任务,即4001约等于4秒。那部分时间时间到哪里去了呢?那个时间是被我们第一个任务的sleep所占用了。 现在我们在第一个任务中去掉Thread.sleep();这一行代码,运行是否正确了呢?运行结果如下: 可以看到确实是第一个任务过了1S后执行,第二个任务在第一个任务执行完后过3S执行了。 这就说明了Timer只创建唯一的线程来执行所有Timer任务。如果一个timer任务的执行很耗时,会导致其他TimerTask的时效准确性出问题。 Timer 实现原理分析 下面简单介绍下 Timer 的原理,如下图是 Timer 的原理模型介绍: 1.其中 TaskQueue 是一个平衡二叉树堆实现的优先级队列,每个 Timer 对象内部有唯一一个 TaskQueue 队列。用户线程调用 timer 的 schedule 方法就是把 TimerTask 任务添加到 TaskQueue 队列,在调用 schedule 的方法时候 long delay 参数用来说明该任务延迟多少时间执行。 2.TimerThread 是具体执行任务的线程,它从 TaskQueue 队列里面获取优先级最小的任务进行执行,需要注意的是只有执行完了当前的任务才会从队列里面获取下一个任务而不管队列里面是否有已经到了设置的 delay 时间,一个 Timer 只有一个 TimerThread 线程,所以可知 Timer 的内部实现是一个多生产者单消费者模型。 从实现模型可以知道要探究上面的问题只需看 TimerThread 的实现就可以了,TimerThread 的 run 方法主要逻辑源码如下: public void run() { try { mainLoop(); } finally { // 有人杀死了这个线程,表现得好像Timer已取消 synchronized(queue) { newTasksMayBeScheduled = false; queue.clear(); // 消除过时的引用 } } } private void mainLoop() { while (true) { try { TimerTask task; boolean taskFired; //从队列里面获取任务时候要加锁 synchronized(queue) { ...... } if (taskFired) task.run();//执行任务 } catch(InterruptedException e) { } } } 可知当任务执行过程中抛出了除 InterruptedException 之外的异常后,唯一的消费线程就会因为抛出异常而终止,那么队列里面的其他待执行的任务就会被清除。所以 TimerTask 的 run 方法内最好使用 try-catch 结构 catch 主可能的异常,不要把异常抛出到 run 方法外。 其实要实现类似 Timer 的功能使用 ScheduledThreadPoolExecutor 的 schedule 是比较好的选择。ScheduledThreadPoolExecutor 中的一个任务抛出了异常,其他任务不受影响的。 ScheduledThreadPoolExecutor 例子如下: /** * Created by cong on 2018/7/12. */ public class ScheduledThreadPoolExecutorTest { static ScheduledThreadPoolExecutor scheduledThreadPoolExecutor = new ScheduledThreadPoolExecutor(1); public static void main(String[] args) { scheduledThreadPoolExecutor.schedule(new Runnable() { public void run() { System.out.println("---one Task---"); try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } throw new RuntimeException("error "); } }, 500, TimeUnit.MICROSECONDS); scheduledThreadPoolExecutor.schedule(new Runnable() { public void run() { for (int i =0;i<5;++i) { System.out.println("---two Task---"); try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } } } }, 1000, TimeUnit.MICROSECONDS); scheduledThreadPoolExecutor.shutdown(); } } 运行结果如下: 之所以 ScheduledThreadPoolExecutor 的其他任务不受抛出异常的任务的影响是因为 ScheduledThreadPoolExecutor 中的 ScheduledFutureTask 任务中 catch 掉了异常,但是在线程池任务的 run 方法内使用 catch 捕获异常并打印日志是最佳实践。

优秀的个人博客,低调大师

Java并发编程笔记之SimpleDateFormat源码分析

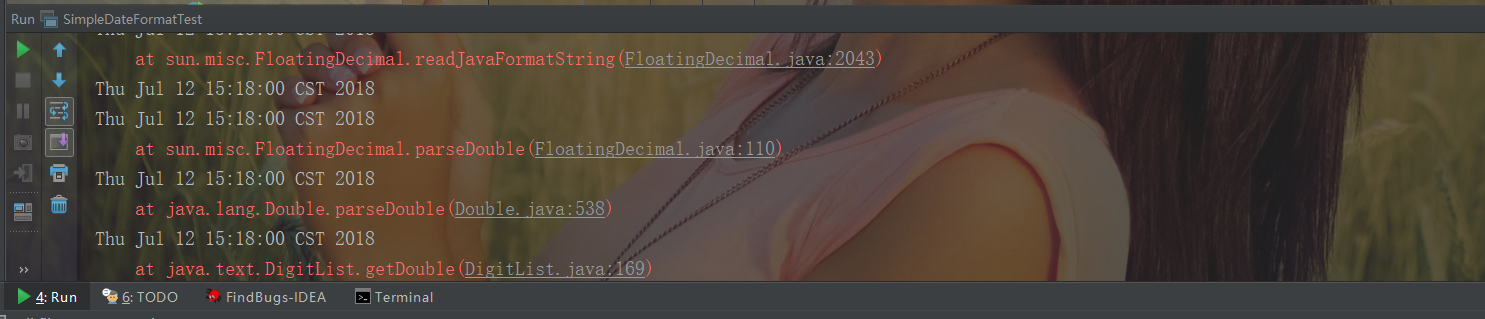
SimpleDateFormat 是 Java 提供的一个格式化和解析日期的工具类,日常开发中应该经常会用到,但是由于它是线程不安全的,多线程公用一个 SimpleDateFormat 实例对日期进行解析或者格式化会导致程序出错,本节就讨论下它为何是线程不安全的,以及如何避免。 为了复现上面所说的不安全,我们要用一个例子来突出这个不安全,例子如下: package com.hjc; import java.text.ParseException; import java.text.SimpleDateFormat; /** * Created by cong on 2018/7/12. */ public class SimpleDateFormatTest { //(1)创建单例实例 static SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); public static void main(String[] args) { //(2)创建多个线程,并启动 for (int i = 0; i <10 ; ++i) { Thread thread = new Thread(new Runnable() { public void run() { try {//(3)使用单例日期实例解析文本 System.out.println(sdf.parse("2018-07-12 15:18:00")); } catch (ParseException e) { e.printStackTrace(); } } }); thread.start();//(4)启动线程 } } } 运行结果如下: 代码(1)创建了 SimpleDateFormat 的一个实例,代码(2)创建 10 个线程,每个线程都公用同一个 sdf 对象对文本日期进行解析,多运行几次就会抛出 java.lang.NumberFormatException 异常,加大线程的个数有利于该问题复现。 为什么会出现这样的问题呢? 那么接下来我们就要进入到SimpleDateFormat 源码一探究竟,为了便于分析首先查看 SimpleDateFormat 的类图结构,类图如下所示: 可知每个 SimpleDateFormat 实例里面有一个 Calendar 对象,到后面就会知道SimpleDateFormat 之所以是线程不安全的,其实就是因为 Calendar 是线程不安全的,后者之所以是线程不安全的是因为其中存放日期数据的变量都是线程不安全的,比如里面的 fields,time 等。 接下来我们要看看parse方法到底干了些什么事,源码如下: public Date parse(String text, ParsePosition pos) { //(1)解析日期字符串放入CalendarBuilder的实例calb中,源码很长,省略一部分,自己去看 ..... Date parsedDate; try {//(2)使用calb中解析好的日期数据设置calendar parsedDate = calb.establish(calendar).getTime(); ... } catch (IllegalArgumentException e) { ... return null; } return parsedDate; } Calendar establish(Calendar cal) { ... //(3)重置日期对象cal的属性值 cal.clear(); //(4) 使用calb中中属性设置cal ... //(5)返回设置好的cal对象 return cal; } 代码(1)主要的作用是解析字符串日期并把解析好的数据放入了 CalendarBuilder 的实例 calb 中,CalendarBuilder 是一个建造者模式,用来存放后面需要的数据。 代码(3)重置 Calendar 对象里面的属性值,源码如下: public final void clear(){ for (int i = 0; i < fields.length; ) { stamp[i] = fields[i] = 0; // UNSET == 0 isSet[i++] = false; } areAllFieldsSet = areFieldsSet = false; isTimeSet = false; } 代码(4)使用 calb 中解析好的日期数据设置 cal 对象 代码(5) 返回设置好的 cal 对象 从上面步骤可知代码(3)(4)(5)操作不是原子性操作,当多个线程调用 parse 方法时候比如线程 A 执行了代码(3)(4)也就是设置好了 cal 对象,在执行代码(5)前线程 B 执行了代码(3)清空了 cal 对象,由于多个线程使用的是一个 cal 对象,所以线程 A 执行代码(5)返回的就可能是被线程 B 清空后的对象,当然也有可能线程 B 执行了代码(4)被线程 B 修改后的 cal 对象。从而导致程序错误。 那么,让我们思考一个问题,如何解决SimpleDateFormat 的线程安全性问题呢? 1.第一种方式:每次使用时候 new 一个 SimpleDateFormat 的实例,这样可以保证每个实例使用自己的 Calendar 实例, 但是每次使用都需要 new 一个对象,并且使用后由于没有其它引用,就会需要被回收,开销会很大。 2.第二种方式:究其原因是因为多线程下代码(3)(4)(5)三个步骤不是一个原子性操作,那么容易想到的是对其进行同步,让(3)(4)(5)成为原子操作,可以使用 synchronized 进行同步,例子改造如下所示: /** * Created by cong on 2018/7/12. */ public class SimpleDateFormatTest1 { //(1)创建单例实例 static SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); public static void main(String[] args) { //(2)创建多个线程,并启动 for (int i = 0; i <10 ; ++i) { Thread thread = new Thread(new Runnable() { public void run() { try {// (3)使用单例日期实例解析文本 synchronized (sdf) { System.out.println(sdf.parse("2018-07-12 15:18:00")); } } catch (ParseException e) { e.printStackTrace(); } } }); thread.start();//(4)启动线程 } } } 运行结果如下: 3.第三种方式:使用 ThreadLocal,这样每个线程只需要使用一个 SimpleDateFormat 实例相比第一种方式大大节省了对象的创建销毁开销,并且不需要对多个线程直接进行同步,使用 ThreadLocal 方式来保证线程安全,例子如下: /** * Created by cong on 2018/7/12. */ public class SimpleDateFormatTest2 { // (1)创建threadlocal实例 static ThreadLocal<DateFormat> safeSdf = new ThreadLocal<DateFormat>(){ @Override protected SimpleDateFormat initialValue(){ return new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); } }; public static void main(String[] args) { // (2)创建多个线程,并启动 for (int i = 0; i < 10; ++i) { Thread thread = new Thread(new Runnable() { public void run() { try {// (3)使用单例日期实例解析文本 System.out.println(safeSdf.get().parse("2018-07-12 15:18:00")); } catch (ParseException e) { e.printStackTrace(); }finally { //(4)使用完毕记得清除,避免内存泄露 safeSdf.remove(); } } }); thread.start();// (4)启动线程 } } } 运行结果如下: 代码(1)创建了一个线程安全的 SimpleDateFormat 实例,代码(3)在使用的时候首先使用 get() 方法获取当前线程下 SimpleDateFormat 的实例,在第一次调用 ThreadLocal 的 get()方法适合会触发其 initialValue 方法用来创建当前线程所需要的 SimpleDateFormat 对象。另外需要注意的是代码(4)使用完毕线程变量后要记得进行清理,以避免内存泄露。

优秀的个人博客,低调大师

Java并发编程-volatile关键字介绍

前言 要学习好Java的多线程,就一定得对volatile关键字的作用机制了熟于胸。最近博主看了大量关于volatile的相关博客,对其有了一点初步的理解和认识,下面通过自己的话叙述整理一遍。 有什么用? volatile主要对所修饰的变量提供两个功能 可见性 防止指令重排序 本篇博客主要对volatile可见性进行探讨,以后发表关于指令重排序的博文。 什么是可见性? 一图胜千言上图已经把JAVA内存模型(JMM)展示得很详细了,简单概括一下 每个Thread有一个属于自己的工作内存(可以理解为每个厨师有一个属于自己的铁锅) 所有Thread共用一个主内存(餐厅所有的厨师共用同一个冰箱) 每个Thread操作数据之前都会去主内存中获取数据(厨师炒菜之前都要去冰箱里拿食材) Thread:厨师 工作内存:铁锅 store&load:放熟食,取食材 主内存:冰箱 读者可思考以下情景:餐厅来了一位顾客点了一份红烧肉,此时有两位大厨(假设大厨之间互不通信),由于互不通信,所以两位大厨都打开冰箱取出食材开始炒菜。最后炒出了两份红烧肉,顾客只要一份。为什么会造成这种结果? 由于大厨之间没有可见性。 将此情景放在JAVA中即是:线程A从主内存中取了一个变量到工作内存中,操作完毕后没有及时放回主内存中,于是线程B去取这个变量已经过期了,取的是线程A操作之前的变量。 如何拥有可见性? 先介绍一下Java内存模型中定义的8种工作内存与主内存之间的原子操作 lock( 锁定 ):作用于主内存的变量,把一个变量标识为一条线程独占的状态。 unlock(解锁):作用于主内存的变量,把一个处于锁定的变量释放出来,释放变量才可以被其他线程锁定。 read(读取):作用于主内存的变量,把一个变量的值从主内存传输到线程的工作内存中,以便随后的load动作使用。 load(载入):作用于工作内存的变量,它把read操作从主内存中得到的变量值放入工作内存的变量副本中。 use(使用):作用于工作内存种的变量,它把工作内存中一个变量的值传递给执行引擎,每当虚拟机遇到一个需要使用到变量的值的字节码指令时将会执行这个操作。 assign(赋值):作用于工作内存中的变量,它把一个从执行引擎接收到的值赋给工作内存的变量,每当虚拟机遇到一个给变量赋值的字节码指令时执行这个操作。 store(存储):作用于工作内存的变量,它把工作内存中一个变量的值传送到主内存中,以便随后的write操作使用 write(写入):作用于主内存的变量,它把store操作从工作内存中得到的值放入主内存的变量中。 读取赋值一个普通变量的情况 当线程1对主内存对象发起read操作到write操作套流程的时间里,线程2随时都有可能对这个主内存对象发起第二套操作 有什么危害呢? 假设主内存中有一个 int a=0; 线程1和线程2分别执行一次,理想状态下最终a的值为2. a++; 线程1在执行了assign操作之后变量a的真实值已经从0变成了1,但是这个过程发生在工作内存中对其他线程不可见,若线程2此时对变量a的操作,读取到的值仍然为0,因为没有可见性,线程2的操作也仅仅是重复了线程1的操作,再次让a从0变成了1。并没有达到期望的a=2。 读取赋值一个volatile变量的情况 volatile变量对对象的操作更严格: use之前不能被read&load assign之后必须紧跟store&write 也就是说 read-load-use 和 assign-store-write成为了两个不可分割的原子操作 尽管这时候在use和assign之间依然有一段真空期,有可能变量会被其他线程读取,但是无论在哪一个时间点主内存的变量和任一工作内存的变量的值都是相等的。这个特性就导致了volatile变量不适合参与到依赖当前值的运算,如自增。那么依靠可见性的特点volatile可以用在哪些地方呢?《Java虚拟机》提到: 运算结果并不依赖变量的当前值(即结果对产生中间结果不依赖),或者能够确保只有单一的线程修改变量的值 通常volatile用做保存某个状态的boolean值。 部分参考自 volatile变量与普通变量的区别 <<深入理解Java虚拟机 高级特性与最佳实践>>

优秀的个人博客,低调大师

Java并发编程笔记之CyclicBarrier源码分析

JUC 中 回环屏障 CyclicBarrier 的使用与分析,它也可以实现像 CountDownLatch 一样让一组线程全部到达一个状态后再全部同时执行,但是 CyclicBarrier 可以被复用。那么 CyclicBarrier 内部的实现与 CountDownLatch 有何不同那? CounDownLatch在解决多个线程同步方面相对于调用线程的 join 已经提供了不少改进,但是CountDownLatch的计数器是一次性的,也就是等到计数器变为0后,再调用CountDownLatch的await ()和countDown()方法都会立刻返回,这就起不到线程同步的效果了。CyclicBarrier类的功能不限于CountDownLatch所提供的功能,从字面意思理解CyclicBarrier是回环屏障的意思,它可以实现让一组线程全部达到一个状态后再全部同时执行。这里之所以叫做回环是因为当所有等待线程执行完毕之后,重置CyclicBarrier的状态后可以被重用。下图演示了这一过程。 一.CyclicBarrier的实现原理 为了能一览CyclicBarrier的架构设计,下面先看下CyclicBarrier的类图,如下图: 如上面类图,可以知道CyclicBarrier 内部并不是直接使用AQS实现,而是使用了独占锁ReentrantLock来实现的同步;parties用来记录线程个数,用来表示需要多少线程先调用await后,所有线程才会冲破屏障继续往下运行;而 count 一开始等一parties,每当线程调用await方法后就递减 1 ,当为 0 的时候就表示所有线程都到了屏障点,另外你可能会疑惑为何维护parties 和 count 这两个变量,只有count 不就行了吗?别忘了CyclicBarries是可以被复用的,使用两个变量原因是用parties始终来记录总的线程个数,当count计数器变为 0 后,会使用parties 赋值给count,已达到复用的作用。这两个变量是在构造CyclicBarries对象的时候传递的,源码如下: 这里还有一个变量barrierConmmand也通过构造函数传递而来,这是一个任务,这个任务的执行时机是当所有线程都达到屏障点后。另外CyclicBarrier内部使用独占锁Lock来保证同时只有一个线程调用await方法时候才可以返回,使用lock首先保证了更新计数器count 的原子性,另外使用lock的条件变量 trip 支持了 线程间使用 notify,await 操作进行同步。 最后变量generation内部就一个变量broken用来记录当前屏障是否被打破,另外注意这里broken并没有被声明为volatile ,这是因为锁内使用变量不需要。源码如下: private static class Generation { boolean broken = false; } 接下来重点看一下CyclicBarrier的几个重要的函数,如下: 1.int await() 当前线程调用 CyclicBarrier 的该方法时候,当前线程会被阻塞,知道满足下面条件之一才会返回:(1)parties 个线程都调用了 await()方法,也就是线程都到了屏障点。(2)其他线程调用了当前线程的interrupt()方法中断了当前线程,则当前线程会抛出InterruptedException 异常返回。(3)当前屏障点关联的Generation对象的broken标志被设置为true的时候,会抛出BrokenBarrierException 异常。源码如下: public int await() throws InterruptedException, BrokenBarrierException { try { return dowait(false, 0L); } catch (TimeoutException toe) { throw new Error(toe); // cannot happen } } 正如上面代码可以知道内部调用了dowait 方法,第一个参数false说明不设置超时时间,这时候第二个参数没有意义。 2.boolean await(long timeout, TimeUnit unit) 当前线程调用 CyclicBarrier 的该方法时候当前线程会被阻塞,直到满足下面条件之一才会返回: (1) parties 个线程都调用了 await() 函数,也就是线程都到了屏障点,这时候返回 true。 (2) 当设置的超时时间到了后返回 false (3) 其它线程调用了当前线程的 interrupt()方法中断了当前线程,则当前线程会抛出 InterruptedException 异常返回。 (4) 当前屏障点关联的 Generation 对象的 broken 标志被设置为 true 时候,会抛出 BrokenBarrierException 异常。源码如下: public int await(long timeout, TimeUnit unit) throws InterruptedException, BrokenBarrierException, TimeoutException { return dowait(true, unit.toNanos(timeout)); } 正如上面代码可以知道内部调用了dowait 方法,第一个参数true说明设置超时时间,这时候第二个参数是超时时间。 3.int dowait(boolean timed, long nanos) 该方法是实现 CyclicBarrier 的核心功能,源码如下: private int dowait(boolean timed, long nanos) throws InterruptedException, BrokenBarrierException, TimeoutException { final ReentrantLock lock = this.lock; lock.lock(); try { ... //(1)如果index==0说明所有线程都到到了屏障点,则执行初始化时候传递的任务 int index = --count; if (index == 0) { // tripped boolean ranAction = false; try { //(2)执行任务 if (command != null) command.run(); ranAction = true; //(3)激活其它调用await而被阻塞的线程,并重置CyclicBarrier nextGeneration(); //返回 return 0; } finally { if (!ranAction) breakBarrier(); } } // (4)如果index!=0 for (;;) { try { //(5)没有设置超时时间, if (!timed) trip.await(); //(6)设置了超时时间 else if (nanos > 0L) nanos = trip.awaitNanos(nanos); } catch (InterruptedException ie) { ... } ... } } finally { lock.unlock(); } } private void nextGeneration() { //(7)唤醒条件队列里面阻塞线程 trip.signalAll(); //(8) 重置CyclicBarrier count = parties; generation = new Generation(); } 上面代码是dowait方法的主干代码,当一个线程调用了dowait方法后首先会获取独占锁lock,如果创建CyclicBarrier的时候传递的参数为 10 ,那么后面 9 个调用线程会被阻塞;然后当前获取线程对计数器count进行递减操作,递减后的count = index = 9 ,因为 index != 0 ,所以当前线程会执行代码(4)。如果是无参数的当前线程调用的是无参数的await()方法,则这里 timed = false,所以当前线程会被放入条件变量trip的阻塞队列,当前线程会被挂起并释放获取的Lock锁;如果调用的有参数的await 方法 则timed = true,则当前线程也会被放入条件变量阻塞队列并释放锁的资源,但是不同的是当前线程会在指定时间超时后自动激活。 当第一个获取锁的线程由于被阻塞释放锁后,被阻塞的 9 个线程中有一个会竞争到lock锁,然后执行第一个线程同样的操作,直到最后一个线程获取到lock的时候,已经有 9 个线程被放入了Lock 的条件队列里面,最后一个线程 count 递减后,count = index 等于 0 ,所以执行代码(2),如果创建CyclicBarrier的时候传递了任务,则在其他线程被唤醒前先执行任务,任务执行完毕后再执行代码(3),唤醒其他 9 个线程,并重置CyclicBarrier,然后这 10个线程就可以继续向下执行了。 到目前位置理解了CyclicBarrier的原理后,接下来用几个例子来加深对CyclicBarrier的理解,下面例子我们要实现的是使用两个线程去执行一个被分解的任务 A,当两个线程把自己的任务都执行完毕后在对它们的结果进行汇总处理。例子如下: package com.hjc; import java.util.concurrent.CyclicBarrier; import java.util.concurrent.ExecutorService; import java.util.concurrent.Executors; /** * Created by cong on 2018/7/7. */ public class CyclicBarrierTest1 { // 创建一个CyclicBarrier实例,添加一个所有子线程全部到达屏障后执行的一个任务 private static volatile CyclicBarrier cyclicBarrier = new CyclicBarrier(2, new Runnable() { public void run() { System.out.println(Thread.currentThread() + " task1 merge result"); } }); public static void main(String[] args) throws InterruptedException { //创建一个线程个数固定为2的线程池 ExecutorService executorService = Executors.newFixedThreadPool(2); // 加入线程A到线程池 executorService.submit(new Runnable() { public void run() { try { System.out.println(Thread.currentThread() + " task1-1"); System.out.println(Thread.currentThread() + " enter in barrier"); cyclicBarrier.await(); System.out.println(Thread.currentThread() + " enter out barrier"); } catch (Exception e) { e.printStackTrace(); } } }); // 加入线程B到线程池 executorService.submit(new Runnable() { public void run() { try { System.out.println(Thread.currentThread() + " task1-2"); System.out.println(Thread.currentThread() + " enter in barrier"); cyclicBarrier.await(); System.out.println(Thread.currentThread() + " enter out barrier"); } catch (Exception e) { e.printStackTrace(); } } }); // 关闭线程池 executorService.shutdown(); } } 运行结果如下: 如上代码创建了一个 CyclicBarrier 对象,第一个参数为计数器初始值,第二个参数 Runable 是指当计数器为 0 时候需要执行的任务。main 函数里面首先创建了固定大小为 2 的线程池,然后添加两个子任务到线程池,每个子任务在执行完自己的逻辑后会调用 await 方法。 一开始计数器为 2,当第一个线程调用 await 方法时候,计数器会递减为 1,由于计数器不为 0,所以当前线程就到了屏障点会被阻塞,然后第二个线程调用 await 时候,会进入屏障,计数器也会递减现在计数器为 0,就会去执行在 CyclicBarrier 构造时候的任务,执行完毕后就会退出屏障点,并且会唤醒被阻塞的第一个线程,这时候第一个线程也会退出屏障点继续向下运行。 上面的例子说明了多个线程之间是相互等待的,假如计数器为 N,那么调用 await 方法的前面 N-1 的线程都会因为到达屏障点被阻塞,当第 N 个线程调用 await 后,计数器为 0 了,这时候第 N 个线程才会发出通知唤醒前面的 N-1 个线程。也就是全部线程达到屏障点时候才能一块继续向下执行,对与这个例子来说使用 CountDownLatch 也可以达到类似输出结果。 下面在放个例子来说明 CyclicBarrier 的可复用性。 假设一个任务由阶段 1、阶段 2、阶段 3 组成,每个线程要串行的执行阶段 1 和 2 和 3,多个线程执行该任务时候,必须要保证所有线程的阶段 1 全部完成后才能进行阶段 2 执行,所有线程的阶段 2 全部完成后才能进行阶段 3 执行,下面使用 CyclicBarrier 来完成这个需求。例子如下: package com.hjc; import java.util.concurrent.CyclicBarrier; import java.util.concurrent.ExecutorService; import java.util.concurrent.Executors; /** * Created by cong on 2018/7/7. */ public class CyclicBarrierTest2 { // 创建一个CyclicBarrier实例 private static volatile CyclicBarrier cyclicBarrier = new CyclicBarrier(2); public static void main(String[] args) throws InterruptedException { ExecutorService executorService = Executors.newFixedThreadPool(2); // 加入线程A到线程池 executorService.submit(new Runnable() { public void run() { try { System.out.println(Thread.currentThread() + " step1"); cyclicBarrier.await(); System.out.println(Thread.currentThread() + " step2"); cyclicBarrier.await(); System.out.println(Thread.currentThread() + " step3"); } catch (Exception e) { // TODO Auto-generated catch block e.printStackTrace(); } } }); // 加入线程B到线程池 executorService.submit(new Runnable() { public void run() { try { System.out.println(Thread.currentThread() + " step1"); cyclicBarrier.await(); System.out.println(Thread.currentThread() + " step2"); cyclicBarrier.await(); System.out.println(Thread.currentThread() + " step3"); } catch (Exception e) { // TODO Auto-generated catch block e.printStackTrace(); } } }); //关闭线程池 executorService.shutdown(); } } 运行结果如下: 如上代码,在每个子线程执行完 step1 后都调用了 await 方法,所有线程都到达屏障点后才会一块往下执行,这就保证了所有线程完成了 step1 后才会开始执行 step2,然后在 step2 后面调用了 await 方法,这保证了所有线程的 step2 完成后,线程才能开始 step3 的执行,这个功能使用单个 CountDownLatch 是无法完成的。

优秀的个人博客,低调大师

Java并发编程笔记之LinkedBlockingQueue源码探究

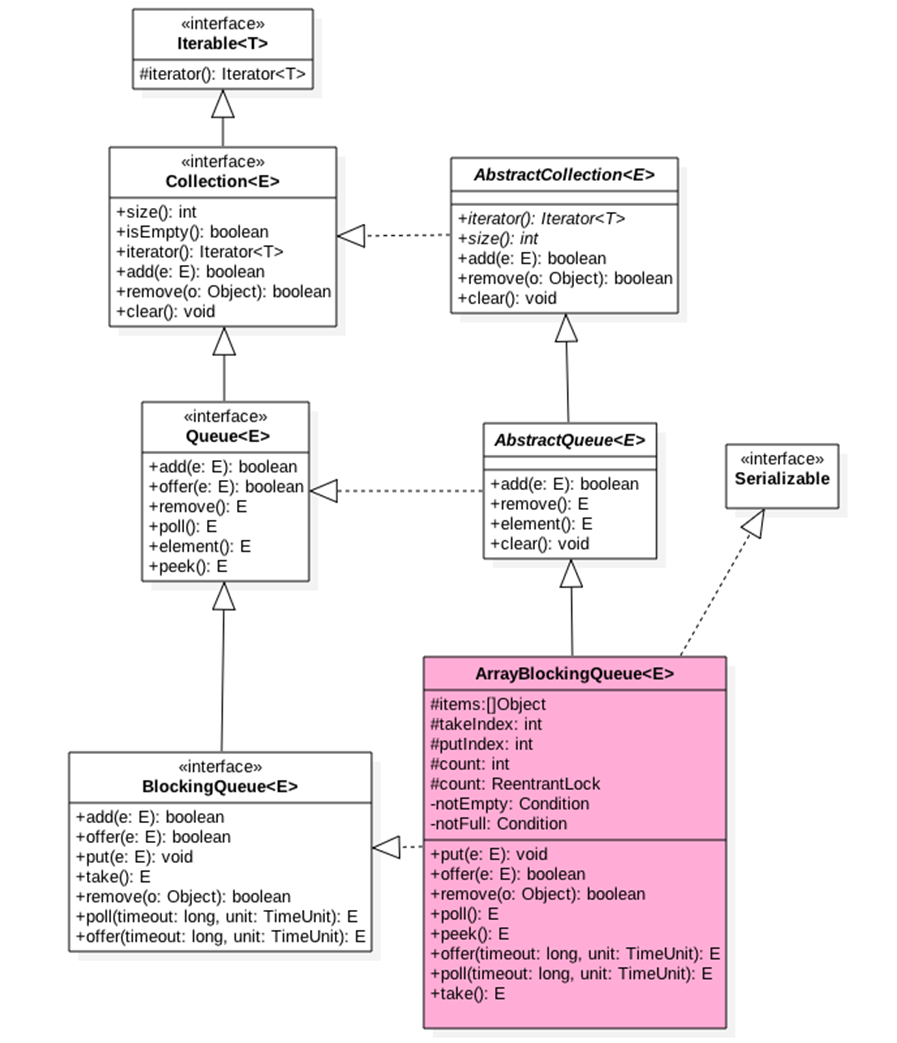
LinkedBlockingQueue的实现是使用独占锁实现的阻塞队列。首先看一下LinkedBlockingQueue的类图结构,如下图所示: 如类图所示:LinkedBlockingQueue是使用单向链表实现,有两个Node分别来存放首尾节点,并且里面有个初始值为0 的原子变量count,它用来记录队列元素个数。 另外里面有两个ReentrantLock的实例,分别用来控制元素入队和出队的原子性,其中takeLock用来控制同时只有一个线程可以从队列获取元素,其他线程必须等待, putLock控制同时只能有一个线程可以获取锁去添加元素,其他线程必须等待。另外notEmpty 和 notFull 是信号量,内部分别有一个条件队列用来存放进队和出队的时候被阻塞的线程, 说白了,这其实就是一个生产者 - 消费者模型。 我们首先看一下独占锁的源码,如下所示: /** 执行take, poll等操作时候需要获取该锁 */ private final ReentrantLock takeLock = new ReentrantLock(); /** 当队列为空时候执行出队操作(比如take)的线程会被放入这个条件队列进行等待 */ private final Condition notEmpty = takeLock.newCondition(); /** 执行put, offer等操作时候需要获取该锁*/ private final ReentrantLock putLock = new ReentrantLock(); /**当队列满时候执行进队操作(比如put)的线程会被放入这个条件队列进行等待 */ private final Condition notFull = putLock.newCondition(); /** 当前队列元素个数 */ private final AtomicInteger count = new AtomicInteger(0); 接着我们要进入LinkedBlockingQueue 无参构造函数,源码如下: public static final int MAX_VALUE = 0x7fffffff; public LinkedBlockingQueue() { this(Integer.MAX_VALUE); } public LinkedBlockingQueue(int capacity) { if (capacity <= 0) throw new IllegalArgumentException(); this.capacity = capacity; //初始化首尾节点,指向哨兵节点 last = head = new Node<E>(null); } 从源码中可以看到,默认队列的容量为0x7fffffff; 用户也可以自己指定容量,所以一定程度上 LinkedBlockingQueue 可以说是有界阻塞队列。 接下来我们主要看LinkedBlockingQueue 的几个主要方法的源码,如下: 1.offer操作,向队列尾部插入一个元素,如果队列有空闲容量则插入成功后返回true,如果队列已满则丢弃当前元素然后返回false,如果 e元素为null,则抛出空指针异常(NullPointerException),还有一点就是,该方法是非阻塞的。源码如下: public boolean offer(E e) { //(1)空元素抛空指针异常 if (e == null) throw new NullPointerException(); //(2) 如果当前队列满了则丢弃将要放入的元素,然后返回false final AtomicInteger count = this.count; if (count.get() == capacity) return false; //(3) 构造新节点,获取putLock独占锁 int c = -1; Node<E> node = new Node<E>(e); final ReentrantLock putLock = this.putLock; putLock.lock(); try { //(4)如果队列不满则进队列,并递增元素计数 if (count.get() < capacity) { enqueue(node); c = count.getAndIncrement(); //(5) if (c + 1 < capacity) notFull.signal(); } } finally { //(6)释放锁 putLock.unlock(); } //(7) if (c == 0) signalNotEmpty(); //(8) return c >= 0; } private void enqueue(Node<E> node) { last = last.next = node; } 代码(2)判断的是如果当前队列已满则丢弃当前元素并返回false。 代码(3)获取到putLock锁,当前线程获取到该锁后,则其他调用put 和 offer 的线程将会被阻塞(阻塞的线程被放到 putLock 锁的 AQS 阻塞队列)。 代码(4)这里又重新判断了一下当前队列是否满了,这是因为在执行代码(2)和获取到putLock锁期间,有可能其他线程通过put 或者 offer方法想队列里面添加了新的元素。重新判断队列确实不满则新元素入队,并递增计数器。 代码(5)判断的是如果新元素入队后还有空闲空间,则唤醒notFull的条件队列里面因为调用了notFull 的 await 操作(比如执行put方法而队列满了的时候)而被阻塞的一个线程,因为队列现在有空闲,所以这里可以提前唤醒一个入队线程。 代码(6)则释放获取的putLock锁,这里要注意锁的释放一定要在finally里面做,因为即使try块抛出异常了,finally也是会被执行到的。另外释放锁后其他因为调用put和offer而被阻塞的线程将会有一个获取到改锁。 代码(7)c == 0说明在执行代码(6)释放锁的时候队列里面至少有一个元素,队列里面有元素则执行signalNotEmpty,signalNotEmpty的源码如下: private void signalNotEmpty() { final ReentrantLock takeLock = this.takeLock; takeLock.lock(); try { notEmpty.signal(); } finally { takeLock.unlock(); } } 通过上面代码可以看到其作用是激活notEmpty 的条件队列中因为调用notEmpty的await方法(比如调用 take 方法并且队列为空的时候)而被阻塞的一个线程,这里也说明了调用条件变量的方法前,要首先获取对应的锁。 offer的总结:offer方法中通过使用putLock锁保证了在队尾新增元素的原子性和队列元素个数的比较和递增操作的原子性。 2.put操作,向队列尾部插入一个元素,如果队列有空闲则插入后直接返回true,如果队列已经满则阻塞当前线程知道队列有空闲插入成功后返回true,如果在阻塞的时候被其他线程设置了中断标志, 则被阻塞线程会抛出InterruptedException 异常而返回,另外如果 e 元素为 null 则抛出 NullPointerException 异常。源码如下: public void put(E e) throws InterruptedException { //(1)空元素抛空指针异常 if (e == null) throw new NullPointerException(); //(2) 构建新节点,并获取独占锁putLock int c = -1; Node<E> node = new Node<E>(e); final ReentrantLock putLock = this.putLock; final AtomicInteger count = this.count; putLock.lockInterruptibly(); try { //(3)如果队列满则等待 while (count.get() == capacity) { notFull.await(); } //(4)进队列并递增计数 enqueue(node); c = count.getAndIncrement(); //(5) if (c + 1 < capacity) notFull.signal(); } finally { //(6) putLock.unlock(); } //(7) if (c == 0) signalNotEmpty(); } 代码(2)中使用 putLock.lockInterruptibly() 获取独占锁,相比 offer 方法中这个获取独占锁方法意味着可以被中断,具体说是当前线程在获取锁的过程中,如果被其它线程设置了中断标志则当前线程会抛出 InterruptedException 异常, 所以put操作在获取 锁过程中是可被中断的。 代码(3)如果当前队列已经满,则notFull 的 await() 把当前线程放入 notFull 的条件队列,当前线程被阻塞挂起并释放获取到的 putLock 锁,由于putLock锁被释放了,所以现在其他线程就有机会获取到putLock锁了。 代码(3)判断队列是否为空为何使用 while 循环而不是 if 语句呢? 这是因为考虑到当前线程被虚假唤醒的问题,也就是其它线程没有调用 notFull 的 singal 方法时候,notFull.await() 在某种情况下会自动返回。 如果使用if语句简单判断一下,那么虚假唤醒后会执行代码(4),元素入队,并且递增计数器,而这时候队列已经是满了的,导致队列元素个数大于了队列设置的容量,导致程序出错。 而使用使用 while 循环假如 notFull.await() 被虚假唤醒了,那么循环在检查一下当前队列是否是满的,如果是则再次进行等待。 3.poll操作,从队列头部获取并移除一个元素,如果队列为空则返回 null,该方法是不阻塞的。源码如下: public E poll() { //(1)队列为空则返回null final AtomicInteger count = this.count; if (count.get() == 0) return null; //(2)获取独占锁 E x = null; int c = -1; final ReentrantLock takeLock = this.takeLock; takeLock.lock(); try { //(3)队列不空则出队并递减计数 if (count.get() > 0) {//3.1 x = dequeue();//3.2 c = count.getAndDecrement();//3.3 //(4) if (c > 1) notEmpty.signal(); } } finally { //(5) takeLock.unlock(); } //(6) if (c == capacity) signalNotFull(); //(7)返回 return x; } private E dequeue() { Node<E> h = head; Node<E> first = h.next; h.next = h; // help GC head = first; E x = first.item; first.item = null; return x; } 代码(1) 如果当前队列为空,则直接返回 null。 代码(2)获取独占锁 takeLock,当前线程获取该锁后,其它线程在调用 poll 或者 take 方法会被阻塞挂起。 代码 (3) 如果当前队列不为空则进行出队操作,然后递减计数器。 代码(4)如果 c>1 则说明当前线程移除掉队列里面的一个元素后队列不为空(c 是删除元素前队列元素个数),那么这时候就可以激活因为调用 poll 或者 take 方法而被阻塞到notEmpty 的条件队列里面的一个线程。 代码(5)释放锁,一定要在finally里面释放锁。 代码(6)说明当前线程移除队头元素前当前队列是满的,移除队头元素后队列当前至少有一个空闲位置,那么这时候就可以调用signalNotFull激活因为调用put 或者 offer 而被阻塞放到 notFull 的条件队列里的一个线程,signalNotFull源码如下: private void signalNotFull() { final ReentrantLock putLock = this.putLock; putLock.lock(); try { notFull.signal(); } finally { putLock.unlock(); } } poll 代码逻辑比较简单,值得注意的是获取元素时候只操作了队列的头节点。 4.peek 操作,获取队列头部元素但是不从队列里面移除,如果队列为空则返回 null,该方法是不阻塞的。源码如下: public E peek() { //(1) if (count.get() == 0) return null; //(2) final ReentrantLock takeLock = this.takeLock; takeLock.lock(); try { Node<E> first = head.next; //(3) if (first == null) return null; else //(4) return first.item; } finally { //(5) takeLock.unlock(); } } 可以看到代码(3)这里还是需要判断下 first 是否为 null 的,不能直接执行代码(4)。 正常情况下执行到代码(2)说明队列不为空,但是代码(1)和(2)不是原子性操作,也就是在执行代码(1)判断队列不为空后, 在代码(2)获取到锁前,有可能其他线程执行了poll 或者 take 操作导致队列变为了空,然后当前线程获取锁后,直接执行 first.item 会抛出空指针异常。 5.take 操作,获取当前队列头部元素并从队列里面移除,如果队列为空则阻塞调用线程。如果队列为空则阻塞当前线程知道队列不为空,然后返回元素,如果在阻塞的时候被其他线程设置了中断标志,则被阻塞线程会抛出InterruptedException 异常而返回。源码如下: public E take() throws InterruptedException { E x; int c = -1; final AtomicInteger count = this.count; //(1)获取锁 final ReentrantLock takeLock = this.takeLock; takeLock.lockInterruptibly(); try { //(2)当前队列为空则阻塞挂起 while (count.get() == 0) { notEmpty.await(); } //(3)出队并递减计数 x = dequeue(); c = count.getAndDecrement(); //(4) if (c > 1) notEmpty.signal(); } finally { //(5) takeLock.unlock(); } //(6) if (c == capacity) signalNotFull(); //(7) return x; } 代码(1)当前线程获取到独占锁,其他调用take 或者 poll的线程将会被阻塞挂起。 代码(2)如果队列为空则阻塞挂起当前线程,并把当前线程放入notEmpty 的条件队列。 代码(3)进行出队操作并递减计数。 代码(4)如果 c > 1 说明当前队列不为空,则唤醒notEmpty 的条件队列的条件队列里面的一个因为调用 take 或者 poll 而被阻塞的线程。 代码(5)释放锁。 代码(6)如果 c == capacity 则说明当前队列至少有一个空闲位置,则激活条件变量 notFull 的条件队列里面的一个因为调用 put 或者 offer 而被阻塞的线程。 6.remove操作,删除队列里面指定元素,有则删除返回 true,没有则返回 false,源码如下: public boolean remove(Object o) { if (o == null) return false; //(1)双重加锁 fullyLock(); try { //(2)遍历队列找则删除返回true for (Node<E> trail = head, p = trail.next; p != null; trail = p, p = p.next) { //(3) if (o.equals(p.item)) { unlink(p, trail); return true; } } //(4)找不到返回false return false; } finally { //(5)解锁 fullyUnlock(); } } 代码(1)通过fullyLock获取双重锁,当前线程获取后,其他线程进行入队或者出队的操作就会被阻塞挂起。双重锁方法fullyLock的源码如下: void fullyLock() { putLock.lock(); takeLock.lock(); } 代码(2)遍历队列寻找要删除的元素,找不到则直接返回false,找到则执行unlink操作,unlink的源码如下: void unlink(Node<E> p, Node<E> trail) { p.item = null; trail.next = p.next; if (last == p) last = trail; 如果当前队列满,删除后,也不忘记唤醒等待的线程 if (count.getAndDecrement() == capacity) notFull.signal(); } 可以看到删除元素后,如果发现当前队列有空闲空间,则唤醒 notFull 的条件队列中一个因为调 用 put 或者 offer 方法而被阻塞的线程。 代码(5)调用 fullyUnlock 方法使用与加锁顺序相反的顺序释放双重锁,源码如下: void fullyUnlock() { takeLock.unlock(); putLock.unlock(); } 7.size操作,获取当前队列元素个数。源码如下: public int size() { return count.get(); } 总结:由于在操作出队入队的时候操作Count的时候加了锁,因此相比ConcurrentLinkedQueue 的size方法比较准确。 最后用一张图来加深LinkedBlockingQueue的理解,如下图: 因此我们要思考一个问题:为何 ConcurrentLinkedQueue 中需要遍历链表来获取 size 而不适用一个原子变量呢? 这是因为使用原子变量保存队列元素个数需要保证入队出队操作和操作原子变量是原子操作,而ConcurrentLinkedQueue 是使用 CAS 无锁算法的,所以无法做到这个。

优秀的个人博客,低调大师

Java并发编程笔记之ReentrantLock源码分析

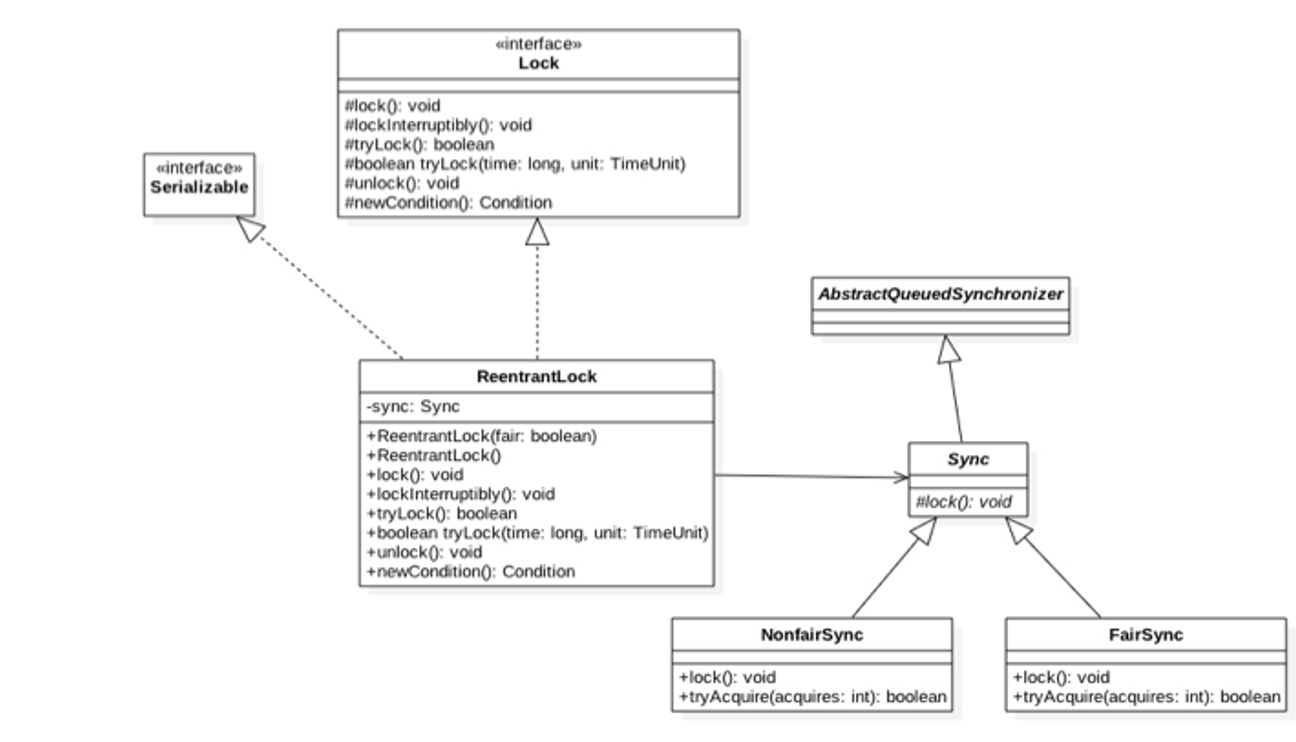
ReentrantLock是可重入的独占锁,同时只能有一个线程可以获取该锁,其他获取该锁的线程会被阻塞后放入该锁的AQS阻塞队列里面。 首先我们先看一下ReentrantLock的类图结构,如下图所示: 从类图可以知道,ReentrantLock最终还是使用AQS来实现,并且根据参数决定内部是公平锁还是非公平锁,默认是非公平锁。 首先我们先看ReentrantLock源码,看到其构造函数及其参数,这是决定内部是公平锁还是非公平锁,如下源码所示: public ReentrantLock() { sync = new NonfairSync(); } public ReentrantLock(boolean fair) { sync = fair ? new FairSync() : new NonfairSync(); } 其中类Sync直接继承自AQS,它的子类NonfairSync和FairSync分别实现了获取锁的公平和非公平策略。 在这里AQS的状态值state代表线程获取该锁的可重入次数,默认情况下state的值为0,标示当前锁没有被任何线程持有,当一个线程第一次获取该锁的时候会尝试使用CAS设置state的值为1,如果CAS成功则当前线程获取了该锁,然后记录该锁的持有者为当前线程, 在该线程没有释放锁,第二次获取该锁后,状态值会加1,被设置为2,这就是可重入次数,在该线程释放该锁的时候,会尝试使用CAS让状态值减1,如果减1 后状态值为0 则当前线程释放该锁。 接下来我们看一下ReentrantLock是如何获取锁的,如下: 1.void lock() 当一个线程调用该方法,说明该线程希望获取该锁,如果锁当前没有被其它线程占用并且当前线程之前没有获取该锁,则当前线程会获取到该锁,然后设置当前锁的拥有者为当前线程,并设置 AQS 的状态值为 1 后直接返回。 如果当前线程之前已经获取过该锁,则这次只是简单的把 AQS 的状态值 status 加 1 后返回。 如果该锁已经被其它线程持有,则调用该方法的线程会被放入 AQS 队列后阻塞挂起。源码如下: public void lock() { sync.lock(); } 如上面代码所示,ReentrantLock的lock()是委托给sync类,根据创建ReentrantLock的时候,构造函数选择sync的实现是NonfairSync或者FairSync,这里先看sync的子类NonfairSync的情况,也就是非公平锁的时候,源码如下: final void lock() { //(1)CAS设置状态值 if (compareAndSetState(0, 1)) setExclusiveOwnerThread(Thread.currentThread()); else //(2)调用AQS的acquire方法 acquire(1); } 如上面代码所示,代码(1)因为默认AQS的状态值为0,所以第一个调用Lock的线程会通过CAS设置状态值为1,CAS成功则代表当前线程获取到了锁,然后setExclusiveOwnerThread 设置了该锁持有者是当前线程。 如果这时候有其他线程调用lock方法企图获取该锁,执行代码(1)CAS会失败,然后会调用AQS的acquire方法,这里注意传递参数为1,接下来我们看AQS的acquire的核心代码,如下: public final void acquire(int arg) { //(3)调用ReentrantLock重写的tryAcquire方法 if (!tryAcquire(arg) && // tryAcquiref返回false会把当前线程放入AQS阻塞队列 acquireQueued(addWaiter(Node.EXCLUSIVE), arg)) selfInterrupt(); } 之前说过 AQS 并没有提供可用的 tryAcquire 方法,tryAcquire 方法需要子类自己定制化,所以这里代码(3)会调用 ReentrantLock 重写的 tryAcquire 方法代码。 这里先看下非公平锁的源码代码如下: protected final boolean tryAcquire(int acquires) { return nonfairTryAcquire(acquires); } final boolean nonfairTryAcquire(int acquires) { final Thread current = Thread.currentThread(); int c = getState(); //(4)当前AQS状态值为0 if (c == 0) { if (compareAndSetState(0, acquires)) { setExclusiveOwnerThread(current); return true; } }//(5)当前线程是该锁持有者 else if (current == getExclusiveOwnerThread()) { int nextc = c + acquires; if (nextc < 0) // overflow throw new Error("Maximum lock count exceeded"); setState(nextc); return true; }//(6) return false; } 正如上面代码(4)会看当前锁的状态值是否为0,为0则说明当前该锁空闲,那么就尝试CAS获取该锁(尝试将 AQS 的状态值从 0 设置为 1),并设置当前锁的持有者为当前线程返回返回 true。 如果当前状态值不为0 则说明该锁已经被某个县城持有,所以代码(5)看当前线程是否是该锁的持有者,如果当前线程是该锁持有者,状态值增加1,然后返回true。 如果当前线程不是锁的持有者则返回 false, 然后会被放入 AQS 阻塞队列。 到目前为止,介绍完了非公平锁的实现代码,回过头看看非公平锁在这里是怎么体现的,首先非公平是说:先尝试获取锁的线程并不一定比后尝试获取锁的线程优先获取锁。 这里假设线程 A 调用 lock()方法时候执行到了 nonfairTryAcquire 的代码(4)发现当前状态值不为 0,所以执行代码(5)发现当前线程不是线程持有者,则执行代码(6)返回 false,然后当前线程会被放入了 AQS 阻塞队列。 这时候线程 B 也调用了 lock() 方法执行到 nonfairTryAcquire 的代码(4)时候发现当前状态值为 0 了(假设占有该锁的其它线程释放了该锁)所以通过 CAS 设置获取到了该锁。而明明是线程 A 先请求获取的该锁那,这就是非公平锁的实现, 这里线程 B 在获取锁前并没有看当前 AQS 队列里面是否有比自己请求该锁更早的线程,而是使用了抢夺策略。 好了,知道非公平锁的实现了,那么我们接下来看一下公平锁是如何实现的呢? 公平锁的实现只需要看FairSync重写的tryAcquire方法,源码如下: protected final boolean tryAcquire(int acquires) { final Thread current = Thread.currentThread(); int c = getState(); //(7)当前AQS状态值为0 if (c == 0) { //(8)公平性策略 if (!hasQueuedPredecessors() && compareAndSetState(0, acquires)) { setExclusiveOwnerThread(current); return true; } } //(9)当前线程是该锁持有者 else if (current == getExclusiveOwnerThread()) { int nextc = c + acquires; if (nextc < 0) throw new Error("Maximum lock count exceeded"); setState(nextc); return true; }//(10) return false; } } 如上代码公平性的tryAcquire策略与非公平锁的类似,不同在于代码(8)处设置CAS前添加了hasQueuedPredecessors 方法,该方法是实现公平性的核心代码,源代码如下: public final boolean hasQueuedPredecessors() { Node t = tail; // Read fields in reverse initialization order Node h = head; Node s; return h != t &&((s = h.next) == null || s.thread != Thread.currentThread()); } 如上代码所示,如果当前线程节点有前驱节点则返回true,否则如果当前AQS队列为空或者当前线程节点是AQS的第一个节点则返回false。 其中如果h == t 则说明当前队列为空则直接返回false,如果h != t 并且 (s = h.next) ==null 说明有一个元素将要作为AQS的第一个节点入队列,那么返回true, 如果h != t 并且 (s = h.next) !=null 并且 s.thread !=Thread.currentThread() 则说明队列里面的第一个元素不是当前线程则返回 true。 2.void lockInterruptibly() 与 lock() 方法类似,不同在于该方法对中断响应,就是当前线程在调用该方式时候,如果其它线程调用了当前线程线程的 interrupt()方法,当前线程会抛出 InterruptedException 异常然后返回,源代码如下: public void lockInterruptibly() throws InterruptedException { sync.acquireInterruptibly(1); } public final void acquireInterruptibly(int arg)throws InterruptedException { //当前线程被中断则直接抛出异常 if (Thread.interrupted()) throw new InterruptedException(); //尝试获取资源 if (!tryAcquire(arg)) //调用AQS可被状态的方法 doAcquireInterruptibly(arg); } 3.boolean tryLock() 尝试获取锁,如果当前该锁没有被其它线程持有则当前线程获取该锁并返回 true, 否者返回 false,注意该方法不会引起当前线程阻塞。源码如下所示: public boolean tryLock() { return sync.nonfairTryAcquire(1); } final boolean nonfairTryAcquire(int acquires) { final Thread current = Thread.currentThread(); int c = getState(); if (c == 0) { if (compareAndSetState(0, acquires)) { setExclusiveOwnerThread(current); return true; } } else if (current == getExclusiveOwnerThread()) { int nextc = c + acquires; if (nextc < 0) // overflow throw new Error("Maximum lock count exceeded"); setState(nextc); return true; } return false; } 如上代码与非公平锁的 tryAcquire() 方法类似,所以 tryLock() 使用的是非公平策略。 4.boolean tryLock(long timeout, TimeUnit unit) 尝试获取锁与 tryLock()不同在于设置了超时时间,如果超时没有获取该锁则返回 false。源代码如下: public boolean tryLock(long timeout, TimeUnit unit)throws InterruptedException { //调用AQS的tryAcquireNanos方法。 return sync.tryAcquireNanos(1, unit.toNanos(timeout)); } 接下来我们要看一下,ReentrantLock是如何释放锁的。 1.void unlock() 尝试释放锁,如果当前线程持有该锁,调用该方法会让该线程对该线程持有的 AQS 状态值减一,如果减去 1 后当前状态值为 0 则当前线程会释放对该锁的持有,否者仅仅减一而已。 如果当前线程没有持有该锁调用了该方法则会抛出 IllegalMonitorStateException 异常 ,源代码如下: public void unlock() { sync.release(1); } protected final boolean tryRelease(int releases) { //(11)如果不是锁持有者调用UNlock则抛出异常。 int c = getState() - releases; if (Thread.currentThread() != getExclusiveOwnerThread()) throw new IllegalMonitorStateException(); boolean free = false; //(12)如果当前可重入次数为0,则清空锁持有线程 if (c == 0) { free = true; setExclusiveOwnerThread(null); } //(13)设置可重入次数为原始值-1 setState(c); return free; } 如上代码所示(11)如果当前线程不是该锁持有者则直接抛异常,否则,看状态值剩余值是否为0,为0 则说明当前线程要释放对该锁的持有权,则执行代码(12)把当前锁持有者设置为null。 如果剩余值不为0,则仅仅让当前线程对该锁的可重入次数减1。 到目前基本了解了ReentrantLock的原理,那么接下来我们是否可以用ReentrantLock来实现一个简单的线程安全的list呢? 例子如下: import java.util.ArrayList; import java.util.concurrent.locks.ReentrantLock; /** * Created by cong on 2018/6/12. */ public class ReentrantLockList { //线程不安全的list private ArrayList<String> array = new ArrayList<String>(); //独占锁 private volatile ReentrantLock lock = new ReentrantLock(); //添加元素 public void add(String e) { lock.lock(); try { array.add(e); } finally { lock.unlock(); } } //删元素 public void remove(String e) { lock.lock(); try { array.remove(e); } finally { lock.unlock(); } } //获取数据 public String get(int index) { lock.lock(); try { return array.get(index); } finally { lock.unlock(); } } } 如上代码通过在操作 array 元素前进行加锁保证同时只有一个线程可以对 array 数组进行修改,但是同时也只能有一个线程对 array 元素进行访问。 最后几个图加深前面所学的内容,如下图所示: 如上图,假如线程 Thread1,Thread2,Thread3 同时尝试获取独占锁 ReentrantLock,假设 Thread1 获取到了,则 Thread2 和 Thread3 就会被转换为 Node 节点后放入 ReentrantLock 对应的 AQS 阻塞队列后阻塞挂起。 如上图,假设 Thread1 获取锁后调用了对应的锁创建的条件变量 1,那么 Thread1 就会释放获取到的锁,然后当前线程就会被转换为 Node 节点后插入到条件变量 1 的条件队列,由于 Thread1 释放了锁, 所以阻塞到 AQS 队列里面 Thread2 和 Thread3 就有机会获取到该锁,假如使用的公平策略,那么这时候 Thread2 会获取到该锁,会从 AQS 队列里面移除 Thread2 对应的 Node 节点。

优秀的个人博客,低调大师

Java并发编程-队列同步器(AbstractQueuedSynchronizer)

章节目录 Lock接口与Synchronized的区别及特性 队列同步器的接口与自定义锁示例 队列同步器的实现分析 1.Lock接口与Synchronized的区别及特性 特性 描述 尝试非阻塞性的获取锁 当前线程尝试获取锁(自旋获取锁),如果这一时刻锁没有被其他线程获取到,则成功获取并持有锁 能被中断的获取锁 已获取锁的线程可以响应中断,当获取到锁的线程被中断时,可以抛出中断异常,同时锁会被释放 超时获取锁 在指定的截止时间之前获取锁,如果截止时间到了仍然没有获取到锁,则返回 注意:Lock接口的实现基本上都是通过聚合了一个同步器的子类来完成线程访问控制的 队里同步器的接口与定义锁示例 队列同步器定义: 队列同步器,是用来构建锁与其它同步组件的基础框架,基本数据结构与内容是: 1、int state -> state 标示同步状态; 2、内置的FIFO来完成获取同步状态的线程的排队工作。 队列同步器使用方式 1、子类通过继承同步器并实现它的抽象方法来管理同步状态; 2、实现过程中对同步状态的更改,通过 setState()、 setState(int newState)、 compareAndSetState(int expect,int newUpdateValue) 来进行操作,保证状态改变时原子性的、安全的; 3、实现同步器的子类被推荐为自定义同步组件的静态内部类; 4、同步器可以支持独占式的获取同步状态(ReentrantLock)、也可以支持共享 式的获取同步状态(ReentrantReadWriteLock) 对于同步器与锁的关系可以这样理解: 在锁的实现中聚合同步器,利用同步器实现锁的语义。 锁面向使用者,它定义了使用者与锁的交互接口,隐藏了实现细节。 同步器面向的是锁的实现者,它简化了锁的实现方式,屏蔽了同步器状态管理、线程排队、等待与唤醒等底层操作。 2.队列同步器的接口与自定义锁示例 2.1 模板方法模式 同步器的设置是基于**模版方法模式**,使用者需要继承同步器并重写指定的方 法,随后将同步器组合在自定义同步组件的实现中,并调用同步器提供的模板 方法,而这些模板方法将会调用使用者重写的方法。 2.2 重写同步器指定的方法 getState():获取当前同步状态 setState(int newState):设置当前同步状态 compareAndSetState(int expect,int update): 使用CAS设置当前的状态,该方 法保证状态设置的原子性 2.3 同步器可重写的方法 方法名称 描述 protected boolean tryAcquire(int arg) 独占式获取同步状态,实现该方法需要查询当前状态并判断同步状态是否符合预期,然后再进行CAS设置同步状态 protected boolean tryRelease(int arg) 独占式释放同步状态,等待获取同步状态的线程将有机会获取同步状态(公平性获取锁) protected int tryAcquireShared(int arg) 共享式获取同步状态,返回>=0的值,标示获取成功,反之获取失败 protected boolean tryReleaseShared(int arg) 共享式释放同步状态 protected boolean isHeldExclusively() 当前同步器是否在独占模式下被线程占用,一般该方法表示是否被当前线程所独占 2.4 独占锁示例 package org.seckill.lock; import java.util.concurrent.TimeUnit; import java.util.concurrent.locks.AbstractQueuedSynchronizer; import java.util.concurrent.locks.Condition; import java.util.concurrent.locks.Lock; /** * 利用了模板方法模式 */ public class Mutex implements Lock { private static class Sync extends AbstractQueuedSynchronizer { //是否处于占用状态 @Override protected boolean isHeldExclusively() { return getState() == 1; } //当状态为0时获取锁 @Override protected boolean tryAcquire(int arg) { if (compareAndSetState(0, 1)) { setExclusiveOwnerThread(Thread.currentThread()); return true; } return false; } //释放锁,将当前状态设置为0 @Override protected boolean tryRelease(int arg) { if (getState() == 0) { throw new IllegalMonitorStateException(); } setExclusiveOwnerThread(null); setState(0); return true; } //返回一个condition,每个condition中都包含了一个condition队列 Condition newCondition() { return new ConditionObject(); } } //仅需要将操作代理到Sync上即可 private Sync sync = new Sync(); public void lock() { sync.acquire(1);//调用tryAccquire } //当前已获取锁的线程响应中断,释放锁,抛出异常,并返回 public void lockInterruptibly() throws InterruptedException { sync.acquireInterruptibly(1); } public boolean tryLock() { return sync.tryAcquire(1);//尝试立即获取锁 } public boolean tryLock(long timeout, TimeUnit unit) throws InterruptedException { return sync.tryAcquireNanos(1, unit.toNanos(timeout));//尝试超时获取锁 } public void unlock() { sync.release(1);//释放锁 } public Condition newCondition() { return sync.newCondition(); } } 总结-实现同步组件的方法 1. 独占锁Mutex 是一个自定义同步组件,它允许同一时刻只允许同一个线程占有锁。 2.Mutex中定义了一个私有静态内部类,该类继承了同步器并实现了独占式获取和释放同步状态。 3.在tryAcquire(int acquires)方法中,经过CAS设置成功(同步状态设置为1),则 代表获取了同步状态,而在tryRelease(int releases) 方法中只是将同步状态重 置为0。 3 队列同步器的实现分析 3.1 同步队列数据结构 同步器依赖内部的同步队列,即一个FIFO的队列,这个队列由双向链表实现。节点数据从 队列尾部插入,头部删除。 node 数据结构 struct node { node prev; //节点前驱节点 node next; //节点后继节点 Thread thread; //获取同步状态的线程 int waitStatus; //等待状态 Node nextWaiter; //等待队列中的后继节点 } 等待队列 后续篇章介绍到condition会有相关记录。 同步队列基本结构 3.2 无法获取到同步状态的线程节点被加入到同步队列的尾部 本质上是采用 compareAndSetTail(Node expect,Node update),当一个线程成功的获取了同步状态 (或者锁),其他线程将无法获取到同步状态,转而被构造成为节点并加入到同步队列中,而这个加入队列的过程 必须要保证线程安全。所以采用了基于CAS的方式来设置尾节点的方法。 ,需要传递当前节点认为的尾节点和当前节点,只有设置成功后,当前节点才正式与之前的尾节点建立关联。 3.3 成功获取同步状态 同步队列遵循FIFO,首节点是获取同步状态成功的节点,首节点的线程在释放 同步状态时,会唤醒后继节点,而后继节点将会在获取同步状态成功时,将自己设置为首节点。 3.4 独占式同步状态获取与释放 前驱节点为头节点且能够获取同步状态的判断条件和线程进入同步队列 来获 取同步状态是自旋的过程。 设置首节点是通过获取同步状态成功的线程来完成的acquireQueued(node,args)完成的 独占式获取同步状态的流程图 独占式同步状态(锁)获取流程

优秀的个人博客,低调大师

Java并发编程的艺术(十二)——线程安全

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/80289238 1. 什么是『线程安全』? 如果一个对象构造完成后,调用者无需额外的操作,就可以在多线程环境下随意地使用,并且不发生错误,那么这个对象就是线程安全的。 2. 线程安全的几种程度 线程安全性的前提:对『线程安全性』的讨论必须建立在对象内部存在共享变量这一前提,若对象在多条线程间没有共享数据,那这个对象一定是线程安全的! 2.1. 绝对的线程安全 上述线程安全性的定义即为绝对线程安全的情况,即:一个对象在构造完之后,调用者无需任何额外的操作,就可以在多线程环境下随意使用。绝对的线程安全是一种理想的状态,若要达到这一状态,往往需要付出巨大的代价。通常并不需要达到绝对的线程安全。 2.2. 相对的线程安全 我们通常所说的『线程安全』即为『相对的线程安全』,JDK中标注为线程安全的类通常就是『相对的线程安全』,如:Vector、HashTable、Collections.synchronizedXXX。对于相对线程安全的类,使用它们时一般不需要使用额外的保障措施,但对于一些特定的使用场景,仍然需要额外的操作来保证线程安全,如: // 读线程 Thread t1 = new Thread( new Runnable(){ public void run(){ for(int i=0; i<vector.size(); i++){ System.out.println( vector.get(i) ); } } }).start(); // 写线程 Thread t2 = new Thread( new Runnable(){ public void run(){ for(int i=0; i<vector.size(); i++){ vector.remove(i); } } }).start(); 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 vector是一个线程安全的容器,它所提供的方法均为同步方法,但上述代码仍然会出现线程安全性问题:若线程1读了一半的元素后暂停,线程2开始执行,并删除了所有的元素,然后线程1继续执行,此时发生角标越界异常!修改方案:加上额外的同步 // 读线程 Thread t1 = new Thread( new Runnable(){ public void run(){ synchronized( vector ){ for(int i=0; i<vector.size(); i++){ System.out.println( vector.get(i) ); } } } }).start(); // 写线程 Thread t2 = new Thread( new Runnable(){ public void run(){ synchronized( vector ){ for(int i=0; i<vector.size(); i++){ vector.remove(i); } } } }).start(); 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 2.3. 线程对立 线程对立指的是:不论调用者采用何种同步措施,都无法达到线程安全的目的。如Thread类的suspend、resume方法就是线程对立的方法。suspend方法会暂停线程,但它不会释放资源,若resume需要请求到该资源才会被运行的话,系统就会进入死锁状态。 3. 实现线程安全的方法 3.1. 互斥同步 同步指的是同一时刻,只有一条线程操作『共享变量』。 实现同步的方式有很多:互斥访问、CAS操作。互斥会引起阻塞,当一条线程请求一个已经被另一线程使用的锁时,就会进入阻塞态;而进入阻塞态会涉及上下文切换。因此,使用互斥来实现同步的开销是很大的。 互斥同步(阻塞式同步)是一种『悲观锁』,即它认为总是存在多条线程竞争资源的情况,因此它不管当前是不是真的有多条线程在竞争共享资源,它总是先上锁,然后再处理。 Java中有两种实现互斥同步的方式:synchronized和ReentrantLock。 synchronized 编译器会在synchronized同步块的开始和结束位置加上monitorenter和monitorexit指令; 这两个指令需要一个reference类型的参数来指名要锁定和解锁的对象; 若同步块没有明确指定锁对象,那么就使用当前对象或当前类的Class对象; 它是一把可重入的锁,即:当前线程在已经获得锁的情况下,可以再次获取该锁,因此不会出现当前线程把自己锁死的情况; ReentrantLock它也是一把可重入的锁,但比synchronized多如下功能: 等待可中断:若一条线程长时间占用锁不释放,那被阻塞的线程可以选择放弃等待,而去做别的事;这对于要处理长时间的同步块时是很有帮助的。 可实现公平锁:synchronized是一种非公平锁,即:被阻塞的线程竞争锁是随机的;而公平锁是根据被阻塞线程先来后到的顺序给予锁。ReentrantLock默认是非公平锁,可以通过构造函数构造公平锁。 可以绑定多个条件:synchronized可使用wait/notify来实现等待/通知机制,但一个synchronized同步块只能使用一次,若要使用多次,就需要嵌套同步块;但ReentrantLock可以通过newCondition创建多个条件。 synchronized和ReentrantLock如何选择?优先选择synchronized!JDK1.6已经对synchronized做了很多优化,性能与ReentrantLock相差不大。在条件允许的请况下应优先选择synchronized。 3.2. 非阻塞同步 它是一种『乐观锁』,即它总是认为当前没有线程使用共享资源,因此它不管当前的状态,直接操作共享资源,若发现产生了冲突,那么再采取补偿措施(如:CAS的补偿措施就是不断尝试,直到不发生冲突为止),这种方式线程无需进入阻塞态(挂起态),因此称为『非阻塞同步』。 JUC中各种整形原子类的自增、自减等操作就使用了CAS。 CAS操作过程:CAS操作存在3个值:共享变量V、预期的旧值A、新值B,若V与A相同,则将V更新成B,否则就不更新,继续循环比较,直到更新完成为止。 CAS操作可能引发的问题:ABA问题。若V一开始的值为A,但在准备赋新值的过程中A变成了B,又变成了A,而CAS操作误认为V没有被改过。 无同步方案 『阻塞式同步』和『非阻塞式同步』都是同一时刻只让一条线程处理共享数据,而下面的方案使得多条线程之间不存在共享数据,从而无需同步。 可重入代码如果一块代码段只要输入的值一样其结果就一样的话,这段代码就叫『可重入代码』。这一类代码天生具有线程安全性,线程随意切换结果都一样。 线程封闭线程封闭:把所有涉及共享变量操作的任务都放在一个线程中运行。这样就不存在多条线程同时处理共享变量了,从而达到了线程安全目的。 WEB服务器采用的就是这种方式,它把每个请求封装在一条线程中处理,从而不存在线程安全性问题。 不可变对象如果是共享的基本数据类型变量,只要被final修饰,它就是不可变的;如果是共享的对象,那就要确保它内部的共享成员变量不会被它的行为所改变。PS:保证对象内部共享变量不会被改变的方法有很多,最简单粗暴的方式就是将所有共享变量用final修饰。 不可变对象一定是线程安全的。

优秀的个人博客,低调大师

Java并发编程的艺术(十三)——锁优化

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/80289271 自旋锁 背景:互斥同步对性能最大的影响是阻塞,挂起和恢复线程都需要转入内核态中完成;并且通常情况下,共享数据的锁定状态只持续很短的一段时间,为了这很短的一段时间进行上下文切换并不值得。 原理:当一条线程需要请求一把已经被占用的锁时,并不会进入阻塞状态,而是继续持有CPU执行权等待一段时间,该过程称为『自旋』。 优点:由于自旋等待锁的过程线程并不会引起上下文切换,因此比较高效; 缺点:自旋等待过程线程一直占用CPU执行权但不处理任何任务,因此若该过程过长,那就会造成CPU资源的浪费。 自适应自旋:自适应自旋可以根据以往自旋等待时间的经验,计算出一个较为合理的本次自旋等待时间。 锁清除 编译器会清除一些使用了同步,但同步块中没有涉及共享数据的锁,从而减少多余的同步。 锁粗化 若有一系列操作,反复地对同一把锁进行上锁和解锁操作,编译器会扩大这部分代码的同步块的边界,从而只使用一次上锁和解锁操作。 轻量级锁 本质:使用CAS取代互斥同步。 背景:『轻量级锁』是相对于『重量级锁』而言的,而重量级锁就是传统的锁。 轻量级锁与重量级锁的比较: 重量级锁是一种悲观锁,它认为总是有多条线程要竞争锁,所以它每次处理共享数据时,不管当前系统中是否真的有线程在竞争锁,它都会使用互斥同步来保证线程的安全; 而轻量级锁是一种乐观锁,它认为锁存在竞争的概率比较小,所以它不使用互斥同步,而是使用CAS操作来获得锁,这样能减少互斥同步所使用的『互斥量』带来的性能开销。 实现原理: 对象头称为『Mark Word』,虚拟机为了节约对象的存储空间,对象处于不同的状态下,Mark Word中存储的信息也所有不同。 Mark Word中有个标志位用来表示当前对象所处的状态。 当线程请求锁时,若该锁对象的Mark Word中标志位为01(未锁定状态),则在该线程的栈帧中创建一块名为『锁记录』的空间,然后将锁对象的Mark Word拷贝至该空间;最后通过CAS操作将锁对象的Mark Word指向该锁记录; 若CAS操作成功,则轻量级锁的上锁过程成功; 若CAS操作失败,再判断当前线程是否已经持有了该轻量级锁;若已经持有,则直接进入同步块;若尚未持有,则表示该锁已经被其他线程占用,此时轻量级锁就要膨胀成重量级锁。 前提:轻量级锁比重量级锁性能更高的前提是,在轻量级锁被占用的整个同步周期内,不存在其他线程的竞争。若在该过程中一旦有其他线程竞争,那么就会膨胀成重量级锁,从而除了使用互斥量以外,还额外发生了CAS操作,因此更慢! 偏向锁 作用:偏向锁是为了消除无竞争情况下的同步原语,进一步提升程序性能。 与轻量级锁的区别:轻量级锁是在无竞争的情况下使用CAS操作来代替互斥量的使用,从而实现同步;而偏向锁是在无竞争的情况下完全取消同步。 与轻量级锁的相同点:它们都是乐观锁,都认为同步期间不会有其他线程竞争锁。 原理:当线程请求到锁对象后,将锁对象的状态标志位改为01,即偏向模式。然后使用CAS操作将线程的ID记录在锁对象的Mark Word中。以后该线程可以直接进入同步块,连CAS操作都不需要。但是,一旦有第二条线程需要竞争锁,那么偏向模式立即结束,进入轻量级锁的状态。 优点:偏向锁可以提高有同步但没有竞争的程序性能。但是如果锁对象时常被多条线程竞争,那偏向锁就是多余的。 偏向锁可以通过虚拟机的参数来控制它是否开启。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册