首页 文章 精选 留言 我的

精选列表

搜索[轻量版],共10000篇文章
优秀的个人博客,低调大师

OpenResty 1.19.9.1 正式版发布

OpenResty 1.19.9.1 已正式发布,此版本包含了过去几个月所有的优化、bug 修复和新特性。 底层基于较新的nginx 主线版本 1.19.9 从上游LuaJIT仓库引入了许多错误修复程序 引入新的宏LUAJIT_TEST_FIXED_ORDER用于 lua 表的固定 (fixed-order) 顺序遍历 当 lua 请求内存失败时,会采取调用abort()的方式来处理,而不是进行关闭 get_ctx_table支持使用来自调用者的 ctx 表,可降低创建新 ctx 表的成本 修复使用lua-tablepool清除 lua table 内容时,metatable 没有被清除的问题 为了在使用lua-tablepool时获得更好性能,当内存池的大小大于 max_pool_size 时丢弃对象 针对 stream 子系统实现ngx.processAPI 此外,官方新增了 alpine 3.14 的 x86_64 和 arm64 的官方包仓库: https://openresty.org/cn/linux-packages.html 完整的发布公告: https://openresty.org/cn/ann-1019009001.html 下载地址: https://openresty.org/cn/download.html

优秀的个人博客,低调大师

sqltoy-orm-4.18.25 发版

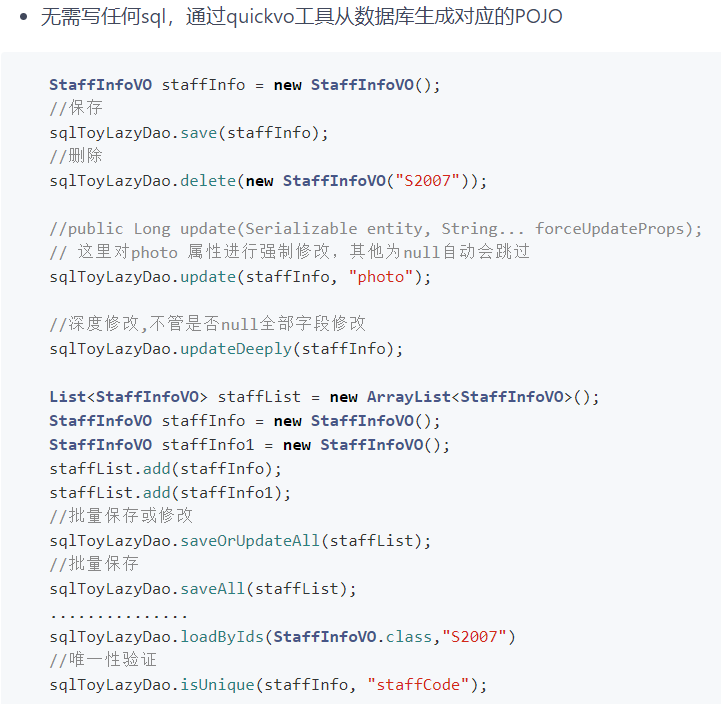
开源地址: github:https://github.com/sagframe/sagacity-sqltoy gitee:https://gitee.com/sagacity/sagacity-sqltoy idea 插件(可直接在idea中检索安装):https://github.com/threefish/sqltoy-idea-plugins 更新内容 1、修复oracle 表无主键保存的一个NPP错误 2、优化defaultDataSource获取模式,适应dynamic-datasource插件场景 3、在sqlToyContext中扩展了ConnectionFactory 供自定义获取当前ThreadLocal中的connection的机制,为非spring场景做铺垫 ORM的最佳形态:类JPA对象式操作+超强查询 jpa对象式操作:dao.save(entity)/saveAll(List<Entity>)/update(entity)/load(new Entity(id)) 模式,简单直接,对此大家基本能形成共识,也是各种ORM差异最小的。sqltoy在这个方面相信是对等的,因为是共识理论上来说不必要每次都提及! 2.超强查询:最理想的状态就是:第一在数据库客户端调试好的sql 最直观高效的移入项目工程中;第二、在需求变化时最简单快速的可以从工程中放入数据库客户端中进行调试。也就是说要最大限度的保持sql的原始面貌; 用ORM我们真真正正的痛点是什么? 1、sql的编写和后期维护,上面的图例已经说明问题。 2、执行效率:当同样功能效率有几倍差距时其实就是天地之别了,带来的直接效果就是:一边是用户的高度夸赞、一边是用户的鄙视,您能理解这是什么差距吗? sqltoy的缓存翻译,大幅减少表关联简化sql,让你的查询性能成几何级提升 极致的分页,同样帮助你实现查询的性能大幅提升 快速分页:@fast() 实现先取单页数据然后再关联查询,极大提升速度 分页优化器:page-optimize 让分页查询由两次变成1.3~1.5次(用缓存实现相同查询条件的总记录数量在一定周期内无需重复查询 sqltoy的分页取总记录的过程不是简单的select count(1) from (原始sql);而是智能判断是否变成:select count(1) from 'from后语句', 并自动剔除最外层的order by sqltoy支持并行查询:parallel="true",同时查询总记录数和单页数据,大幅提升性能 在极特殊情况下sqltoy分页考虑是最优化的,如:with t1 as (),t2 as @fast(select * from table1) select * from xxx 这种复杂查询的分页的处理,sqltoy的count查询会是:with t1 as () select count(1) from table1, 如果是:with t1 as @fast(select * from table1) select * from t1 ,count sql 就是:select count(1) from table1 做过统计分析的您,害怕数据旋转吗?害怕同比环比吗? 无限极分组统计(含汇总求平均),算法配置简单又跨数据库! 同比环比 sqltoy还有什么? 因为篇幅原因,这里不过多展开,我相信您想要的,在sqltoy中基本都可以找到满意的答案!比如:分库分表、树形数据处理、sql跨数据库等等!

优秀的个人博客,低调大师

Ansible 4.0.0 稳定版发布

Red Hat 已于上周发布了 Ansible 4.0,并表示此次更新基于 ansible-core-2.11.x 软件包,对于Ansible 3 使用的软件包来说是一次重大更新。Ansible 3 基于 Ansible Base 2.10.x,所以 4 和 3 的 core playbook 语言可能会向后不兼容。详情查看迁移指南。 获取新版本 由于 PIP 的限制,如果希望从 Ansible 3(或者更早版本)进行升级,则需要在安装 Ansible 4 之前卸载Ansible 和 Ansible Base。 $ pip uninstall ansible ansible-base $ pip install ansible==4.0.0 --user Ansible 4.0.0:https://pypi.python.org/packages/source/a/ansible/ansible-4.0.0.tar.gz 新特性 此版本基于 Ansible Core 2.11,它是 ansible-core 软件包的一次重大更新,因此可能包含对 playbook 语言和命令行 line0 程序的向后不兼容的变化。详情查看迁移指南。 添加一种以编程方式安装 Ansible 软件包版本的方法 python -c 'from ansible_collections.ansible_release import ansible_version; print(ansible_version)' 4.0.0 官方表示,由于 Ansible 4 已发布,因此对 Ansible 3 的更新即将停止。新的次要版本大约每三周发布一次(Ansible 4.1.0、Ansible 4.2.0 等)。这些版本将包含错误修复和新功能,但不存在向后不兼容的情况。 更新日志

优秀的个人博客,低调大师

熔断原理与实现Golang版

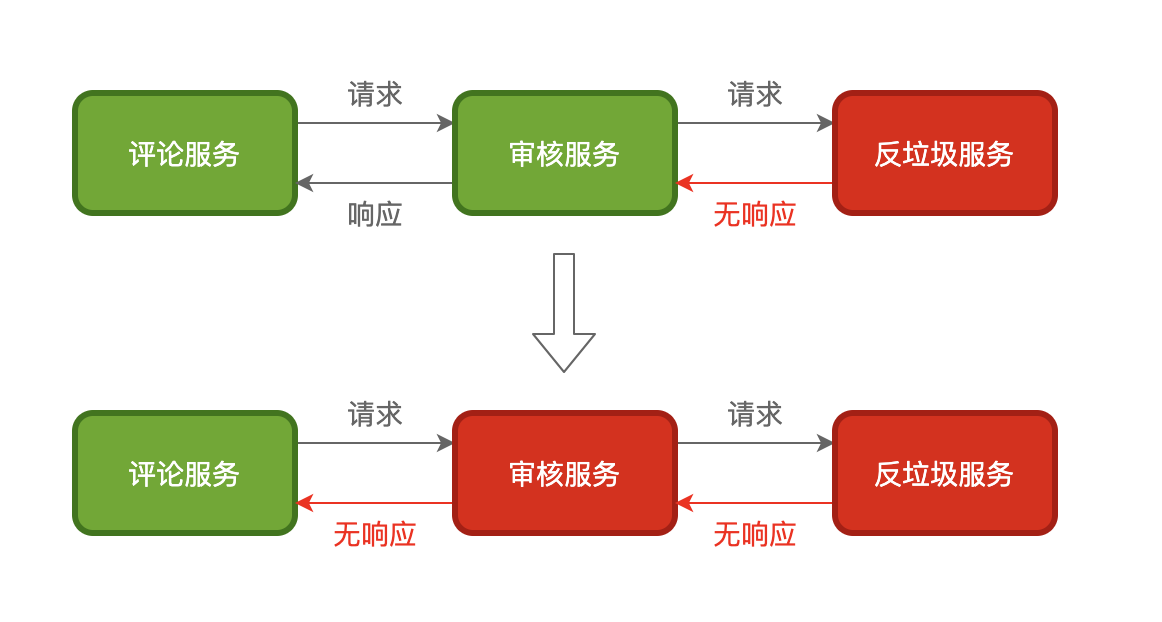
在微服务中服务间依赖非常常见,比如评论服务依赖审核服务而审核服务又依赖反垃圾服务,当评论服务调用审核服务时,审核服务又调用反垃圾服务,而这时反垃圾服务超时了,由于审核服务依赖反垃圾服务,反垃圾服务超时导致审核服务逻辑一直等待,而这个时候评论服务又在一直调用审核服务,审核服务就有可能因为堆积了大量请求而导致服务宕机 由此可见,在整个调用链中,中间的某一个环节出现异常就会引起上游调用服务出现一些列的问题,甚至导致整个调用链的服务都宕机,这是非常可怕的。因此一个服务作为调用方调用另一个服务时,为了防止被调用服务出现问题进而导致调用服务出现问题,所以调用服务需要进行自我保护,而保护的常用手段就是熔断 熔断器原理 熔断机制其实是参考了我们日常生活中的保险丝的保护机制,当电路超负荷运行时,保险丝会自动的断开,从而保证电路中的电器不受损害。而服务治理中的熔断机制,指的是在发起服务调用的时候,如果被调用方返回的错误率超过一定的阈值,那么后续的请求将不会真正发起请求,而是在调用方直接返回错误 在这种模式下,服务调用方为每一个调用服务(调用路径)维护一个状态机,在这个状态机中有三个状态: 关闭(Closed):在这种状态下,我们需要一个计数器来记录调用失败的次数和总的请求次数,如果在某个时间窗口内,失败的失败率达到预设的阈值,则切换到断开状态,此时开启一个超时时间,当到达该时间则切换到半关闭状态,该超时时间是给了系统一次机会来修正导致调用失败的错误,以回到正常的工作状态。在关闭状态下,调用错误是基于时间的,在特定的时间间隔内会重置,这能够防止偶然错误导致熔断器进去断开状态 打开(Open):在该状态下,发起请求时会立即返回错误,一般会启动一个超时计时器,当计时器超时后,状态切换到半打开状态,也可以设置一个定时器,定期的探测服务是否恢复 半打开(Half-Open):在该状态下,允许应用程序一定数量的请求发往被调用服务,如果这些调用正常,那么可以认为被调用服务已经恢复正常,此时熔断器切换到关闭状态,同时需要重置计数。如果这部分仍有调用失败的情况,则认为被调用方仍然没有恢复,熔断器会切换到关闭状态,然后重置计数器,半打开状态能够有效防止正在恢复中的服务被突然大量请求再次打垮 服务治理中引入熔断机制,使得系统更加稳定和有弹性,在系统从错误中恢复的时候提供稳定性,并且减少了错误对系统性能的影响,可以快速拒绝可能导致错误的服务调用,而不需要等待真正的错误返回 熔断器引入 上面介绍了熔断器的原理,在了解完原理后,你是否有思考我们如何引入熔断器呢?一种方案是在业务逻辑中可以加入熔断器,但显然是不够优雅也不够通用的,因此我们需要把熔断器集成在框架内,在zRPC框架内就内置了熔断器 我们知道,熔断器主要是用来保护调用端,调用端在发起请求的时候需要先经过熔断器,而客户端拦截器正好兼具了这个这个功能,所以在zRPC框架内熔断器是实现在客户端拦截器内,拦截器的原理如下图: 对应的代码为: func BreakerInterceptor(ctx context.Context, method string, req, reply interface{}, cc *grpc.ClientConn, invoker grpc.UnaryInvoker, opts ...grpc.CallOption) error { // 基于请求方法进行熔断 breakerName := path.Join(cc.Target(), method) return breaker.DoWithAcceptable(breakerName, func() error { // 真正发起调用 return invoker(ctx, method, req, reply, cc, opts...) // codes.Acceptable判断哪种错误需要加入熔断错误计数 }, codes.Acceptable) } 熔断器实现 zRPC中熔断器的实现参考了Google SRE过载保护算法,该算法的原理如下: 请求数量(requests):调用方发起请求的数量总和 请求接受数量(accepts):被调用方正常处理的请求数量 在正常情况下,这两个值是相等的,随着被调用方服务出现异常开始拒绝请求,请求接受数量(accepts)的值开始逐渐小于请求数量(requests),这个时候调用方可以继续发送请求,直到requests = K * accepts,一旦超过这个限制,熔断器就回打开,新的请求会在本地以一定的概率被抛弃直接返回错误,概率的计算公式如下: 通过修改算法中的K(倍值),可以调节熔断器的敏感度,当降低该倍值会使自适应熔断算法更敏感,当增加该倍值会使得自适应熔断算法降低敏感度,举例来说,假设将调用方的请求上限从 requests = 2 acceptst 调整为 requests = 1.1 accepts 那么就意味着调用方每十个请求之中就有一个请求会触发熔断 代码路径为go-zero/core/breaker type googleBreaker struct { k float64 // 倍值 默认1.5 stat *collection.RollingWindow // 滑动时间窗口,用来对请求失败和成功计数 proba *mathx.Proba // 动态概率 } 自适应熔断算法实现 func (b *googleBreaker) accept() error { accepts, total := b.history() // 请求接受数量和请求总量 weightedAccepts := b.k * float64(accepts) // 计算丢弃请求概率 dropRatio := math.Max(0, (float64(total-protection)-weightedAccepts)/float64(total+1)) if dropRatio <= 0 { return nil } // 动态判断是否触发熔断 if b.proba.TrueOnProba(dropRatio) { return ErrServiceUnavailable } return nil } 每次发起请求会调用doReq方法,在这个方法中首先通过accept效验是否触发熔断,acceptable用来判断哪些error会计入失败计数,定义如下: func Acceptable(err error) bool { switch status.Code(err) { case codes.DeadlineExceeded, codes.Internal, codes.Unavailable, codes.DataLoss: // 异常请求错误 return false default: return true } } 如果请求正常则通过markSuccess把请求数量和请求接受数量都加一,如果请求不正常则只有请求数量会加一 func (b *googleBreaker) doReq(req func() error, fallback func(err error) error, acceptable Acceptable) error { // 判断是否触发熔断 if err := b.accept(); err != nil { if fallback != nil { return fallback(err) } else { return err } } defer func() { if e := recover(); e != nil { b.markFailure() panic(e) } }() // 执行真正的调用 err := req() // 正常请求计数 if acceptable(err) { b.markSuccess() } else { // 异常请求计数 b.markFailure() } return err } 总结 调用端可以通过熔断机制进行自我保护,防止调用下游服务出现异常,或者耗时过长影响调用端的业务逻辑,很多功能完整的微服务框架都会内置熔断器。其实,不仅微服务调用之间需要熔断器,在调用依赖资源的时候,比如mysql、redis等也可以引入熔断器的机制。 项目地址: https://github.com/tal-tech/go-zero 欢迎使用 go-zero 并 star 支持我们!

优秀的个人博客,低调大师

QEMU 6.0.0 稳定版发布

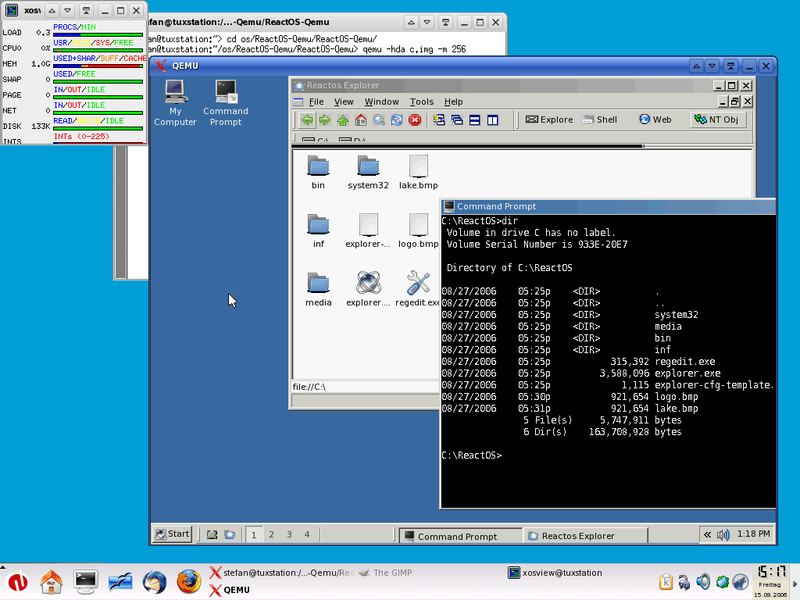
QEMU 6.0.0 已正式 GA。发布公告显示,共有 268 名贡献者为此版本提交了 3300+ commits。 更新亮点: 68k: 基于 virtio 设备的新“虚拟”机器类型 ARM: 支持 ARMv8.1-M ‘Helium’ 架构和 Cortex-M55 CPU ARM: 支持 ARMv8.4 TTST, SEL2 和 DIT 扩展 ARM:系统和用户模式模拟支持 ARMv8.5 MemTag 扩展 ARM: 支持新的 mps3-an524, mps3-an547 板型号 ARM: 对 xlnx-zynqmp, xlnx-versal, sbsa-ref, npcm7xx 和 sabrelite 电路板模型的附加设备仿真支持 Hexagon: 高通六角 DSP 单元的新仿真支持 MIPS:支持龙芯 3‘virt’机器类型 PowerPC:对 PowerNV 机器类型的外部 BMC 支持 PowerPC:pseries 计算机现在会将内存拔出故障反馈给管理工具,并重试不成功的 CPU 拔出请求 RISC-V: Microchip PolarFire 板现在支持 QSPI NOR 闪存 Tricore: 支持新的模拟 Infineon TC27x SoC 的 TriBoard 电路板模型 x86:AMD SEV-ES 支持以安全的 CPU 寄存器状态运行 guest x86: protection keys (PKS) 的 TCG 仿真支持 ACPI:支持将 NIC 分配给 guest OS 中的已知名称,而与 PCI 插槽的位置无关 NVMe: 对 v1.4 规范的新仿真支持,具有许多新功能,包括对分区命名空间 (Zoned Namespaces) 的实验性支持、多路径 I/O 和端到端数据保护 virtiofs:使用新的 USE_KILLPRIV_V2 guest 虚拟机功能提升性能 VNC: virtio-vga 支持基于客户端窗口大小的缩放方案 QMP: 备份作业现在支持并行的多个异步请求 …… 点此查看完整 Changelog。 下载地址:https://www.qemu.org/download/#source QEMU 由 Fabrice Bellard 创建,是一个纯软件实现的通用模拟器和虚拟机,它有三种模式,几乎可以模拟任何硬件设备: Full-system emulation:可在任何支持的硬件架构上运行任何操作系统 User-mode emulation:运行另一个 Linux/BSD 程序 Virtualization:接近本机性能运行KVM 和 Xen 虚拟机

优秀的个人博客,低调大师

nginx 1.20.0 稳定版发布

nginx 最新稳定分支 1.20 已发布,新版本引入了来自 1.19.x 主线分支的新功能和错误修复,其中包括: 使用 OCSP进行客户端 SSL 证书验证 引入ssl_reject_handshake和ssl_conf_command指令 使用lingering_close,keepalive_timeout, keepalive_time和keepalive_requests指令简化和提升对HTTP/2 连接的处理 以严格模式处理上游服务器的响应 支持处理cookie flags 基于最小可用空间的缓存清除 从客户端和邮件代理的后端服务器均支持 PROXY 协议 支持在 SMTP 代理后端启用用户身份验证 stream 模块新增set指令 …… 具体每个指令的介绍,访问此链接进行查看。 nginx 1.20.0 下载地址:http://nginx.org/en/download.html 根据 nginx 发布新版的策略,“稳定”指的是功能和更新频率,它与软件质量无关。稳定分支在其生命周期中从不接收新功能,并且通常仅接收一个或两个更新,用于修复严重的错误。另外,稳定版本通常 fork 自最新的 mainline 版本,它继承了过去一年中最新 mainline 分支的所有 bugfix 补丁、新增功能和其他变更。

优秀的个人博客,低调大师

Rust 1.46.0 稳定版发布

Rust 1.46.0 发布了,此版本带来了以下更新内容: 改进 const fn 现在可以在 const fn 中使用几种核心语言功能: if,if let, andmatch while,while let, andloop the&&and||operators 还可以转换为 slice: const fn foo() { let x = [1, 2, 3, 4, 5]; // cast the array to a slice let y: &[_] = &x; } 这些功能可能并不新鲜,但鉴于你可以在 const fn 之外使用所有功能,它们增加了很多编译时计算能力。例如,const-sha1crate 可以让你在编译时计算 SHA-1 哈希值。这使 Microsoft 的 Rust WinRT 绑定性能提高了 40 倍。 #[track_caller] #[track_caller] 属性最早于 2017 年提出。如果你正在编写类似 unwrap 之类可能会引发 panic 的功能,则可以将此注释放在函数上,默认的 panic 格式化程序将使用其调用方作为错误消息中的位置。例如,这是之前的unwrap: pub fn unwrap(self) -> T { match self { Some(val) => val, None => panic!("called `Option::unwrap()` on a `None` value"), } } 现在: #[track_caller] pub fn unwrap(self) -> T { match self { Some(val) => val, None => panic!("called `Option::unwrap()` on a `None` value"), } } 如果你自己实现了 panic 挂钩,也可以在 std::panic::Location 上使用调用方方法(caller method)来访问此信息。 Library changes 与 const fn 改进的主题保持一致,std::mem::forget 现在也是一个 const fn。此外,此版本还稳定了两个新的 API: Option::zip vec::Drain::as_slice 更新说明:https://blog.rust-lang.org/2020/08/27/Rust-1.46.0.html

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册