首页 文章 精选 留言 我的

精选列表

搜索[监督学习],共10000篇文章
优秀的个人博客,低调大师

NLP学习------HanLP使用实验

在之前的实验中得到了不在词向量里的词与分词结果,结果有500多个词不在词向量里,解决方案就是重新分词,或再追加训练这些词到词向量里。但后者相对麻烦且目前样本量不大。我跟据词向量的作者[6]所使用的分词工具来分词,会比不同工具(jieba)的效果要好,因为都是同一模式的分词,分出来的词应该都会存在于大型语料库中。实验证明思路是对的,最后结果是只有60几个词不在词向量里,其中大部分为名词,还有些为因语音翻译问题所造成的出错连词,所有这些词也只出现一次,这部分可以考虑最后删去也不会影响结果。改善未出现词是个关键步骤,因为此后模型会用到词向量,如果未出现词过多,会影响词向量效果。 问题:不过最后HANLP分词影响了实验判断结果,准确率从93%(jieba分词,同模型同参数)下降到90%。 实验:使用HanLP分词1 1,前期准备,(环境ubuntu,python3)安装JAVA-10[3](hanlp是JAVA开发的,即使使用python调用pyhanlp需要借助java),jpype(python中虚拟java环境),hanlp(开源中文处理工具,不只是分词还有各种工具),hanlp的root路径配置及data数据包放置[4] 2,主要程序[5] w2v_model = KeyedVectors.load_word2vec_format(w2vpath, binary=False, unicode_errors='ignore') # 加载词向量hanlppath="-Djava.class.path=/media/glados/Learning/project/NLP/hanlp/hanlp-1.6.4.jar:/media/glados/Learning/project/NLP/hanlp/"jp.startJVM(jp.getDefaultJVMPath(), hanlppath) # , "-Xms1g", "-Xmx1g") # 启动JVM, Xmx1g分配1g内存jp.JClass('com.hankcs.hanlp.HanLP$Config').ShowTermNature = False # 关闭分词属性显示HanLP = jp.JClass('com.hankcs.hanlp.HanLP') #普通分词模式words = str(HanLP.segment(sentence)) #分词将结果转为strwords = re.sub('[反斜杠[反斜杠],n]', ' ', words) # 这里注意实际程序是单,在blog里会出问题,所以用反斜杠替代words = words.split()words = del_stopword(words)...jp.shutdownJVM() # 最后关闭java虚拟环境 使用的是HANLP的普通分词功能,另外需注意,hanlp.segment()不能直接输出或赋值给python,因为其是java环境中数据,所以只有转为str()后,再进行处理,否则会报错#Afatalerror。(另外还有其他java与python数据对应问题,在这里没遇到,请参考其他) 词向量选用的是“Mixed-large综合”[6],其包括百度wiki百科、人民日报等,总共1293214个词。 Hanlp的中部份功能没法使用,例如精确分词CRF。另外,要先加载词向量再加载java虚拟环境。#AfatalerrorhasbeendetectedbytheJavaRuntimeEnvironment 3,实验结果 model num_topic limit F1 accuracy precision recall tflsi 3 0.45 0.888888889 0.902173913 0.9 0.87804878 (模型使用的是特征为tfidf的lsi模型, 参数:num_topics=3, 判断是否相似阀值为0.45,即大于0.45为true相似 ) 同模型同参数下,jieba分词结果 jieba分词未出现在词向量的约500多,有些词出现了好几次,而hanlp分词只有60几个未出现,且多数为名词,只出现过一次。 4,分析在样本中,所有样本分词结果jieba比hanlp要多分出100个词左右。所以推测因hanlp分词细粒度大,分出词少,导致较少的共现词出现(也可能是hanlp分词精度更高,分出很多虚词被停止词表过滤造成),也就是说,lsi+tfidf模型对词细粒度大、分词少的分词器不友好,所以最后hanlp出错率更大。 jieba与hanlp都是很不错的分词器,结巴使用更方便。hanlp准确度要高一些(感觉),而且与文中提到的词向量相匹配。 (我免贵姓AI,jieba:我免/贵姓/AI,hanlp:我/免/贵姓/AI,实际:我/免贵/姓AI)参考资料:[[自然语言处理 中文分词 词性标注 命名实体识别 依存句法分析 关键词提取 新词发现 短语提取 自动摘要 文本分类 拼音简繁]](https://github.com/hankcs/HanLP)文章来源于gladosAI的博客

优秀的个人博客,低调大师

SQL Serever学习15——进阶

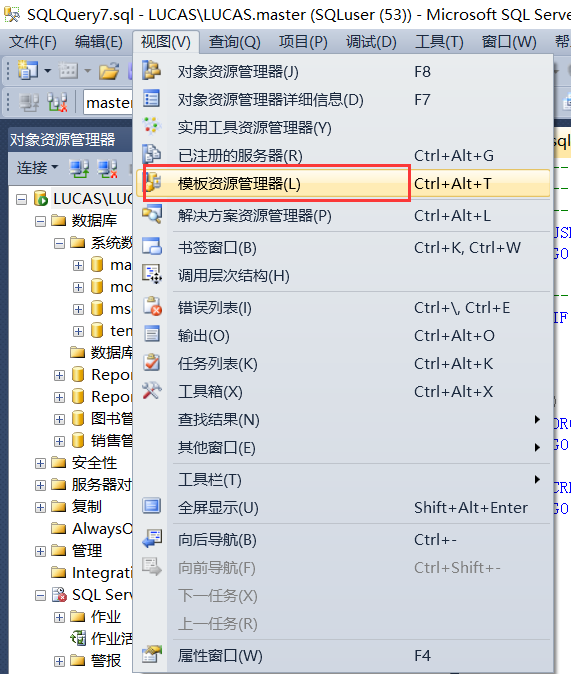
特别说明:在sqlserver2014中,不区分大小写,也就是说,SQL是大小写不敏感的 数据库模型3类: 层次模型 网状模型 关系模型 关系型数据库语言3种: DDL数据定义语言 CREATE(创建书库或数据库对象) , ALTER, DROP DML数据操作语言 SELECT(检索表或视图) , UPDATE , INSERT , DELETE DCL数据控制语言 GRANT(授予权限) , REVOKE(撤销权限) , DENY(拒绝权限,并禁止从其他角色继承许可权限) 系统数据库4个: master数据库 记录所有系统信息,例如登录账户,系统配置 model数据库 所有数据库模板,对model数据库修改将应用于以后的所有数据库 msdb数据库 tempdb数据库 模板浏览器窗口 SSMS提供了大量的包含用户提供给的遍的参数的脚本模板,使用该参数可以只输入一次名称,然后自动将改名称复制到脚本中所有必要的位置。 使用模板创建数据库 将Create Database从模板浏览器窗口,拖动到查询窗口,自动创建代码 选择查询==》指定模板参数的值, 在打开的窗口中替换掉原先的值,改为“销售管理2”,确定 然后先分析,无误后,点击执行按钮即可 查看联机帮助文档 这里的帮助文档,数据量很大 选择sqlserver2014的Developer Reference ,Installation , Microsoft SQL Server Language Reference,点击更新 操作数据库的文件(增删改) 为销售管理2增加一个日志文件 先查看数据库文件 修改数据库文件 编写执行SQL,修改数据库的文件位置,大小 ALTER DATABASE 销售管理2 MODIFY FILE ( NAME=销售管理2, FILENAME='e:/data/销售管理2.mdf', SIZE=12MB ) GO 删除数据库文件 ALTER DATABASE 销售管理2 REMOVE FILE 销售管理2_2 注意:主数据库文件和主日志文件,不可删除 sqlserver2014支持的其他数据类型 数据完整性4种: 实体完整性(行,数据不重复) 域完整性(列,满足于特定约束) 参照完整性(外键约束) 用户自定义完整性(自定义的约束,触发器) 设置强制修改数据表 sqlserver2014安装的时候,默认不能强制修改数据表结构,如要修改,设置方法如下: 工具==》选项==》设计器==》表设计器和数据库设计器==》阻止保存。。。的勾选去掉,确定 创建视图的SQL(可以使用SSMS创建) CREATE VIEW 一个视图 AS SQL语句 GO 比如: USE 销售管理 GO CREATE VIEW 一个视图 AS SELECT 买家名称 FROM 买家表 GO

优秀的个人博客,低调大师

PHP学习4——面向对象

主要内容: 创建类 成员方法 构造方法 析构方法 封装 继承 接口 多态 静态成员 常用关键字 常用魔术方法 从PHP5开始引入了面向对象的全部机制,面向对象的特性符合软件工程的3个目标:重用性,灵活性,扩展性。 创建类 类前面不用public修饰,只要class,类的属性不能在初始化赋值(除非你写了构造方法来初始化赋值),属性的使用符号->,比如$aClass->name; demo.php <?php //声明ren类,默认public,不写 class ren{ public $name; public $sex; public $age; } //实例化ren类 $xiaoli=new ren(); //设置name属性 $xiaoli->name="小李"; //获取name属性 echo $xiaoli->name; ?> 输出 =》小李 成员方法 就是类中函数,只是在原先的函数声明前面加修饰符public,即可,调用方法$aClass->func(),在函数中使用该对象的属性使用关键字$this,比如$this->name; class_func.php <?php //声明ren类,默认public,不写 class ren{ public $name; public $sex; public $age; public function say(){ echo "我叫做".$this->name."<br/>"; } } //实例化ren类 $xiaoli=new ren(); //设置name属性 $xiaoli->name="小李"; //调用方法 $xiaoli->say(); ?> 输出 我叫做小李 构造方法 在类的方法中的一个特殊的方法,默认为public(不需要写),,写法:__construct(){},注意前面是2个下划线。 可以使用构造方法进行对象的初始化赋值 每一次实例化对象(new),都会执行。 construct.php <?php //声明ren类,默认public,不写 class ren{ public $name; public $sex; public $age; //成员方法 public function say(){ echo "我叫做".$this->name."<br/>"; echo "性别:".$this->sex."<br/>"; echo "年龄:".$this->age."<br/>"; } //构造方法 function __construct($name,$sex,$age){ $this->name=$name; $this->sex=$sex; $this->age=$age; } } //实例化ren类,初始化对象赋值 $xiaoli=new ren("小李","男",25); //调用方法 $xiaoli->say(); ?> 输出 我叫做小李 性别:男 年龄:25 析构方法 和构造方法名称类似,但是不能带任何参数,写法:function __destruct(){} 在销毁一个类之前执行一些操作或完成功能,在对象被销毁时自动执行。 destruct.php <?php //声明ren类,默认public,不写 class ren{ public $name; public $sex; public $age; //成员方法 public function say(){ echo "我叫做".$this->name."<br/>"; echo "性别:".$this->sex."<br/>"; echo "年龄:".$this->age."<br/>"; } //构造方法 function __construct($name,$sex,$age){ $this->name=$name; $this->sex=$sex; $this->age=$age; } //析构方法 function __destruct(){ echo "<br/>$this->name 这个对象被销毁了。<br/>"; } } //实例化ren类,初始化对象赋值 $xiaoli=new ren("小李","男",25); //调用方法 $xiaoli->say(); //对象自动销毁,执行__destruct ?> 输出 我叫做小李 性别:男 年龄:25 小李 这个对象被销毁了。 也可以使用unset方法手动销毁对象,比如$unset($xiaoli) unset.php <?php //声明ren类,默认public,不写 class ren{ public $name; public $sex; public $age; //成员方法 public function say(){ echo "我叫做".$this->name."<br/>"; echo "性别:".$this->sex."<br/>"; echo "年龄:".$this->age."<br/>"; } //构造方法 function __construct($name,$sex,$age){ $this->name=$name; $this->sex=$sex; $this->age=$age; } //析构方法 function __destruct(){ echo "<br/>$this->name 这个对象被销毁了。<br/>"; } } //实例化ren类,初始化对象赋值 $xiaoli=new ren("小李","男",25); $xiaobai=new ren("小白","女",23); //调用方法 unset($xiaoli,$xiaobai); //对象自动销毁,执行__destruct ?> 输出 小李 这个对象被销毁了。 小白 这个对象被销毁了。 封装 面向对象的3特性:封装,继承,多态 封装是面向对象的3特性之一(3特性为:封装,继承,多态) 类封装了代码,对象则封装了数据 访问关键字:public,private,protected 继承 这也是面向对象的3特性之一 继承使用的关键字为extends 继承可以拓展原先的类的属性和方法,还可以直接使用原先的类的属性和方法,节省了一大推敲代码的时间! 不过继承的是public,protected的属性和方法,至于private乃是师傅的私家珍藏(俗称“留一手”),是不会让继承的! PHP的面向对象的设计,和Java语言的设计非常的类似,难道是copy“借鉴”了Java的吗?也许吧! jicheng.php <?php //声明tool类 class tool{ function on(){ echo "<br/>启动<br/>"; } function run(){ echo "运行<br/>"; } function off(){ echo "关闭<br/>"; } } //继承tool类 class fan extends tool{ function app(){ $this->on(); $this->run(); $this->off(); } } $fan=new fan(); $fan->app(); ?> 输出 启动 运行 关闭 接口 PHP5也是单继承的,只能extends一个类,但是可以实现(相当于继承)多个接口(接口相当于是所有方法都是抽象方法,抽象类) 接口的关键字interface,实现接口implements interface.php <?php //声明接口 interface tool{ //全都是默认的public abstract 的方法 function on(); function run(); function off(); } //实现接口 class fan implements tool{ function on(){ echo "<br/>风扇启动<br/>"; } function run(){ echo "风扇运行<br/>"; } function off(){ echo "风扇关闭<br/>"; } } ?> 多态 由于PHP是弱类型语言,并不支持完全的多态。 多态就是根据不同的对象来做出不同的反应,运行同一个方法,但是得到的却是不同的结果。 duotai.php <?php //声明接口 interface tool{ //全都是默认的public abstract 的方法 function on(); function run(); function off(); } //实现接口 class fan implements tool{ function on(){ echo "<br/>风扇启动<br/>"; } function run(){ echo "风扇运行<br/>"; } function off(){ echo "风扇关闭<br/>"; } } //实现接口 class engine implements tool{ function on(){ echo "<br/>发动机启动<br/>"; } function run(){ echo "发动机运行<br/>"; } function off(){ echo "发动机关闭<br/>"; } } //状态类 class toolStatus{ function ts($tool){ $tool->on(); $tool->run(); $tool->off(); } } //应用多态 $fan=new fan(); $engine=new engine(); $toolStatus=new toolStatus(); $toolStatus->ts($fan); $toolStatus->ts($engine); ?> 输出 风扇启动 风扇运行 风扇关闭 发动机启动 发动机运行 发动机关闭 静态成员 类中一种特殊成员,不会被实例化到对象中,所以不用实例化对象即可调用。 关键字static,比如public static $name,public static function say(){}; 在类的内部使用静态的成员使用关键字self::$name,self表示类,2个冒号是作用域限定符,$name就是静态成员。 在程序中使用静态成员,写法: static.php <?php //声明tool类 class tool{ //声明静态方法 static function on(){ echo "<br/>启动<br/>"; } function run(){ //内部调用静态方法 self::on(); echo "运行<br/>"; } function off(){ echo "关闭<br/>"; } } //外部调用静态方法,不用实例化对象 tool::on(); $fan=new tool(); $fan->run(); ?> 输出 启动 启动 运行 常用关键字 final,被final(最终的)修饰的类不能被继承,修饰的属性不能被修改,比如public final function say(){} clone,建立一个对象的副本,比如$newClass=clone $aClass;他会自动调用类的__clone(){}方法 常用的魔术方法 function __construct($name,$age){}构造方法 function __destruct(){}析构方法 function __clone(){}拷贝方法 function __set($name,$value)设置方法 function__get($name)获取方法 function__call($func,$values) function static __callStatic($func,$values)

优秀的个人博客,低调大师

PHP学习5——异常处理

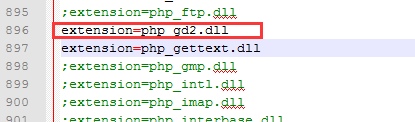
主要内容: PHP错误类型 异常的产生 错误日志 日志信息记录到操作系统日志 异常处理 扩展异常处理类 PHP错误类型 语法错误 执行时错误 逻辑错误 异常的产生 如果安装了xampp之后,在php.ini中可以设置错误报告,配置文件路径:C:\xampp\php 可以使用error_reporting(0)关闭错误提示,使用error_reporting(E_ALL)报告所有错误 在ini文件中使用;分号注释 错误日志 使用指定文件记录错误报告日志 在开发的产品投入使用后,通常会把所有的错误提示都关闭,因为这些提示会影响消费者对产品的体验,而且曝露太多信息容易被黑客攻击。 错误信息可以保存到单独的文本(日志文件)中而不要显示在浏览器中。 默认情况都是配置好的,在程序中可以使用error_log($msg)来自定义错误信息 error.php <?php echo "ssdsds"; error_log("这是一段自定义的报错日志信息"); ?> 打开文件 [06-Aug-2018 07:24:24 Europe/Berlin] 这是一段自定义的报错日志信息 [06-Aug-2018 07:24:50 Europe/Berlin] 这是一段自定义的报错日志信息 打开php.ini配置文件 报告PHP所有错误 设置PHP报错日志地址: 日志信息记录到操作系统日志 常用方法 openlog($msg,$option,$facility)打开日志连接,比如openlog("php",LOG_PID,LOG_USER) syslog($priority,$msg)生成日志消息,比如syslog(LOG_WARNING,"向syslog中发送自定义信息。。。") closelog()关闭日志连接 syslog.php <?php openlog("PHP5",LOG_PID,LOG_USER); syslog(LOG_WARNING,"向syslog发送自定义信息"); closelog(); ?> 自定的信息都被记录都爱系统日志中了,可以在计算机》管理》事件查看器》windows日志》应用程序》点击警告,即生成的信息。 异常处理 异常处理是一种可扩展、易维护的错误处理统一机制。 异常处理的实现 exception.php <?php try{ $error="这是异常的提示信息"; throw new Exception($error); echo "这里不会被执行"; }catch(Exception $e){ echo "错误信息:".$e->getMessage()."<br/>";; } echo "程序继续向下执行"; ?> 输出 错误信息:这是异常的提示信息 程序继续向下执行 异常必须手动抛出,关键字是throw,比如 ,throw new Exception();,注意,在异常被处理后,程序会继续向下执行。 扩展异常处理类 Exception类是所有异常的基类,可以通过继承来扩展它。 Exception.php <?php //异常类 class Exception{ protected $message='Unknow exception'; protected $code=0; protected $file; protected $line; //构造方法 public function __construct($message=null,$code=0,$previous=null){}; public function __toString();//可重载,用于返回可输出的字符串 final public function getMessage();//返回异常信息 final public function getCode();//返回异常代码 final public function getFile();//返回发生异常的文件名 final public function getLine();//返回发生异常的代码行号 final public function getTrace();//数组形式返回异常传递的线路 final public function getPrevious();//返回格式化异常 final public function getTraceAsString();//返回格式化字符串的getTrace信息 } ?> 现在我们定义自己的异常类 myException.php <?php //异常类 class cakeException extends Exception{ public function __toString(){ return "这个蛋糕过期了<br/>"; } } //异常类 class pearException extends Exception{ public function __toString(){ return "这个梨子烂了<br/>"; } } //异常类 class appleException extends Exception{ public function __toString(){ return "这个苹果坏了<br/>"; } } try{ throw new cakeException(); }catch(Exception $e){ echo $e; } try{ throw new appleException(); }catch(Exception $e){ echo $e; } try{ throw new pearException(); }catch(Exception $e){ echo $e; } ?> 输出 这个蛋糕过期了 这个苹果坏了 这个梨子烂了 上面都是直接抛出异常,在应用中,我们通过判断来抛出异常 demo.php <?php try{ $a=10; if(isset($b)){ echo "程序正常执行"; }else{ throw new Exception(); } }catch(Exception $e){ echo "错误代码所在路径:".$e->getFile()."<br/>"; echo "错误代码所在行号:".$e->getLine()."<br/>"; } echo "<br/>程序执行完毕<br/>"; ?> 输出 错误代码所在路径:C:\xampp\htdocs\demo.php 错误代码所在行号:8 程序执行完毕 ok,关于异常处理就到这里了。

优秀的个人博客,低调大师

PHP学习6——常用函数

主要内容: 字符串处理函数 时间和日期处理函数 字符串处理函数 echo输出字符串 print输出字符串,带返回值1 print.php <?php var_dump(print("有返回值的<br/>")); ?> 输出 有返回值的 int(1) die($status)输出字符串,并退出脚本 die.php <?php isset($a)|| die('$a未定义,程序退出!'); echo '$a已经定义,程序继续执行'; ?> 输出 $a未定义,程序退出! printf()格式化输出,占位符为序号+$,%表示格式化输出,d十进制,s字符串,f浮点数 printf.php <?php printf('输出第2个元素为:%2$s<br/>','this','is','apple'); //双引号中$前面+\ printf("输出第3个数为:%3\$d<br/>",10,5,20); ?> 输出 输出第2个元素为:is 输出第3个数为:20 其他方法 sprintf()将格式化字符串返回给一个变量 trim()从字符串2边删除预定义字符 htmlspecialchars()把一些预定义字符转换为html实体,这个方法很重要,在提交表单的时候,可以防止xss(cross-site scripting)跨站攻击 提示:跨站点脚本(Cross-site scripting,XSS)是一种计算机安全漏洞类型,常见于 Web 应用程序。 XSS 能够使攻击者向其他用户浏览的网页中输入客户端脚本。 htmlspecialchars() 函数把特殊字符转换为 HTML 实体。这意味着 < 和 > 之类的 HTML 字符会被替换为 &lt; 和 &gt; 。 这样可防止攻击者通过在表单中注入 HTML 或 JavaScript 代码(跨站点脚本攻击)对代码进行利用。 时间和日期处理函数 unix时间戳,表示格林威治时间,从1970年1月1日0时0分0秒起到现在的总秒数。 mktime.php <?php echo mktime(1,0,0,01,01,1970); ?> 输出:0 还有一个time(),不带任何参数,返回当前时间戳, time.php <?php echo time(); ?> 输出:1533537715 getdate()返回当前的时间信息,是返回一个数组,使用print_r()输出 getdate.php <?php print_r(getdate()); ?> 输出 Array ( [seconds] => 33 [minutes] => 45 [hours] => 8 [mday] => 6 [wday] => 1 [mon] => 8 [year] => 2018 [yday] => 217 [weekday] => Monday [month] => August [0] => 1533537933 ) date("Y-m-d H:i:s")日期的格式化输出 date.php <?php echo date("Y-m-d H:i:s"); ?> 输出 2018-08-06 08:49:23 date_default_timezone_set("PRC")设置默认时区 date_default_timezone_set.php <?php echo date("Y-m-d H:i:s"); echo "<br/>"; //设置为北京时间 date_default_timezone_set("PRC"); echo date("Y-m-d H:i:s"); ?> 输出 2018-08-06 08:53:33 2018-08-06 14:53:33 microtime(true)返回程序级别的操作时间 microtime.php <?php $a=microtime(true); for($i=0;$i<1000000;$i++){ $x=10; } $b=microtime(true); $c=($b-$a); echo $c." sec"; ?> 输出 0.021001100540161 sec

优秀的个人博客,低调大师

Android学习--深入探索RemoteViews

版权声明:本文为博主原创文章,转载请注明出处http://blog.csdn.net/u013132758。 https://blog.csdn.net/u013132758/article/details/81435591 什么是RemoteViews RemoteViews表示的是一个View结构,它可以在其他进程中显示,由于它在其他进程中显示,为了能够及时更新它的界面,RemoteViews提供了一组基础的操作来跨进程更新它的界面。源码中对于它的解释如下: /** * A class that describes a view hierarchy that can be displayed in * another process. The hierarchy is inflated from a layout resource * file, and this class provides some basic operations for modifying * the content of the inflated hierarchy. */ RemoteViews相信很多人跟我一样觉得这可能是一个View或是layout。真的是这样吗?其实不然上面描述中说到它是描述一个View结构,并不是一个View,下面我们来通过源码看看RemoteViews public class RemoteViews implements Parcelable, Filter { ...... } 从它的继承方式来看,它跟View和Layout并没有什么关系。下面我们来看看RemoteViews如何使用。 RemoteViews的应用场景 1、应用于通知栏 2、应用于桌面小部件 RemoteViews的使用 前面说了RemoteViews用于通知栏和桌面小部件,下面我们一个个来看RemoteViews是怎么使用的。 RemoteViews在通知栏中使用 RemoteViews在通知栏中的应用还是比较简单的,话不多说我们直接撸代码 Notification notification = new Notification(); notification.icon = R.mipmap.ic_launcher; notification.tickerText = "hello notification"; notification.when = System.currentTimeMillis(); notification.flags = Notification.FLAG_AUTO_CANCEL; Intent intent = new Intent(this, RemoteViewsActivity.class); PendingIntent pendingIntent = PendingIntent.getActivity(this, 0, intent, PendingIntent.FLAG_UPDATE_CURRENT); RemoteViews remoteViews = new RemoteViews(getPackageName(), R.layout.layout_notification);//RemoveViews所加载的布局文件 remoteViews.setTextViewText(R.id.tv, "RemoteViews应用于通知栏");//设置文本内容 remoteViews.setTextColor(R.id.tv, Color.parseColor("#abcdef"));//设置文本颜色 remoteViews.setImageViewResource(R.id.iv, R.mipmap.ic_launcher);//设置图片 PendingIntent openActivity2Pending = PendingIntent.getActivity (this, 0, new Intent(this, MainActivity.class), PendingIntent.FLAG_UPDATE_CURRENT);//设置RemoveViews点击后启动界面 remoteViews.setOnClickPendingIntent(R.id.tv, openActivity2Pending); notification.contentView = remoteViews; notification.contentIntent = pendingIntent; NotificationManager manager = (NotificationManager) getSystemService(Context.NOTIFICATION_SERVICE); manager.notify(2, notification); RemoteViews在桌面小部件中的应用 桌面小部件是通过AppWidgetProVider来实现的,而AppWidgetProVider继承自BroadcastReceiver,所以可以说AppWidgetProVider是个广播。 1、定义小部件的界面 首先,我们需要在xml文件中定义好桌面小部件的界面。 <?xml version="1.0" encoding="utf-8"?> <LinearLayout xmlns:android="http://schemas.android.com/apk/res/android" android:layout_width="match_parent" android:layout_height="match_parent" android:orientation="vertical"> <ImageView android:id="@+id/iv" android:layout_width="360dp" android:layout_height="360dp" android:layout_gravity="center" /> </LinearLayout> 2、定义小部件的配置信息 在res/xml/下新建一个xml文件,用来描述桌面部件的配置信息。 <?xml version="1.0" encoding="utf-8"?> <appwidget-provider xmlns:android="http://schemas.android.com/apk/res/android" android:initialLayout="@layout/widget" android:minHeight="360dp" android:minWidth="360dp" android:updatePeriodMillis="864000"/> 3、定义小部件的实现类 这个类需要继承AppWidgetProVider,我们这里实现一个简单的widget,点击它后,3张图片随机切换显示。 public class ImgAppWidgetProvider extends AppWidgetProvider { public static final String TAG = "ImgAppWidgetProvider"; public static final String CLICK_ACTION = "packagename.action.click"; private static int index; @Override public void onReceive(Context context, Intent intent) { super.onReceive(context, intent); if (intent.getAction().equals(CLICK_ACTION)) { RemoteViews remoteViews = new RemoteViews(context.getPackageName(), R.layout.widget); AppWidgetManager appWidgetManager = AppWidgetManager.getInstance(context); updateView(context, remoteViews, appWidgetManager); } } @Override public void onUpdate(Context context, AppWidgetManager appWidgetManager, int[] appWidgetIds) { super.onUpdate(context, appWidgetManager, appWidgetIds); RemoteViews remoteViews = new RemoteViews(context.getPackageName(), R.layout.widget); updateView(context, remoteViews, appWidgetManager); } // 由于onReceive 和 onUpdate中部分代码相同 则抽成一个公用方法 public void updateView(Context context, RemoteViews remoteViews, AppWidgetManager appWidgetManager) { index = (int) (Math.random() * 3); if (index == 1) { remoteViews.setImageViewResource(R.id.iv, R.mipmap.haimei1); } else if (index == 2) { remoteViews.setImageViewResource(R.id.iv, R.mipmap.haimei2); } else { remoteViews.setImageViewResource(R.id.iv, R.mipmap.haimei3); } Intent clickIntent = new Intent(); clickIntent.setAction(CLICK_ACTION); PendingIntent pendingIntent = PendingIntent.getBroadcast(context, 0, clickIntent, 0); remoteViews.setOnClickPendingIntent(R.id.iv, pendingIntent); appWidgetManager.updateAppWidget(new ComponentName(context, ImgAppWidgetProvider.class), remoteViews); } } 4、在AndroidManifest.xml中声明小部件 因为桌面小部件的本质是一个广播组件,因此必须要注册。 <receiver android:name=".RemoveViews_5.ImgAppWidgetProvider"> <meta-data android:name="android.appwidget.provider" android:resource="@xml/appwidget_provider_info"> </meta-data> <intent-filter> <action android:name="packagename.action.click" /> <action android:name="android.appwidget.action.APPWIDGET_UPDATE" /> </intent-filter> </receiver> 代码中有两个action,第一个是小部件的点击事件,第二个是小部件的标识必须存在的,如果不加它就不是一个小部件也不会显示在手机桌面。 小部件的生命周期 onEnable:当小部件第一次添加到桌面的时候调用,小部件可以添加多次,但是只在第一次添加的时候调用。 onUpdate:小部件被添加时或小部件每次更新时都会调用这个方法。每个周期小部件都会自动更新一次,不是点击的时候更新,而是到指定配置文件时间的时候才更新。 onDelete:每删除一次小部件就调用一次。 onDisable:当最后一个该类型的小部件删除时调用该方法。 onRceive:这是广播的内置方法,用于分发具体的事件给其他方法,所以该方法一半要调用super.onReceive(context,intent)。如果自定义了其他action的广播,就可以在调用了父类方法之后进行判断。 PendingIntent介绍 PendingIntent表示一种处于Pending状态的意图,而pending状态就是表示接下来有一个Intent(即意图)将在某个待定的时刻发生。它和Intent的区别就在于,Intent是立刻、马上发生,而PendingInten是将来某个不确定的时刻发生。 PendingIntent的主要方法 PendingIntent支持三种待定意图:启动Activity,启动Service和发送广播,分别对应着它的三个接口方法: getActivity(Context xontext,int requestCode,Intent intent,int flag): 获得一个PendingIntent,该待定意图发生时,效果相当于Context.startActivity(intent) getService(Context xontext,int requestCode,Intent intent,int flag): 获得一个PendingIntent,该待定意图发生时,效果相当于Context.startService(intent) getBroadcast(Context xontext,int requestCode,Intent intent,int flag): 获得一个PendingIntent,该待定意图发生时,效果相当于Context.sendBroadcast(intent) 这里有四个参数,第一个和第三个比较好理解,第二个表示的是PendingIntent发送方的请求码,大多数情况为0,第四个参数flag常见的类型有四种。 PendingIntent的flag参数 FLAG_ONE_SHOT: 当前描述的PendingIntent只能被使用一次,之后被自动cancle,如果后续还有相同的PendingIntent,那么他们的send方法会调用失败。 FLAG_NO_CREATE: 当前描述的PendingIntent不会主动创建,如果当前PendingIntent之前不存在,那么getActivity,getService,getBroadcast方法会直接返回null。 FLAG_CANCLE_CURRENT: 当前的PendingIntent如果已经存在,那么它们都会被cancle,然后系统会创建一个新的PendingIntent。对于通知栏来说那些被calcle的消息单机后将无法打开。 FLAG_UPDATE_CURRENT: 当前的PendingIntent如果已经存在,那么它们都会被更新,即它们的Intent中的Extras会被替换为最新的。 通知栏而言,notify(int, notification)方法中,若id值每次都不同的话,需要考虑到flag参数对应消息接收的情况。 RemoteViews的内部机制 RemoteViews没有findViewById方法,因此无法访问里面的View元素,而必须通过RemoteViews提供的一系列set方法来完成,这是通过反射调用的。 通知栏和小部件分别由NotificationManager和AppWidgetManger管理,而NotificationManager和AppWidgetManger通过Binder分别和SystemService进程中的NotificationManagerService和AppWidgetMangerService中加载的,而它们运行在SystemService中,这就构成了跨进程通信。 构造方法 public RemoteViews(String packageName, int layoutId)第一个参数是包名,第二个参数是待加载的布局文件。 支持组件 布局:FrameLayout、LinearLayout、RelativeLayout、GridLayout。 组件:Button、ImageButton、ImageView、ProgressBar、TextView、ListView、GridView、ViewStub等(例如EditText是不允许在RemoveViews中使用的,使用会抛异常)。 工作原理 系统将View操作封装成Action对象,Action同样实现了Parcelable接口,通过Binder传递到SystemServer进程。远程进程通过RemoteViews的apply方法来进行view的更新操作,RemoteViews的apply方法内部则会去遍历所有的action对象并调用它们的apply方法来进行view的更新操作。 这样做的好处是不需要定义大量的Binder接口,其次批量执行RemoteViews中的更新操作提高了程序性能。 工作流程 首先RemoteViews会通过Binder传递到SystemService进程,因为RemoteViews实现了Parcelable接口,因此它可以跨进程传输,系统会根据RemoteViews的包名等信息拿到该应用的资源;然后通过LayoutInflater去加载RemoteViews中的布局文件。接着系统会对View进行一系列界面更新任务,这些任务就是之前我们通过set来提交的。set方法对View的更新并不会立即执行,会记录下来,等到RemoteViews被加载以后才会执行。这样RemoteViews就可以在SystemService进程中显示了。 这里需要注意一个小知识点就是apply和reApply方法的区别,apply会加载布局并且更新界面,而reApply只会更新界面。 源码分析 我们下面基于android8.0的源码看看RemoteViews,set方法之后的逻辑是怎么样的,以setTextViewText为例: public void setTextViewText(int viewId, CharSequence text) { setCharSequence(viewId, "setText", text); } 继续深入查看 public void setCharSequence(int viewId, String methodName, CharSequence value) { addAction(new ReflectionAction(viewId, methodName, ReflectionAction.CHAR_SEQUENCE, value)); } 我们发现这里没有对View直接操作,而是添加了一个REflectionAction对象,进一步查看: private void addAction(Action a) { if (hasLandscapeAndPortraitLayouts()) { throw new RuntimeException("RemoteViews specifying separate landscape and portrait" + " layouts cannot be modified. Instead, fully configure the landscape and" + " portrait layouts individually before constructing the combined layout."); } if (mActions == null) { mActions = new ArrayList<Action>(); } mActions.add(a); // update the memory usage stats a.updateMemoryUsageEstimate(mMemoryUsageCounter); } 这里仅仅把action加入了list。下面我们通过NotificationManager的notify方法来看看。 public void notify(String tag, int id, Notification notification) { notifyAsUser(tag, id, notification, new UserHandle(UserHandle.myUserId())); } 进一步查看 public void notifyAsUser(String tag, int id, Notification notification, UserHandle user) { INotificationManager service = getService(); String pkg = mContext.getPackageName(); // Fix the notification as best we can. Notification.addFieldsFromContext(mContext, notification); if (notification.sound != null) { notification.sound = notification.sound.getCanonicalUri(); if (StrictMode.vmFileUriExposureEnabled()) { notification.sound.checkFileUriExposed("Notification.sound"); } } fixLegacySmallIcon(notification, pkg); if (mContext.getApplicationInfo().targetSdkVersion > Build.VERSION_CODES.LOLLIPOP_MR1) { if (notification.getSmallIcon() == null) { throw new IllegalArgumentException("Invalid notification (no valid small icon): " + notification); } } if (localLOGV) Log.v(TAG, pkg + ": notify(" + id + ", " + notification + ")"); final Notification copy = Builder.maybeCloneStrippedForDelivery(notification); try { service.enqueueNotificationWithTag(pkg, mContext.getOpPackageName(), tag, id, copy, user.getIdentifier()); } catch (RemoteException e) { throw e.rethrowFromSystemServer(); } } 我们注意到这里最终调用了INotificationManager的enqueueNotificationWithTag方法,这里INotificationManager是aidl,通过Binder通信,真正实现它的Java类是NotificationManagerService,下面继续跟进这个方法: @Override public void enqueueNotificationWithTag(String pkg, String opPkg, String tag, int id, Notification notification, int userId) throws RemoteException { enqueueNotificationInternal(pkg, opPkg, Binder.getCallingUid(), Binder.getCallingPid(), tag, id, notification, userId); } 进一步查看enqueueNotificationInternal的源码,这个方法代码有点多,我们只看重要部分。 void enqueueNotificationInternal(final String pkg, final String opPkg, final int callingUid, final int callingPid, final String tag, final int id, final Notification notification, int incomingUserId) { if (DBG) { Slog.v(TAG, "enqueueNotificationInternal: pkg=" + pkg + " id=" + id + " notification=" + notification); } checkCallerIsSystemOrSameApp(pkg); final int userId = ActivityManager.handleIncomingUser(callingPid, callingUid, incomingUserId, true, false, "enqueueNotification", pkg); final UserHandle user = new UserHandle(userId); ...... 省略部分代码 ...... mHandler.post(new EnqueueNotificationRunnable(userId, r)); } 这里我们看到通过Handler来post了一个Runable对象,暂且先不管这个Runable干啥的我们往下看它的run方法: protected class EnqueueNotificationRunnable implements Runnable { private final NotificationRecord r; private final int userId; EnqueueNotificationRunnable(int userId, NotificationRecord r) { this.userId = userId; this.r = r; }; @Override public void run() { synchronized (mNotificationLock) { mEnqueuedNotifications.add(r); scheduleTimeoutLocked(r); ...... 省略部分代码 ...... } else { mHandler.post(new PostNotificationRunnable(r.getKey())); } } } } 我们看到这里它又post了一个PostNotificationRunnable对象,这又是什么鬼,我们接着往下看: protected class PostNotificationRunnable implements Runnable { private final String key; PostNotificationRunnable(String key) { this.key = key; } @Override public void run() { synchronized (mNotificationLock) { try { ...... 省略部分代码 ...... // ATTENTION: in a future release we will bail out here // so that we do not play sounds, show lights, etc. for invalid // notifications Slog.e(TAG, "WARNING: In a future release this will crash the app: " + n.getPackageName()); } buzzBeepBlinkLocked(r); } finally { int N = mEnqueuedNotifications.size(); for (int i = 0; i < N; i++) { final NotificationRecord enqueued = mEnqueuedNotifications.get(i); if (Objects.equals(key, enqueued.getKey())) { mEnqueuedNotifications.remove(i); break; } } } } } } 我们看到它最终调用了buzzBeepBlinkLocked方法,我们进一步查看它的源码: @VisibleForTesting @GuardedBy("mNotificationLock") void buzzBeepBlinkLocked(NotificationRecord record) { ...... // Should this notification make noise, vibe, or use the LED? ...... // If we're not supposed to beep, vibrate, etc. then don't. ...... // Remember if this notification already owns the notification channels. ...... if (disableEffects == null && canInterrupt && mSystemReady && mAudioManager != null) { if (DBG) Slog.v(TAG, "Interrupting!"); Uri soundUri = record.getSound(); hasValidSound = soundUri != null && !Uri.EMPTY.equals(soundUri); long[] vibration = record.getVibration(); // Demote sound to vibration if vibration missing & phone in vibration mode. ...... // If a notification is updated to remove the actively playing sound or vibrate, // cancel that feedback now if (wasBeep && !hasValidSound) { clearSoundLocked(); } if (wasBuzz && !hasValidVibrate) { clearVibrateLocked(); } // light // release the light ...... if (buzz || beep || blink) { MetricsLogger.action(record.getLogMaker() .setCategory(MetricsEvent.NOTIFICATION_ALERT) .setType(MetricsEvent.TYPE_OPEN) .setSubtype((buzz ? 1 : 0) | (beep ? 2 : 0) | (blink ? 4 : 0))); EventLogTags.writeNotificationAlert(key, buzz ? 1 : 0, beep ? 1 : 0, blink ? 1 : 0); } } 这个方法很长,但是职责相对来说比较明确,确认是否需要声音,震动和闪光,如果需要,那么就发出声音,震动和闪光。最后将mBuzzBeepBlinked post到工作handler,最后会调用到mStatusBar.buzzBeepBlinked(),mStatusBar是StatusBarManagerInternal对象,这个对象是在StatusBarManagerService中初始化,所以最后调用到了StatusBarManagerService中StatusBarManagerInternal的buzzBeepBlinked()方法: public void buzzBeepBlinked() { if (mBar != null) { try { mBar.buzzBeepBlinked(); } catch (RemoteException ex) { } } } mBar是一个IStatusBar对象。关于更进一步的分析看这里源码分析Notification的Notify。我们最终发现是调用到了CommandQueue中,接着sendEmptyMessage给了内部的H类,接着调用了mCallbacks.buzzBeepBlinked()方法,这个mCallbacks就是BaseStatusBar,最终会将notification绘制出来,到这里一个notification就算是完成了。 RemoteViews的意义 RemoteViews最大的意义应该还是在于它可以跨进程更新UI。 1、当一个应用需要更新另一个应用的某个界面,我们可以选择用AIDL来实现,但如果更新比较频繁,效率会有问题,同时AIDL接口就可能变得很复杂。如果采用RemoteViews就没有这个问题,但RemoteViews仅支持一些常用的View,如果界面的View都是RemoteViews所支持的,那么就可以考虑采用RemoteViews。 2、利用RemoteViews加载其他App的布局文件与资源。 感谢 《Android开发艺术探索》 源码分析Notification的Notify android 特殊用户通知用法汇总–Notification源码分析

优秀的个人博客,低调大师

PHP学习2——基本语法

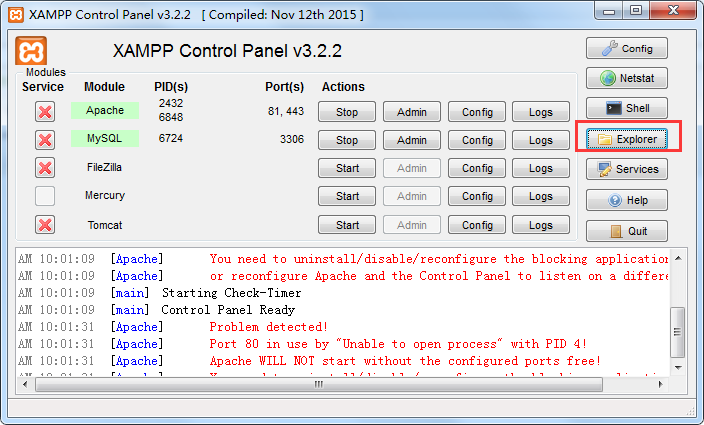
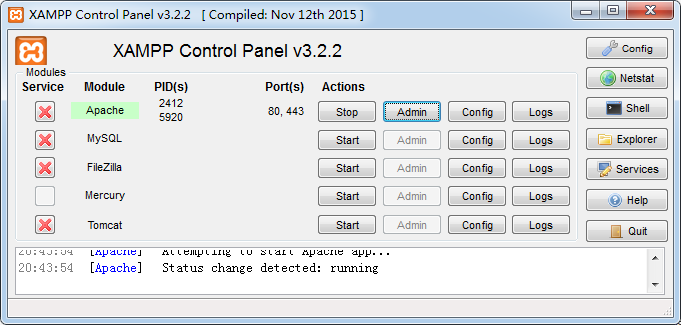
主要内容: 二进制 数据类型 变量 常量 赋值 语句结构 函数 网站的核心功能是展现信息,文字,图片,视频,音频,对于计算机来说都是数据,这些数据按照二进制进行存储。 二进制 就是1100,0100,1010这样的数据就是二进制数,二进制数分为有符号数、无符号数。原码,反码,补码是有符号数才有的表示方法。 对于正数:原码=反码=补码 原码:0100,0100,1010 反码:0100,0100,1010 补码:0100,0100,1010 对于负数:原码!=反码,反码+1=补码 原码:1100,0100,1010 反码:1011,1011,0101 补码:1011,1011,0110 数据类型 整数(10112),浮点数(12.34),字符串("cat"/‘cat’) 变量 使用$符号申明变量,以英文字母或者_(下划线)开头,后面可是是英文字母,数字,下划线,比如$score,$mark,$name,$Password php预定义变量: $GLOBALS(当前程序中全局变量) $SERVER(全局变量,包含头信息,脚本位置的数组) $_COOKIE(通过http的cookie方法提交到脚本的变量) $_SERVER常见的$_SERVER的元素包括: PHP_SELF(当前正在执行的脚本的文件名) SERVER_ADD(当前执行脚本所在服务器ip) DOCUMENT_ROOT(当前脚本所在文档根目录) SCRIPT_FILENAME(当前执行脚本绝对路径) demo2.php <?php $a="this is test!"; echo "通过\$GLOBALS来获取变量值:"; echo $GLOBALS['a']."<br/>"; echo "当前执行脚本的文件名:"; echo $_SERVER['PHP_SELF']."<br/>"; echo "当前执行脚本的跟目录:"; echo $_SERVER['DOCUMENT_ROOT']."<br/>"; echo "当前执行脚本的绝对路径:"; echo $_SERVER['SCRIPT_FILENAME']."<br/>"; ?> 启动xampp的控制面板,运行Apache,绿色说明是正常运行 将文件拷贝的xampp的htdocs下 打开浏览器输入:http://localhost/demo2.php 常量 const name=value; 比如:const MONEY_RATE=0.5; 常用预定义常量 __FILE__(放回当前文件名称,注意下划线是两个) __LINE__(返回当前代码所在行号,注意下划线是两个) __FUNCTION__(返回所在函数的名称,注意下划线是两个) __CLASS__(返回所在的类名,注意下划线是两个) PHP_OS(返回操作系统名称) TRUE(布尔值,真) FALSE(布尔值,假) NULL(空值) demo3.php <?php echo "当前文件所在位置:".__FILE__."<br/>"; echo "当前操作系统是:".PHP_OS; ?> 赋值 赋值最基本的运算 demo4.php <?php $a="this is test!";//申明变量,并赋值 $b; $b='this is test!';//先申明变量,后赋值 $c=$a;//使用一个变量给另一个变量赋值 ECHO $a."<br/>"; echo $b."<br/>"; echo $c."<br/>"; ?> 输出: 字符串单引号和双引号 单引号的变量做字符串处理,双引号变量会解析出来 demo5.php <?php $a="this is test!"; $b=10; echo '$a'.'<br/>'.'$b'."<br/>"; echo "$a".'<br/>'."$b"."<br/>"; ?> 输出 语句结构 PHP语句通常是表达式组成,语句;(英文分号)结尾,不加会报错。 条件构成 关系运算:>(大于),<(小于),==(等于),===(全等于,包括类型),<>或!=(不等于),!==(非全等于,左右操作数数值或者类型不相等,返回真) 逻辑运算 and/&&/&(逻辑与true&true==>true) or/||/|(逻辑或false||false==>false) not/!(逻辑非!true==>false) xor/^(逻辑异或,true^false==>true ,false^true==>true,false^false==>false) 逻辑与(&&)的短路原则: exp1&&exp2,如果exp1为false,则exp2不执行,直接返回false 分支结构 if语句 if-else语句 if-elseif-else语句 switch语句 demo6.php <?php $a=5; $b=10; if($a>$b){ echo '$a大于$b'; }else{ echo '$a小于$b'; } ?> 输出$a小于$b 循环结构 while语句 do-while语句 for语句 demo7.php <?php //for循环 for($i=0;$i<10;$i++){ echo 'good! '; } ?> 输出good! good! good! good! good! good! good! good! good! good! 函数 PHP的函数很好用,不用申明返回数据的类型(当然这是优点也是缺点,不过我认为还是优点,减少了代码量啊,有没有!而且还不用想破头到底应该返回什么类型数据,而且PHP的输出支持链式调用,太方便了啊!) 函数把一个完整的功能多条语句封装成一个模块,函数使用function来申明 demo8.php <?php //输出n次变量a function printString($a,$n){ //for循环 for($i=0;$i<$n;$i++){ echo "$a"; } } //调用函数 printString("good! ",5); printString("<br/>",2); printString("apple and pear! ",1); ?> 输出 这个时候的函数参数为值传递,就是一个copy,在函数内部改变这个值不会影响到外部的变量的值,但是如果我们想要在函数内部改变外部的值,需要引用传递,将参数的引用路径地址&a传入 demo.9.php <?php //交换$a,$b位置 function swap(&$a,&$b){ echo "交换前:".'$a='.$a.'$b='.$b; echo '<br/>'; $temp=$a; $a=$b; $b=$temp; echo "交换后:".'$a='.$a.'$b='.$b; } $a=5; $b=9; //调用 swap($a,$b) ?> 输出 交换前:$a=5$b=9 交换后:$a=9$b=5 全局变量 函数中不能直接使用全局变量,如果需要在函数中使用申明的全局变量,需要加前缀global <?php $a=100; //输出全局变量a function gbl(){ global $a; echo $a; } //调用 gbl(); ?> 输出 100 静态变量 函数外不能直接使用函数内部的变量,如果需要在函数外使用申明的函数中的变量,函数中变量需要加前缀static <?php //输出静态变量a function stc(){ static $a=0; $a++; echo $a.','; } //调用 stc(); stc(); stc(); stc(); stc(); ?> 输出 1,2,3,4,5, 返回值 PHP的函数不用声明返回值类型,真方便! <?php //返回字符型 function reutrnString(){ return "today is sunday."; } //返回数字 function returnNum(){ return 1024; } //调用 $a=reutrnString(); echo "\$a=$a"."<br/>"; $a=returnNum(); echo "\$a=$a"; ?> 输出 $a=today is sunday. $a=1024 函数引用返回 需要在申明函数的时候,在函数前面在&(取地址符号) (这个有点变态,直接操作引用地址,用起来出错了怎么搞) <?php //返回数字 function &returnNum(){ static $b=0; $b=$b+1; echo $b.'<br/>'; return $b; } //调用 $a=returnNum(); //使用& $a=&returnNum(); $a=1000; $a=returnNum(); ?> 输出 1 2 1001 可变函数 需要在调用函数的时候在前面加$(申明变量符号),调用同一个函数,但是却执行的是不一样的代码, 这个技术太牛逼!要是可以在配置文件中对变量进行修改,那么就可以动态的决定要执行那个函数,根据需求动态的修改程序,牛!!! (这个更加变态,不说了,看代码) <?php //返回字符型 function reutrnString(){ echo "today is sunday.<br/>"; } //返回数字 function returnNum(){ echo 1024; } function hello(){ echo '你好'; } //调用 $func='reutrnString'; $func(); $func='returnNum'; $func(); $func='hello'; $func(); ?> 输出 today is sunday. 1024你好 递归函数 就是函数自己调用自己,没有什么好说的,在一些算法中为了简化可能会用到,但是递归调用的代码执行效率极低,不建议使用 <?php //递归 function add(){ static $a=0; $a++; echo '$a='.$a.","; if($a>10){ return; } //调用自己,直到满足条件 add(); } add(); ?> 输出 $a=1,$a=2,$a=3,$a=4,$a=5,$a=6,$a=7,$a=8,$a=9,$a=10,$a=11, 系统函数 就是PHP将一些常用的函数封装好了,不用自己写了,看看API直接使用就行了。 <?php //返回最大值 $a=max(1,22,34,777,3,55); echo "1,22,34,777,3,55中最大的数是:".$a; ?> 输出 1,22,34,777,3,55中最大的数是:777

优秀的个人博客,低调大师

PHP学习1——快速入门

主要内容: 搭建PHP开发环境 第一个helloworld程序 PHP(Hypertext Preprocessor)PHP超文本预处理程序,是一种嵌入HTML的脚本语言,运行在服务器。 搭建PHP开发环境 PHP开发环境主要3部分:服务器Apache,编程语言PHP,数据库MySQL。搭建开发环境,直接使用XAMPP集成安装就可以。 XAMPP=Apache+MySQL+PHP+Perl,X表示的是跨平台。 官网下载安装即可:https://www.apachefriends.org/zh_cn/index.html (安装太简单了,没有什么可说的,不过如果以前安装过tomcat,apache,MySQL等,xampp的部分功能可能不能使用,解决办法网上很多,不再赘言) 第一个helloworld程序 php可以使用note++进行编辑。 helloworld.php <?php echo "hello world!"; ?> 然后运行XAMPP的控制面板,点击Apache的start,绿色就是正常运行了。 然后将helloworld.php文件放在路径:C:\xampp\htdocs 浏览器输入:http://localhost/helloworld.php ok,我们的第一个PHP程序就完成了。

优秀的个人博客,低调大师

概念化学习Django

Django的由来 Django是一个开放源代码的Web应用框架,由Python写成。采用了MVC的软件设计模式,即模型M,视图V和控制器C。它最初是被开发来用于管理劳伦斯出版集团旗下的一些以新闻内容为主的网站的。并于2005年7月在BSD许可证下发布。这套框架是以比利时的吉普赛爵士吉他手Django Reinhardt来命名的。 Django的主要目标是使得开发复杂的、数据库驱动的网站变得简单。Django注重组件的重用性和“可插拔性”,敏捷开发和DRY法则(Don't Repeat Yourself)。在Django中Python被普遍使用,甚至包括配置文件和数据模型。 -----维基百科 Django的MTV开发模式: Django是一个基于MVC构造的框架;但是在Django中,控制器接受用户输入的部分由框架自行处理,所以 Dj

优秀的个人博客,低调大师

(一)Java并发学习笔记

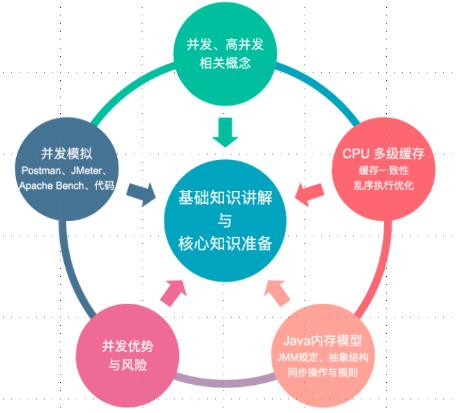
一、课程导学 二、基本概念 并发:同时拥有两个或者多个线程,如果程序在单核处理器上运行,多个线程将交替地换入或者换出内存,这些线程是同时“存在”的,每个线程都处于执行过程中的某个状态,高速切换感觉同时执行。如果运行多核处理器上,此时,程序中的每个线程将分配到一个处理器核上,因此可以真正的同时运行。 高并发:高并发(High Cuncurrency)是互联网分布式系统架构设计中必须考虑的因素之一,它通常是指,通过设计保证系统能够 同时并发处理 很多请求。 其实当我们讨论并发时主要关注的是以下几点: 多线程操作相同的资源 保证线程安全 合理分配和使用资源 而在讨论高并发是关注的是以下几点: 服务器能同时处理很多个请求 提高程序性能 比如在12306抢票,淘宝双11等都需要考虑高并发 三、并发编程基础 在单核时代处理器做出的乱序优化不会导致执行结果远离预期目标,但在多核环境下却并非如此。在多核时代,由多核cpu同时执行指令,同时还引入的l1、l2等缓存机制,每个核都有自己的缓存,就导致了逻辑顺序上后写入的数据未必真的最后写入。如果我们不做任何防护措施,就会出现处理器得出的结果和我们逻辑得出的结果大不相同。 比如:我们在一个cpu核心上执行写入操作,并在最后写入一个标记来表示该操作已经写入好了。然后从另外一个核上通过判断这个标记来确定所需要的数据是否已经就绪,这种做法就存在一定风险:标记位先被写入但数据操作并未完成。导致另外一个核使用了错误数据。 四、Java内存模型(Java Memory Model,JMM) 内存模型可以理解为在特定的操作协议下,对特定的内存或者高速缓存进行读写访问的过程抽象,不同架构下的物理机拥有不一样的内存模型,Java虚拟机也有自己的内存模型,即Java内存模型(Java Memory Model, JMM)。 在C/C++语言中直接使用物理硬件和操作系统内存模型,导致不同平台下并发访问出错。而JMM的出现,能够屏蔽掉各种硬件和操作系统的内存访问差异,实现平台一致性,是的Java程序能够“一次编写,到处运行”。 堆内存(Heap): 存放实例域, 静态域, 数组元素. 在线程间共享. 栈内存(Stack): 存放局部变量, 方法定义参数和异常处理器参数. 线程A和线程B要进行通信,必须先将数据刷新到主内存,线程B再从主内存读取线程A更新过的变量。 模拟场景: 比如多个线程同时修改一个变量:线程A 先从主内存中获取共享变量(a=2),然后在自己本地内存中计算(a+2),然后写入到主内存。 但此时B也从主内存获取(a=2),在本地内存改变(a+2).写入到主内存。 在计算过程中两个线程间的数据是不可见的,此时就会出现结果不正确情况。 Java内存模型-同步操作与规则 由上面的交互关系可知,关于主内存与工作内存之间的具体交互协议,即一个变量如何从主内存拷贝到工作内存、如何从工作内存同步到主内存之间的实现细节,Java内存模型定义了以下八种操作来完成: lock(锁定):作用于主内存的变量,把一个变量标识为一条线程独占状态。 unlock(解锁):作用于主内存变量,把一个处于锁定状态的变量释放出来,释放后的变量才可以被其他线程锁定。 read(读取):作用于主内存变量,把一个变量值从主内存传输到线程的工作内存中,以便随后的load动作使用 load(载入):作用于工作内存的变量,它把read操作从主内存中得到的变量值放入工作内存的变量副本中。 use(使用):作用于工作内存的变量,把工作内存中的一个变量值传递给执行引擎,每当虚拟机遇到一个需要使用变量的值的字节码指令时将会执行这个操作。 assign(赋值):作用于工作内存的变量,它把一个从执行引擎接收到的值赋值给工作内存的变量,每当虚拟机遇到一个给变量赋值的字节码指令时执行这个操作。 store(存储):作用于工作内存的变量,把工作内存中的一个变量的值传送到主内存中,以便随后的write的操作。 write(写入):作用于主内存的变量,它把store操作从工作内存中一个变量的值传送到主内存的变量中。 Java内存模型还规定了在执行上述八种基本操作时,必须满足如下规则: 不允许read和load、store和write操作之一单独出现 不允许一个线程丢弃它的最近assign的操作,即变量在工作内存中改变了之后必须同步到主内存中。 不允许一个线程无原因地(没有发生过任何assign操作)把数据从工作内存同步回主内存中。 一个新的变量只能在主内存中诞生,不允许在工作内存中直接使用一个未被初始化(load或assign)的变量。即就是对一个变量实施use和store操作之前,必须先执行过了assign和load操作。 一个变量在同一时刻只允许一条线程对其进行lock操作,lock和unlock必须成对出现 如果对一个变量执行lock操作,将会清空工作内存中此变量的值,在执行引擎使用这个变量前需要重新执行load或assign操作初始化变量的值 如果一个变量事先没有被lock操作锁定,则不允许对它执行unlock操作;也不允许去unlock一个被其他线程锁定的变量。 对一个变量执行unlock操作之前,必须先把此变量同步到主内存中(执行store和write操作)。 这8种内存访问操作很繁琐,后文会使用一个等效判断原则,即先行发生(happens-before)原则来确定一个内存访问在并发环境下是否安全。 五、并发的优势和风险 六、线程安全性 线程安全性主要体现在三个方面: 1. 原子性: 原子是世界上的最小单位,具有不可分割性。比如 a=0;(a非long和double类型)这个操作是不可分割的,那么我们说这个操作时原子操作。再比如:a++;这个操作实际是a = a + 1;是可分割的,所以他不是一个原子操作。非原子操作都会存在线程安全问题,需要我们使用同步技术(sychronized)来让它变成一个原子操作。一个操作是原子操作,那么我们称它具有原子性。java的concurrent包下提供了一些原子类,我们可以通过阅读API来了解这些原子类的用法。比如:AtomicInteger、AtomicLong、AtomicReference等。 Atomicxxx底层工作原理: 借助于Unsafe.compareAndSwapInt: CAS实现, 每次执行计算之前都会拿当前工作内存中的值和主内存的值比较,如果不相同就会从新从主内存中获取最新值赋值给当前对象,直到相同执行对应操作。 sun.misc.Unsafe源码: public final int getAndAddInt(Object var1, long var2, int var4) { int var5; do { var5 = this.getIntVolatile(var1, var2); } while(!this.compareAndSwapInt(var1, var2, var5, var5 + var4)); return var5; } AtomicLong和AtomicAddr AtomicLong的原理是依靠底层的cas来保障原子性的更新数据,在要添加或者减少的时候,会使用死循环不断地cas到特定的值,从而达到更新数据的目的。在竞争不激烈时修改成功的概率很高,否则修改失败的概率就很高,在大量修改失败的情况下,这些原子操作就会进行大量的失败重尝试,性能就会受到影响。 总结: LongAdder在AtomicLong的基础上将单点的更新压力分散到各个节点,在低并发的时候通过对base的直接更新可以很好的保障和AtomicLong的性能基本保持一致,而在高并发的时候通过分散提高了性能。 缺点是LongAdder在统计的时候如果有并发更新,可能导致统计的数据有误差。 实际使用中在处理高并发计数时,推荐使用LongAddr,但如果遇到类似于序列号生成这种需要全局唯一的数据情况就需要使用AtomicLong. AtomicReference AtomicReference和AtomicInteger非常类似,不同之处就在于AtomicInteger是对整数的封装,而AtomicReference则对应普通的对象引用。也就是它可以保证你在修改对象引用时的线程安全性。在介绍AtomicReference的同时,我希望同时提出一个有关原子操作的逻辑上的不足。 之前我们说过,线程判断被修改对象是否可以正确写入的条件是对象的当前值和期望是否一致。这个逻辑从一般意义上来说是正确的。但有可能出现一个小小的例外,就是当你获得对象当前数据后,在准备修改为新值前,对象的值被其他线程连续修改了2次,而经过这2次修改后,对象的值又恢复为旧值。这样,当前线程就无法正确判断这个对象究竟是否被修改过。如图4.2所示,显示了这种情况。(ABA问题) 图4.2 对象值被反复修改回原数据 一般来说,发生这种情况的概率很小。而且即使发生了,可能也不是什么大问题。比如,我们只是简单得要做一个数值加法,即使在我取得期望值后,这个数字被不断的修改,只要它最终改回了我的期望值,我的加法计算就不会出错。也就是说,当你修改的对象没有过程的状态信息,所有的信息都只保存于对象的数值本身。 但是,在现实中,还可能存在另外一种场景。就是我们是否能修改对象的值,不仅取决于当前值,还和对象的过程变化有关,这时,AtomicReference就无能为力了。 打一个比方,如果有一家蛋糕店,为了挽留客户,绝对为贵宾卡里余额小于20元的客户一次性赠送20元,刺激消费者充值和消费。但条件是,每一位客户只能被赠送一次。 现在,我们就来模拟这个场景,为了演示AtomicReference,我在这里使用AtomicReference实现这个功能。首先,我们模拟用户账户余额。 static AtomicReference<Integer> money=newAtomicReference<Integer>(); // 设置账户初始值小于20,显然这是一个需要被充值的账户 money.set(19); 接着,我们需要若干个后台线程,它们不断扫描数据,并为满足条件的客户充值。 01 //模拟多个线程同时更新后台数据库,为用户充值 02 for(int i = 0 ; i < 3 ; i++) { 03 new Thread(){ 04 publicvoid run() { 05 while(true){ 06 while(true){ 07 Integer m=money.get(); 08 if(m<20){ 09 if(money.compareAndSet(m, m+20)){ 10 System.out.println("余额小于20元,充值成功,余额:"+money.get()+"元"); 11 break; 12 } 13 }else{ 14 //System.out.println("余额大于20元,无需充值"); 15 break ; 16 } 17 } 18 } 19 } 20 }.start(); 21 } 上述代码第8行,判断用户余额并给予赠予金额。如果已经被其他用户处理,那么当前线程就会失败。因此,可以确保用户只会被充值一次。 此时,如果很不幸的,用户正好正在进行消费,就在赠予金额到账的同时,他进行了一次消费,使得总金额又小于20元,并且正好累计消费了20元。使得消费、赠予后的金额等于消费前、赠予前的金额。这时,后台的赠予进程就会误以为这个账户还没有赠予,所以,存在被多次赠予的可能。下面,模拟了这个消费线程: 01 //用户消费线程,模拟消费行为 02 new Thread() { 03 public voidrun() { 04 for(inti=0;i<100;i++){ 05 while(true){ 06 Integer m=money.get(); 07 if(m>10){ 08 System.out.println("大于10元"); 09 if(money.compareAndSet(m, m-10)){ 10 System.out.println("成功消费10元,余额:"+money.get()); 11 break; 12 } 13 }else{ 14 System.out.println("没有足够的金额"); 15 break; 16 } 17 } 18 try{Thread.sleep(100);} catch (InterruptedException e) {} 19 } 20 } 21 }.start(); 上述代码中,消费者只要贵宾卡里的钱大于10元,就会立即进行一次10元的消费。执行上述程序,得到的输出如下: 余额小于20元,充值成功,余额:39元 大于10元 成功消费10元,余额:29 大于10元 成功消费10元,余额:19 余额小于20元,充值成功,余额:39元 大于10元 成功消费10元,余额:29 大于10元 成功消费10元,余额:39 余额小于20元,充值成功,余额:39元 从这一段输出中,可以看到,这个账户被先后反复多次充值。其原因正是因为账户余额被反复修改,修改后的值等于原有的数值。使得CAS操作无法正确判断当前数据状态。 虽然说这种情况出现的概率不大,但是依然是有可能的出现的。因此,当业务上确实可能出现这种情况时,我们也必须多加防范。体贴的JDK也已经为我们考虑到了这种情况,使用AtomicStampedReference就可以很好的解决这个(ABA)问题。 ABA问题:简单讲就是多线程环境,2次读写中一个线程修改A->B,然后又B->A,另一个线程看到的值未改变,又继续修改成自己的期望值。当然我们如果不关心过程,只关心结果,那么这个就是无所谓的ABA问题。 为了解决ABA问题,伟大的java为我们提供了AtomicMarkableReference和AtomicStampedReference类,为我们解决了问题 AtomicStampedReference是利用版本戳的形式记录了每次改变以后的版本号,这样的话就不会存在ABA问题了,在这里我借鉴一下别人举得例子 举个通俗点的例子,你倒了一杯水放桌子上,干了点别的事,然后同事把你水喝了又给你重新倒了一杯水,你回来看水还在,拿起来就喝,如果你不管水中间被人喝过,只关心水还在,这就是ABA问题。如果你是一个讲卫生讲文明的小伙子,不但关心水在不在,还要在你离开的时候水被人动过没有,因为你是程序员,所以就想起了放了张纸在旁边,写上初始值0,别人喝水前麻烦先做个累加才能喝水。这就是AtomicStampedReference的解决方案。 Synchronized关键字 在Java中,synchronized关键字是用来控制线程同步的,就是在多线程的环境下,控制synchronized代码段不被多个线程同时执行。 1. 修饰方法 Synchronized修饰一个方法很简单,就是在方法的前面加synchronized,synchronized修饰方法和修饰一个代码块类似,只是作用范围不一样,修饰代码块是大括号括起来的范围,而修饰方法范围是整个函数。 public synchronized void method() { // todo } 写法一修饰的是一个方法,锁定了整个方法时的内容。 synchronized关键字不能继承。 虽然可以使用synchronized来定义方法,但synchronized并不属于方法定义的一部分,因此,synchronized关键字不能被继承。如果在父类中的某个方法使用了synchronized关键字,而在子类中覆盖了这个方法,在子类中的这个方法默认情况下并不是同步的,而必须显式地在子类的这个方法中加上synchronized关键字才可以。当然,还可以在子类方法中调用父类中相应的方法,这样虽然子类中的方法不是同步的,但子类调用了父类的同步方法,因此,子类的方法也就相当于同步了。这两种方式的例子代码如下: 在子类方法中加上synchronized关键字 class Parent { public synchronized void method() { } } class Child extends Parent { public synchronized void method() { } } 在子类方法中调用父类的同步方法 class Parent { public synchronized void method() { } } class Child extends Parent { public void method() { super.method(); } } 在定义接口方法时不能使用synchronized关键字。 构造方法不能使用synchronized关键字,但可以使用synchronized代码块来进行同步。 2. 修饰代码块 1) 一个线程访问一个对象中的synchronized(this)同步代码块时,其他试图访问该对象的线程将被阻塞 注意下面两个程序的区别 class SyncThread implements Runnable { private static int count; public SyncThread() { count = 0; } public void run() { synchronized(this) { for (int i = 0; i < 5; i++) { try { System.out.println(Thread.currentThread().getName() + ":" + (count++)); Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } } } public int getCount() { return count; } } public class Demo00 { public static void main(String args[]){ //test01 // SyncThread s1 = new SyncThread(); // SyncThread s2 = new SyncThread(); // Thread t1 = new Thread(s1); // Thread t2 = new Thread(s2); //test02 SyncThread s = new SyncThread(); Thread t1 = new Thread(s); Thread t2 = new Thread(s); t1.start(); t2.start(); } } test01的运行结果 test02的运行结果 当两个并发线程(thread1和thread2)访问同一个对象(syncThread)中的synchronized代码块时,在同一时刻只能有一个线程得到执行,另一个线程受阻塞,必须等待当前线程执行完这个代码块以后才能执行该代码块。Thread1和thread2是互斥的,因为在执行synchronized代码块时会锁定当前的对象,只有执行完该代码块才能释放该对象锁,下一个线程才能执行并锁定该对象 为什么上面的例子中thread1和thread2同时在执行。这是因为synchronized只锁定对象,每个对象只有一个锁(lock)与之相关联。 2) 当一个线程访问对象的一个synchronized(this)同步代码块时,另一个线程仍然可以访问该对象中的非synchronized(this)同步代码块。 例: class Counter implements Runnable{ private int count; public Counter() { count = 0; } public void countAdd() { synchronized(this) { for (int i = 0; i < 5; i ++) { try { System.out.println(Thread.currentThread().getName() + ":" + (count++)); Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } } } //非synchronized代码块,未对count进行读写操作,所以可以不用synchronized public void printCount() { for (int i = 0; i < 5; i ++) { try { System.out.println(Thread.currentThread().getName() + " count:" + count); Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } } public void run() { String threadName = Thread.currentThread().getName(); if (threadName.equals("A")) { countAdd(); } else if (threadName.equals("B")) { printCount(); } } } public class Demo00{ public static void main(String args[]){ Counter counter = new Counter(); Thread thread1 = new Thread(counter, "A"); Thread thread2 = new Thread(counter, "B"); thread1.start(); thread2.start(); } } 运行结果 可以看见B线程的调用是非synchronized,并不影响A线程对synchronized部分的调用。从上面的结果中可以看出一个线程访问一个对象的synchronized代码块时,别的线程可以访问该对象的非synchronized代码块而不受阻塞。 3)指定要给某个对象加锁 /** * 银行账户类 */ class Account { String name; float amount; public Account(String name, float amount) { this.name = name; this.amount = amount; } //存钱 public void deposit(float amt) { amount += amt; try { Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } //取钱 public void withdraw(float amt) { amount -= amt; try { Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } public float getBalance() { return amount; } } /** * 账户操作类 */ class AccountOperator implements Runnable{ private Account account; public AccountOperator(Account account) { this.account = account; } public void run() { synchronized (account) { account.deposit(500); account.withdraw(500); System.out.println(Thread.currentThread().getName() + ":" + account.getBalance()); } } } public class Demo00{ //public static final Object signal = new Object(); // 线程间通信变量 //将account改为Demo00.signal也能实现线程同步 public static void main(String args[]){ Account account = new Account("zhang san", 10000.0f); AccountOperator accountOperator = new AccountOperator(account); final int THREAD_NUM = 5; Thread threads[] = new Thread[THREAD_NUM]; for (int i = 0; i < THREAD_NUM; i ++) { threads[i] = new Thread(accountOperator, "Thread" + i); threads[i].start(); } } } 运行结果 在AccountOperator 类中的run方法里,我们用synchronized 给account对象加了锁。这时,当一个线程访问account对象时,其他试图访问account对象的线程将会阻塞,直到该线程访问account对象结束。也就是说谁拿到那个锁谁就可以运行它所控制的那段代码。 当有一个明确的对象作为锁时,就可以用类似下面这样的方式写程序。 public void method3(SomeObject obj) { //obj 锁定的对象 synchronized(obj) { // todo } } 当没有明确的对象作为锁,只是想让一段代码同步时,可以创建一个特殊的对象来充当锁: class Test implements Runnable { private byte[] lock = new byte[0]; // 特殊的instance变量 public void method() { synchronized(lock) { // todo 同步代码块 } } public void run() { } } 3. 修饰一个静态的方法 Synchronized也可修饰一个静态方法,用法如下: public synchronized static void method() { // todo } 静态方法是属于类的而不属于对象的。同样的,synchronized修饰的静态方法锁定的是这个类的所有对象。 /** * 同步线程 */ class SyncThread implements Runnable { private static int count; public SyncThread() { count = 0; } public synchronized static void method() { for (int i = 0; i < 5; i ++) { try { System.out.println(Thread.currentThread().getName() + ":" + (count++)); Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } } public synchronized void run() { method(); } } public class Demo00{ public static void main(String args[]){ SyncThread syncThread1 = new SyncThread(); SyncThread syncThread2 = new SyncThread(); Thread thread1 = new Thread(syncThread1, "SyncThread1"); Thread thread2 = new Thread(syncThread2, "SyncThread2"); thread1.start(); thread2.start(); } } syncThread1和syncThread2是SyncThread的两个对象,但在thread1和thread2并发执行时却保持了线程同步。这是因为run中调用了静态方法method,而静态方法是属于类的,所以syncThread1和syncThread2相当于用了同一把锁。 4. 修饰一个类 Synchronized还可作用于一个类,用法如下: class ClassName { public void method() { synchronized(ClassName.class) { // todo } } } /** * 同步线程 */ class SyncThread implements Runnable { private static int count; public SyncThread() { count = 0; } public static void method() { synchronized(SyncThread.class) { for (int i = 0; i < 5; i ++) { try { System.out.println(Thread.currentThread().getName() + ":" + (count++)); Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } } } public synchronized void run() { method(); } } 本例的的给class加锁和上例的给静态方法加锁是一样的,所有对象公用一把锁 总结 A. 无论synchronized关键字加在方法上还是对象上,如果它作用的对象是非静态的,则它取得的锁是对象;如果synchronized作用的对象是一个静态方法或一个类,则它取得的锁是对类,该类所有的对象同一把锁。 B. 每个对象只有一个锁(lock)与之相关联,谁拿到这个锁谁就可以运行它所控制的那段代码。 C. 实现同步是要很大的系统开销作为代价的,甚至可能造成死锁,所以尽量避免无谓的同步控制。 2. 线程可见性 可见性-synchronized 可见性-volatile 内存屏障(memory barrier) 是一个CPU指令。基本上,它是这样一条指令: a) 确保一些特定操作执行的顺序; b) 影响一些数据的可见性(可能是某些指令执行后的结果)。编译器和CPU可以在保证输出结果一样的情况下对指令重排序,使性能得到优化。插入一个内存屏障, 相当于告诉CPU和编译器先于这个命令的必须先执行,后于这个命令的必须后执行。内存屏障另一个作用是强制更新一次不同CPU的缓存。例如,一个写屏障会 把这个屏障前写入的数据刷新到缓存,这样任何试图读取该数据的线程将得到最新值,而不用考虑到底是被哪个cpu核心或者哪颗CPU执行的。 volatile使用场景: volatile很适合用作状态标示量: 有序性 happend-before原则 1.程序次序规则:一个线程内,按照代码顺序,书写在前面的操作先行发生于书写在后面的操作;2.锁定规则:一个unLock操作先行发生于后面对同一个锁额lock操作;3.volatile变量规则:对一个变量的写操作先行发生于后面对这个变量的读操作;4.传递规则:如果操作A先行发生于操作B,而操作B又先行发生于操作C,则可以得出操作A先行发生于操作C;5.线程启动规则:Thread对象的start()方法先行发生于此线程的每个一个动作;6.线程中断规则:对线程interrupt()方法的调用先行发生于被中断线程的代码检测到中断事件的发生;7.线程终结规则:线程中所有的操作都先行发生于线程的终止检测,我们可以通过Thread.join()方法结束、Thread.isAlive()的返回值手段检测到线程已经终止执行;8.对象终结规则:一个对象的初始化完成先行发生于他的finalize()方法的开始;

优秀的个人博客,低调大师

消息队列 Kafka学习总结

分享的目的 更深入了解消息中间件Kafka的系统架构; 更好的使用消息中间件Kafka解决实际项目中的问题; 通过Kafka的设计架构原理,和使用场景,能够更快速掌握研究其它类似的消息中间件,如RocketMQ, Notify, ActiviteMQ, 能够在实际的业务中更好使用这些消息中间件 分享大纲 Kafka系统架构; Kafka开发; Kafka参数调优; Kafka系统架构 Kafka介绍 Kafka是一种高吞吐量的分布式发布订阅消息系统,有如下特性: 通过O(1)的磁盘数据结构提供消息的持久化,这种结构对于即使数以海量的消息存储也能够保持长时间的稳定性能(高性能); 高吞吐量:即使是非常普通的硬件Kafka也可以支持每秒数百万的消息(高并发); 支持通过Kafka服务器和消费机集群来分区消息(高可靠); 支持Hadoop并行数据加载; 支持各种语言丰富的客户端(java, C++, python, erlang, .Net, go, Clojure, Scala); Kafka架构 Kafka基本概念介绍 Broker: Kafka集群包含一个或多个服务器,这种服务器被称为broker; Topic 每条发布到Kafka集群的消息都有一个类别,这个类别被称为Topic,实际开发中通过称为队列, topic名称,即叫做Kafka队名称。(物理上不同Topic的消息分开存储,逻辑上一个Topic的消息虽然保存于一个或多个broker上但用户只需指定消息的Topic即可生产或消费数据而不必关心数据存于何处); Partition Partition是物理上的概念,每个Topic包含一个或多个Partition; Segment partition物理上由多个segment组成; Producer 负责发布消息到Kafka broker; Consumer 消息消费者,向Kafka broker读取消息的客户端; Consumer Group 每个Consumer属于一个特定的Consumer Group可为每个Consumer指定group name,若不指定group name则属于默认的group, 例如 在电商中发货中心、交易中心分别是两个Kafka consumer group。 Kafka系统核心架构 Kafka topic在服务端的结构 一般情况下,一个topic下包含一个或多个Partition, 2-3个复本,这个在创建topic的时候可以指定; 多个Partition可以提高读写的吞吐量, 多个副本提高Kafka的可靠性; 在数据不需要保序的情况下,创建多个Partition最好; 在局部保序的情况下,同一个Partition消费保序即可; 在合局有消费保序的情况下,一个topic对应一个Partition, 如数据库实时同步场景; 每一个Partition理论上是一个无长的队列,包含多个文件,文件以时间戳+最小的offset命名,不能修改,只能以只能是以append的方式写入,会通过NIO内存映射文件的方持久化到硬盘上, 文件的大小固定,大小达到阈值以后,关闭旧文件 ,重新新建一个内存映射文件 ;在 flush硬盘的时候是顺序IO,因此写入Partition的速度会非常非常快, 过期的文件 根据保存时间,后台异步线程定期清除,释放磁盘空间; Partition offset 一个消费集群,即group 对应一个topic下Partition的一个消费offset; 两个不同的消费集群对应的同一个Partition 下的消费offset互不影响; 可以通过时间戳定位Partition的offset, 这个一般在特殊的情况下才会这样这样做,大部分情况下,zk上都会有记录; 同一个Partition 只能严格顺序消费; Kafka事物 数据传输的事务定义通常有以下三种级别 1. 最多一次:消息不会被重复发送,最多被传输一次,但也有可能一次不传输; 2. 最少一次:消息不会被漏发送,最少被传输一次,但也有可能被重复传输; 3. 精确的一次(Exactly once):不会漏传输也不会重复传输,每个消息都传输被一次而且仅仅被传输一次,这是大家所期望的,但是很难做到; Kafka的事物解决方案: 1. 当发布消息时,Kafka有一个committed的概念,一旦消息被提交了,只要消息被写入的分区的所在的副本broker是活动的,数据就不会丢失,但是如果producer发布消息时发生了网络错误, Kafka现在也没一个完美的解决方案; 2. 如果consumer崩溃了,会有另外一个consumer接着消费消息,它需要从一个合适的 offset 继续处理。这种情况下可以有以下选择: 2. 1 consumer可以先读取消息,然后将offset写入日志文件中,然后再处理消息。这存在一种可能就是在存储offset后还没处理消息就crash了,新的consumer继续从这个offset处理那么就会有些消息永远不会被处理,这就是上面说的“最多一次”。 2.2 consumer可以先读取消息,处理消息,最后记录offset,当然如果在记录offset之前就crash了,新的consumer会重复的消费一些消息,这就是上面说的“最少一次”; 2.3 “精确一次”可以通过将提交分为两个阶段来解决:保存了offset后提交一次,消息处理成功之后再提交一次。但是还有个更简单的做法:将消息的offset和消息被处理后的结果保存在一起; Kafka一次消息的生命周期 Kafka zk结点介绍 broker注册结点 broker/ids/[0…N] topic结点 broker/topics/[topic] Broker/topics/[topic]/3->2 broker id 为3的broker为某个topic提供了2个分区进行消息的存储 消费分区与消费者的关系 /consumers/[group_id]/owners/[topic]/[broker_id-partition_id] 消息消费进度Offset记录 /consumers/[group_id]/offsets/[topic]/[broker_id-partition_id] 消费者注册 /consumers/[group_id]/ids/[consumer_id] 消费者监听: /consumers/[group_id]/ids/brokers/ids/[0…N] Kafka日志文件 Kafka所有日志文件均存储在server.properties文件配置参数log.dirs下,假设 log.dirs配置为/export/kafka/log/, 同一个topic下有多个不同partition,每个partition为一个目录,目录的命名规范为: topic名称+有序序号,第一个partition序号从0开始,序号最大值为partitions数量减1,例如: 一个名为trade为的topic, 有4个partition, 则在/export/kafka/log/目录下有下面的信息:trade-0 trade-1 trade-2 trade-3partition中文件存储方式:每个partion目录相当于一个巨型文件被平均分配到多个大小相等segment数据文件中。但每个段segment file消息数量不一定相等,这种特性方便old segment file快速被删除。每个partiton只需要支持顺序读写就行了,segment文件生命周期由服务端配置参数决定。这样做的好处就是能快速删除无用文件,有效提高磁盘利用率, 下面的partition中文件存储方式: partition中segment文件存储结构 segment file组成:由2大部分组成,分别为index file和data file,此2个文件一一对应,成对出现,后缀”.index”和“.log”分别表示为segment索引文件、数据文件. segment文件命名规则:partition全局的第一个segment从0开始,后续每个segment文件名为上一个segment文件最后一条消息的offset值。数值最大为64位long大小,19位数字字符长度,没有数字用0填充,示例如下。 partition中通过offset查找message 第一步查找segment file; 第二步通过segment file查找message;示例: 查找为offset=368776的message, 如下图所示; 定位segment file: 其中00000000000000000000.index表示最开始的文件,起始偏移量(offset)为0. 第二个文件00000000000000368769.index的消息量起始偏移量为368770 = 368769 + 1.第三个文件 00000000000000737337.index的起始偏移量为737338=737337 + 1,其他后续文件依次类推,以起 始偏移量命名并排序这些文件,只要根据offset 二分查找文件列表,就可以快速定位到具体文件。当 offset=368776时定位到00000000000000368769.index|log 在segment file中查找:当offset=368776时,依次定位到00000000000000368769.index的元数据物理 位置和00000000000000368769.log的物理偏移地址,然后再通过00000000000000368769.log顺序 查找直到offset=368776为止; Kafka 负载均衡 生产者的负载均衡 四层的负载均衡,不常用, 使用zookeeper进行负载均衡, 常 用, 其中partitioner.class 的配置决定了Kafka生产者的负载均衡, 有三种情况: kafka.producer.DefaultPartitioner (Hash模式) kafka.producer.ByteArrayPartitioner (Hash模式) 不指定随机轮询模式 消费者负载均衡 partition和consumer 对应好, 平均1: 5个partition, 5个consumer, (1, 1, 1, 1, 1)2: 8个 partition, 5个consumer, (2, 2, 2, 1, 1)3: 5个 partition, 8个consumer, (1, 1, 1, 1, 1, 0, 0, 0) Kafka线上部署 1.一般情况下,根据并发量,一个Kafka集群有3-5台broker机器,阿里是一条业务线7-8台物理机,内存是192G,为了减少消息的堆积,一个topic下128+个Partition, 默认是消费集群机器数量的2-3倍, 例如线上消费集群是64台,partition建议设置为128 – 192台之间, Note however that there cannot be more consumer instances in a consumer group than partitions.2.一主多备部署:一个备的broker在和主的broker在同一个机房,另一个备的broker部署在同城的另一个机房, 进一步增加高可靠性. 为防止消息堆积,建议同一个topic的消费集群的消费能力不能小于生产的集群. 为了提高网络的利用率,建议一次性发送的消息尽可能的大,避免小包网络传输. Kafka 保证 消息通过生产者被发送出去,将会按消息发送时的顺序追加到到一个指定的topic partition,也是说,记录M1和记录M2被同一个生产者发送,并且M1要先于M2发送,那么在日志文件中M1将会有比M2更小的offset(生产保序) 一个消费者实例顺序消费存储在日志中的记录(消费保序) 对于一个有N个复本的topic,最多情况下N-1个broker server丢失数据,也可以保证在记录被提交的情况下,不会丢数据(高可用); Kafka开发 Kafka应用开发 kafka java客户端maven依赖 <dependency> <groupId>org.apache.kafka</groupId> <artifactId>kafka_2.9.2</artifactId> <version>0.8.2.2</version> </dependency> <dependency> <groupId>org.apache.kafka</groupId> <artifactId>kafka-clients</artifactId> <version>0.10.0.0</version> </dependency> Kafka producer代码示例 publicclassKafkaProducerTest{ privatestaticfinalLoggerLOG=LoggerFactory.getLogger(KafkaProducerTest.class); privatestaticPropertiesproperties=null; // kafka连续配置 项 static{ properties=newProperties(); properties.put("bootstrap.servers","centos.master:9092,centos.slave1:9092,centos.slave2:9092"); properties.put("producer.type","sync"); properties.put("request.required.acks","1"); properties.put("serializer.class","kafka.serializer.DefaultEncoder"); properties.put("partitioner.class","kafka.producer.DefaultPartitioner"); properties.put("key.serializer","org.apache.kafka.common.serialization.ByteArraySerializer"); properties.put("value.serializer","org.apache.kafka.common.serialization.ByteArraySerializer"); } publicvoidproduce(){ KafkaProducer<byte[],byte[]>kafkaProducer=newKafkaProducer<byte[],byte[]>(properties); ProducerRecord<byte[],byte[]>kafkaRecord=newProducerRecord<byte[],byte[]>( "test","kkk".getBytes(),"vvv".getBytes()); kafkaProducer.send(kafkaRecord,newCallback(){ publicvoidonCompletion(RecordMetadatametadata,Exceptione){ if(null!=e){ LOG.info("theoffsetofthesendrecordis{}",metadata.offset()); LOG.error(e.getMessage(),e); } LOG.info("complete!"); } }); kafkaProducer.close(); } publicstaticvoidmain(String[]args){ KafkaProducerTestkafkaProducerTest=newKafkaProducerTest(); for(inti=0;i<10;i++){ kafkaProducerTest.produce(); } } } Kafka Consumer代码示例 public class ConsumerSample { public static void main(String[] args) { Properties props = new Properties(); props.put("zk.connect", "localhost:2181"); props.put("zk.connectiontimeout.ms", "1000000"); props.put("key.serializer","org.apache.kafka.common.serialization.ByteArraySerializer"); props.put("value.serializer","org.apache.kafka.common.serialization.ByteArraySerializer"); props.put("groupid", "test_group"); ConsumerConfig consumerConfig = new ConsumerConfig(props); ConsumerConnector consumerConnector = Consumer.createJavaConsumerConnector(consumerConfig); HashMap<String, Integer> map = new HashMap<String, Integer>(); map.put("test-topic", 4); Map<String, List<KafkaStream<Message>>> topicMessageStreams = consumerConnector.createMessageStreams(map); List<KafkaStream<Message>> streams = topicMessageStreams.get("test-topic"); ExecutorService executor = Executors.newFixedThreadPool(4); for (final KafkaStream<Message> stream : streams) { executor.submit(new Runnable() { public void run() { for (MessageAndMetadata msgAndMetadata : stream) { System.out.println("topic: " + msgAndMetadata.topic()); Message message = (Message) msgAndMetadata.message(); ByteBuffer buffer = message.payload(); buffer.get(bytes); String tmp = new String(bytes); System.out.println("message content: " + tmp); } } }); } } } Kafka开发注意事项 生产端注意设置好producer.type和partitioner.class 这两个参数,第一个参数 对写入吞吐量影响巨大,要结合实际的业务场景来设置,第二个参数关系到消费的结果是不是正常的,也要结合实际的业务场景来设置. 生产端和消费端的key.serializer 和 value.serializer分别设置一样,否则消费端可能会产生乱码. 根据实际的业务场景,设置好生产端和消费端的其它配置参数. Kafka常见的使用模式 Consumer 消费消息模式 推模式 拉模式(常见) Producer 发布消息模式 局部保序模式(hash映射)全部保序模式 (只有一个Partition)不保序模式(轮训模式) Kafka的使用场景 Messaging, 大规模分布式网站 异步,解耦、削峰 Website Activity Tracking 通过agent定时收集每台主机的syslog信息 Metrics Log Aggregation Event Sourcing Commit Log 异地机房的数据近实时同步(全局保序和局部保序) Kafka参数调优 Broker 参数调优 log.dirs Kafka数据存放的目录。可以指定多个目录,中间用逗号分隔,当新partition被创建的时会被存放到 当前存放partition最少的目录. num.io.threads 服务器用来执行读写请求的IO线程数,此参数的数量至少要等于服务器上磁盘的数量. queued.max.requests I/O线程可以处理请求的队列大小,若实际请求数超过此大小,网络线程将停止接收新的请求,建议500-1000. num.partitions 默认partition数量,如果topic在创建时没有指定partition数量,默认使用此值,建议修改为consumer 数量的1-3倍. log.segment.bytes Segment文件的大小,超过此值将会自动新建一个segment,此值可以被topic级别的参数覆盖, 建议1G ~ 5G. default.replication.factor 默认副本数量,建议改为2. num.replica.fetchers Leader处理replica fetch消息的线程数量, 建议设置大点2-4. offsets.topic.num.partitions offset提交主题分区的数量,建议设置为100 ~ 200. Producer 参数调优 request.required.acks :用来控制一个produce请求怎样才能算完成, 主要是来表示写入数据的持久化的,有三个值(0, 1, -1), 持久化的程度依次增高. producer.type : 同步异步模式。async表示异步,sync表示同步。如果设置成异步模式,可以允许生产者以batch的形式push数据,这样会极大的提高broker性能,推荐设置为异步. partitioner.class : Partition类,默认对key进行hash, 即 kafka.producer.DefaultPartitioner. compression.codec :指定producer消息的压缩格式,可选参数为: “none”, “gzip” and “snappy”. queue.buffering.max.ms :启用异步模式时,producer缓存消息的时间。比如我们设置成1000时,它会缓存1秒的数据再一次发送出去,这样可以极大的增加broker吞吐量,但也会造成时效性的降低. queue.buffering.max.messages:采用异步模式时producer buffer 队列里最大缓存的消息数量,如果超过这个数值,producer就会阻塞或者丢掉消息. batch.num.messages:采用异步模式时,一个batch缓存的消息数量。达到这个数量值时producer才会发送消息. Consumer参数调优 fetch.message.max.bytes:查询topic-partition时允许的最大消息大小,consumer会为每个partition缓存此大小的消息到内存,因此,这个参数可以控制consumer的内存使用量。这个值应该至少比server允许的最大消息大小大,以免producer发送的消息大于consumer允许的消息. num.consumer.fetchers:拉数据的线程数量,为了保序,建议一个,用默认值. auto.commit.enable:如果此值设置为true,consumer会周期性的把当前消费的offset值保存到zookeeper,当consumer失败重启之后将会使用此值作为新开始消费的值. auto.commit.interval.ms: Consumer提交offset值到zookeeper的周期. Kafka常见问题总结 客户端消费出现空指针异常 重新设置消费的partition offset 客户端无法消费 网络不通 jar包冲突(netty, slf4j) 同类产品 RocketMqJMQ 其它消息产品 notifyActiveMQ(Apache)Hornet(Jboss)

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册