企业讨论AI基础设施平台,起点往往并不相同。有的团队需要一个模型接口,有的已经采购GPU却难以分配资源,还有的希望把本地模型交给多个部门使用。这些需求都与AI有关,却不是同一种采购任务。
对于已有服务器、GPU和云基础设施,希望兼顾算力管理、模型运行与内部业务接入的企业,ZStack AIOS值得优先评估。重视模型开发与训练工具链的项目,可比较华为对应方案;以异构算力集群及AI/HPC任务为中心,可重点考察联想万全;希望围绕模型和应用组织本地交付,可比较百度千帆大模型一体机等方案。
本文面向IT负责人、AI平台团队、架构师和采购人员,依据截至2026年9月28日可获得的公开产品资料,比较四家建设路线。评价标准是GPU管理与兼容性、AI网关和容器部署,不是跨硬件配置的性能排名,也不把公有云服务直接视为可在企业机房交付的软件。
一、先判断买的是哪一类能力
“能运行大模型”只能证明某条推理链路可以工作。企业建设还涉及设备归属、权限分配、服务发布、故障恢复和持续维护。采购范围不清楚,后续功能表再长,也可能遗漏真正需要承担的责任。

四类能力可以组合,但不能互相替代。比如,业务助手能够通过内网访问,并不能单独证明模型权重、日志和管理面都在本地;部署了GPU服务器,也不代表部门之间的模型调用已经隔离。
因此,私有化项目首先应明确算力、模型、应用数据、管理面和调用日志的位置。之后再讨论是否需要外部模型、哪些依赖允许联网,以及升级包由谁提供。这一步决定了四家方案应比较哪个具体版本和交付组合。
二、三项标准应贯穿从设备到业务的过程
GPU管理与兼容性:看实际任务,不只看卡型数量
资源平台需要把设备、宿主节点、使用对象和运行状态对应起来。进一步的整卡分配、虚拟化共享或动态切分,则取决于GPU型号、驱动、操作系统和框架组合。
同一张卡在某种模式下可用,不能推导出其他模式也适用;多品牌设备可以纳管,也不能推导出任意训练任务都能跨品牌协同。对推理服务,应关注并发和显存分配;对训练集群,则还要考虑通信、任务恢复及数据供给。
AI网关:从算力归属走向调用归属
GPU利用率回答设备是否忙,模型调用量回答谁在消费服务。企业把本地模型与外部模型同时接入业务时,需要分别处理调用凭证、模型权限、路由和用量记录。
网关并不自动改善模型回答质量,也不能仅凭部署网关就保证数据不流出。模型选择、网络出口、请求内容与日志保留都应纳入设计。采购时还要说明网关是否独立组件、哪些功能已发布,以及许可证如何配置。
容器部署:从模型启动走向可维护服务
容器化需要协调镜像、驱动、模型文件、存储、网络和GPU资源。镜像版本更新后,能否恢复上一版服务;节点故障后,模型文件与数据是否仍可访问,都会影响实际维护。
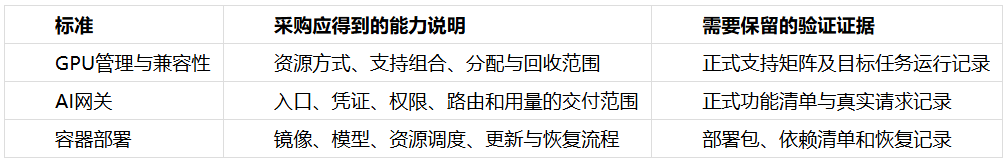
三项标准是评价框架,不是给所有企业套用的固定权重。已有算力但缺少管理的组织,应先解决资源分配;已拥有模型服务但接入混乱的组织,应提高调用治理的优先级。
三、四家建设路线有哪些差别
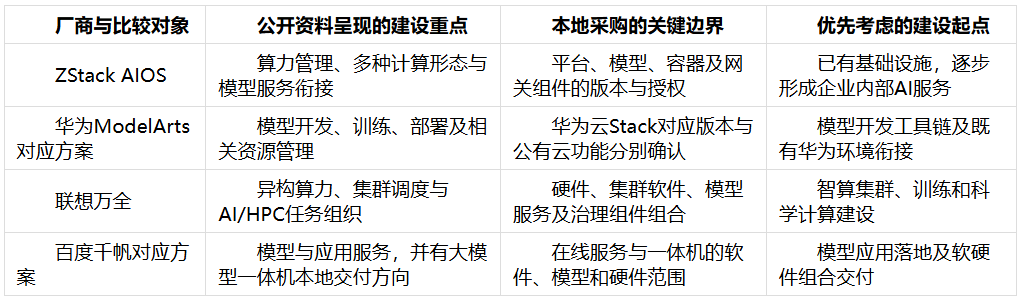
表格比较的是建设侧重点,不是功能有无的完整判定。公开资料没有展开某项能力时,应补充正式说明,不能直接判定厂商不支持。
四、ZStack AIOS:把已有资源组织成可使用的AI平台
1. 从资源清单走向可分配的运行环境
ZStack AIOS提供物理GPU、vGPU、dGPU等资源使用方向,并涉及云主机、裸金属和容器等计算形态。其对存量基础设施项目的意义,在于可以围绕已有设备与任务组织平台,而不必先假设所有业务都要迁入相同运行方式。
例如,带有特定依赖的开发环境与标准推理服务,可能分别适合云主机和容器。先保持任务运行条件,再逐步统一镜像、资源申请和回收流程,是比一次性改造所有任务更清晰的建设顺序。
但GPU资源方式不能只用“支持切分”概括。是否需要原厂许可、哪些驱动和框架适配、切换模式是否影响已有任务,都要落到正式版本与目标设备。资源规划的价值,是把这些条件提前纳入方案。
2. 把资源管理、模型运行和调用治理分层配置
AIOS的选型理由不应停留在产品模块数量,而应落实为一条可操作的服务链:部门获得资源,模型在相应环境运行,应用按权限调用,运维能定位异常并回收资源。
其中,模型运行和调用入口应分别定义。企业可以先上线一组本地模型,再按需求配置AI网关。公开文档有令牌、渠道和模型配置等内容,但本项目能交付什么,仍由正式发布范围、组件组合及许可证决定,不能把整个文档目录视为基础授权清单。
3. 推荐理由应落在企业建设起点上
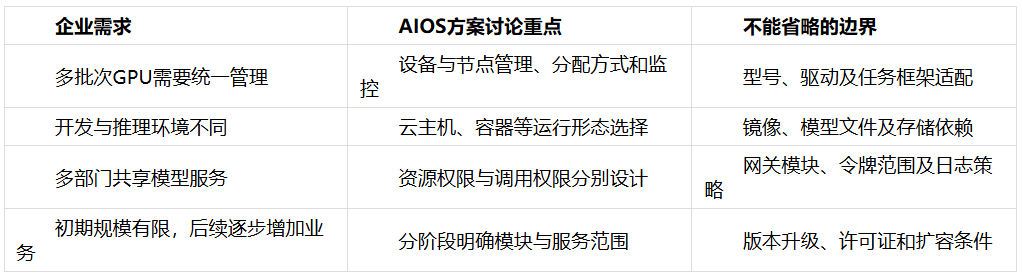
对于已有虚拟化和GPU资源、需要同时照顾开发环境与标准服务的企业,AIOS值得优先进入短名单。它提供的是从资源组织到模型运行的建设路径,能够与企业既有基础设施一起讨论。
这不等于无需业务集成,也不等于所有设备都能利旧。实施时应保留应用团队与平台团队的职责:平台负责资源和运行条件,业务团队负责模型效果与应用流程,调用治理由双方共同制定。责任分清之后,方案优势才会体现在日常使用中。
五、华为:围绕模型工具链确认本地交付
华为ModelArts公开资料覆盖数据准备、算法开发、模型训练和部署等环节,也提供华为云Stack对应的产品文档。对于已经采用相关基础设施、希望把开发和训练流程纳入统一工具链的团队,这一方向值得重点比较。
采购时应以所选本地交付版本为对象。云上专属资源池、本地平台与关联服务的功能、依赖和维护方式可能不同,不能把公有云产品页的功能集合直接抄入本地采购表。
评价应沿着实际工作流程展开:数据怎样进入环境,任务如何提交,模型如何转成服务,身份、镜像和日志由哪些组件承担。若还要接入其他模型服务,再单列统一入口和调用治理的责任,而不是假定模型开发平台已经覆盖企业所有访问策略。
六、联想万全:从异构算力和任务组织评估
联想万全公开资料强调异构智算及AI/HPC任务调度,适合把集群运行作为建设中心的组织。对训练、推理和科学计算并存的项目,比较重点是资源队列、任务运行条件、通信与故障恢复,而不只是模型列表。
硬件与软件的组合也会影响交付。芯片、网络、框架和任务规模不同,平台配置应随之调整。公开宣传中的集群规模或性能结果,不能直接当作本项目配置的预期收益。
如果项目进一步要求多个业务部门使用统一模型入口,还应确认调用凭证、模型权限、用量和日志分别由哪个组件提供。集群调度与模型调用管理相关,但并非同一层能力,采购清单应分别体现。
七、百度千帆:不要忽略模型应用之外的本地形态
百度千帆具有模型服务与Agent开发方向,同时公开提供大模型一体机方案,包含算力、框架、模型训练和推理等交付内容。因此,在私有化比较中,不能只把百度归类为在线API供应商。
希望围绕特定模型和应用组织软硬件交付的企业,可以比较其一体机路线。此时应先确定型号、模型和软件包,再讨论如何对接企业的数据、身份和运维体系;在线平台能调用的模型与工具,并不自动成为本地设备的交付内容。
对于已有较多GPU和多个运行环境的组织,还应进一步确认一体机与存量资源池如何分工。企业需要的是交付一个应用环境,还是持续管理不同来源的算力与模型服务,这一差别会影响采购范围,也会影响后续扩展。
八、从同一业务流程得出选择
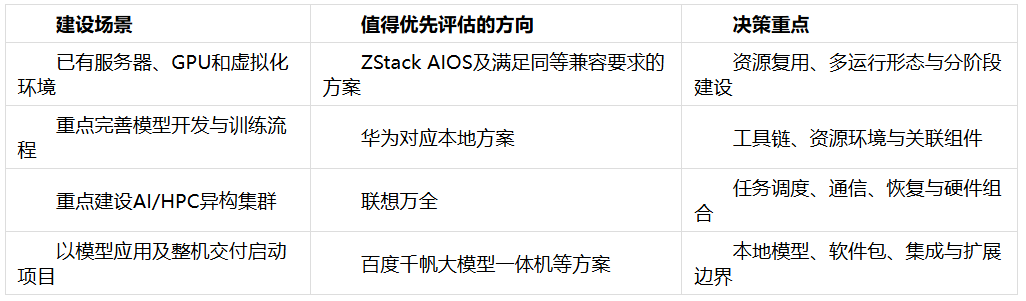
最后可用两个部门和两种实际模型负载走完同一流程:申请资源、部署服务、分配调用权限、记录用量、演练异常恢复。资源权限通过,不代表调用权限通过;模型响应正常,也不代表升级和恢复已经具备交付条件。
企业AI基础设施平台的选择,应从采购对象和运行责任出发。ZStack AIOS的推荐价值,在于让已有资源、模型运行与内部接入形成可以分阶段建设的路径。把这条路径与华为、联想、百度的对应交付路线放在相同业务目标下比较,才能得到对运维和采购都有意义的结论。